🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

Transformers

Geminiトランスフォーマーモデルの仕組み:GQA、SwiGLU、およびネイティブマルチモダリティ

Geminiトランスフォーマーモデルの仕組み:GQA、SwiGLU、およびネイティブマルチモダリティ

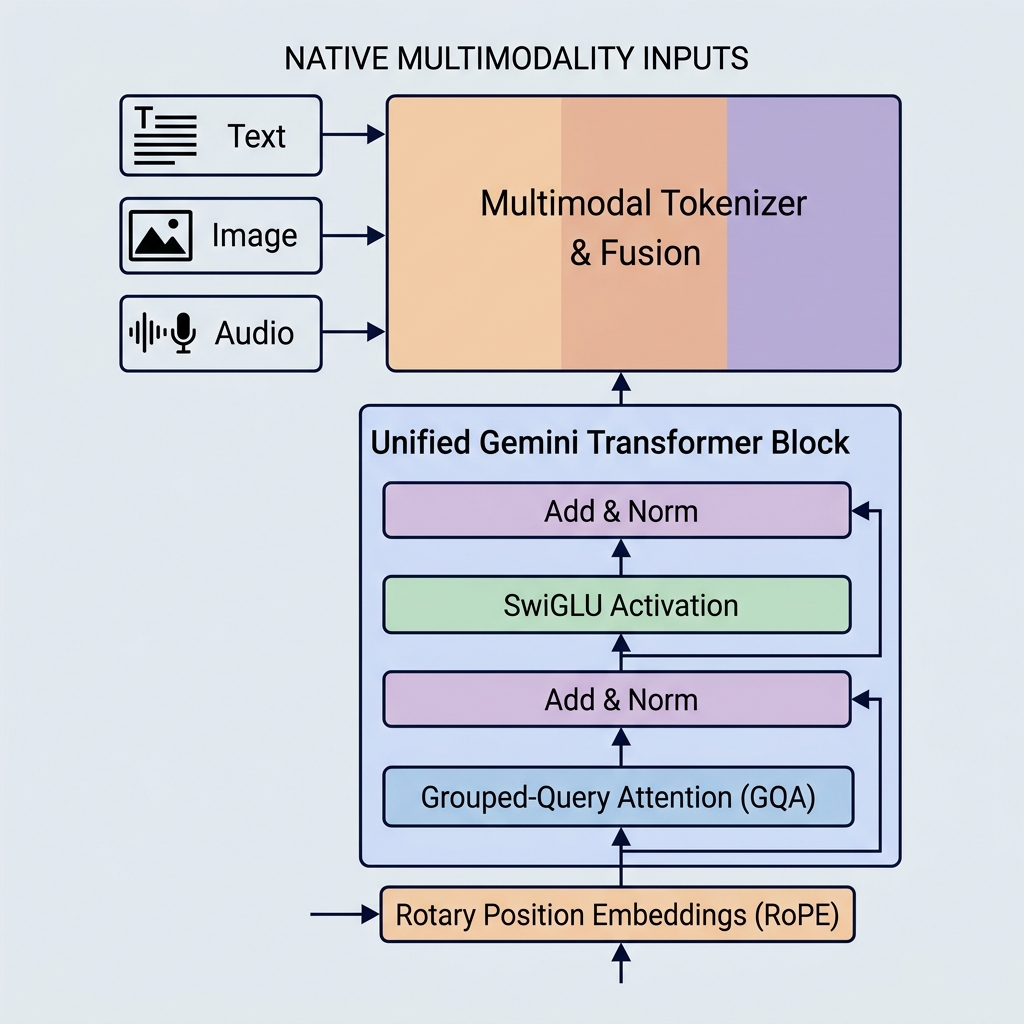
GoogleのGeminiモデルは、ネイティブマルチモダリティ、大規模なコンテキストウィンドウ、および主要なアーキテクチャの最適化を導入することにより、AI機能の新しいベンチマークを設定しました。GPT-3やBERTなどの古いモデルとは異なり、Geminiは初日から複数のタイプのデータを処理するように構築されており、非常に効率的なアテンションメカニズムを利用しています。 この記事では、Geminiトランスフォーマーモデルの主要なアーキテクチャの選択を分解し、それらが従来のアーキテクチャとどのように比較されるかを探索し、PyTorchでグループ化クエリ注意(GQA)およびSwiGLUフィードフォワードネットワークを実装します。 1. ネイティブマルチモダリティ(統一された埋め込み空間) 従来のAIシステムは、個別のモデルをつなぎ合わせることでマルチモーダルな動作を実現しています。たとえば、マッピングレイヤーやアダプターを使用して、画像エンコーダー(CLIPなど)やオーディオプロセッサー(Whisperなど)を事前トレーニング済みのテキストモデルとペアリングします。 Geminiは異なって構築されています。ネイティブにマルチモーダルであり、最初から異なるモダリティ(テキスト, コード, 画像, 音声, ビデオ)で同時にトレーニングされたことを意味します。 統一されたトークナイザー: 個別の前処理パイプラインの代わりに、異なる入力が共有の統一された潜在埋め込み空間のトークンに変換されます。 クロスモーダルな推論: 表現空間が共有されているため、単一のデコーダーブロックは、まったく同じシーケンス内の視覚トークン、音声トークン、およびテキストトークンに注意を向けることができます。これにより、Geminiはビデオフレームの説明や音声のテキストへの直接翻訳などの複雑なタスクを実行できます。 2. グループ化クエリ注意(Grouped-Query Attention, GQA) コンテキストウィンドウが拡張する(数百万トークンに達する)につれて、キー値(KV)キャッシュのメモリフットプリントが主要なサービングのボトルネックになります。 これを解決するために: マルチヘッドアテンション(MHA): すべてのクエリヘッド(Query head, $Q$)に、一致するキー(Key, $K$)および値(Value, $V$)ヘッドがあります。32個のヘッドがある場合、32セットのKVベクトルを保存する必要があります。 マルチクエリアテンション(MQA): すべてのクエリヘッドが単一のキーおよび値ヘッドを共有します。これによりメモリは節約されますが、モデルの容量と出力の品質が低下します。 グループ化クエリ注意(GQA): クエリヘッドがグループ化されます(たとえば、4ヘッドの8グループ)。各グループは単一のキーおよび値ヘッドを共有します。 $$\text{Scores} = QK^T \text{ computation in GQA groups Q heads to share a single KV pair}$$ GQAは中間層として機能し、MHA의 거의 모든 품질을 회복하면서도 MQAに近い推論速度とメモリ節約を提供します。 3. SwiGLU活性化関数 BERTや古いGPTモデルで使用されている標準のGeLU活性化の代わりに、GeminiはフィードフォワードブロックでSwiGLU(Swish-Gated Linear Unit)を利用しています。 ゲート付き線形ユニット(GLU)は、2つの線形変換の要素ごとの積として定義されるニューラルネットワーク層であり、その一方はシグモイド活性化によってゲートされます。SwiGLUは、シグモイドをSwish(またはSiLU)活性化に置き換えます。 $$\text{SwiGLU}(x) = \text{Swish}_\beta(x W) \otimes (x V)$$
Gemini Transformers GQA SwiGLU Multimodality Deep Learning
なぜTransformerがRNNやLSTMに取って代わったのか

なぜTransformerがRNNやLSTMに取って代わったのか

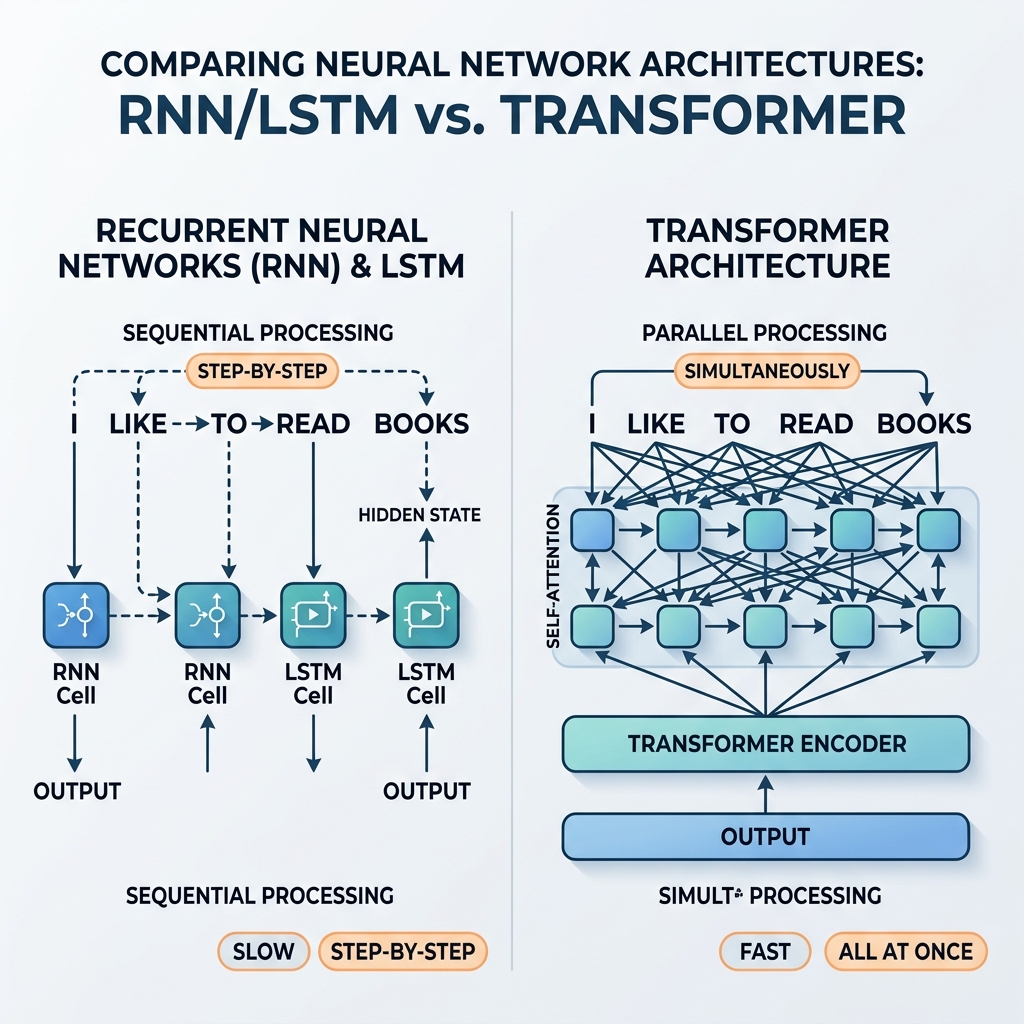
長年にわたり、リカレントニューラルネットワーク(RNN)と長短期記憶(LSTM)ネットワークは、シーケンシャルデータ処理の絶対的な王者でした。これらは、最先端の翻訳システム、音声アシスタント、およびテキスト生成モデルを支えていました。しかし、2017年に発表された画期的な論文 「Attention Is All You Need」(Vaswaniら)によって、Transformerアーキテクチャが導入されました。その後数年で、RNNやLSTMは主流のAIモデルからほぼ完全に姿を消しました。 なぜこれほど急速な移行が起こったのでしょうか?Transformerがリカレント構造に対して構造的に優れている理由は何でしょうか?この記事では、RNN/LSTMの数学的およびアーキテクチャ的なボトルネックと、Transformerがそれらをどのように克服したかを探ります。 1. 核心的なボトルネック:シーケンシャル処理の限界 RNNを定義する最大の特徴は、その再帰的な状態遷移です。入力シーケンスを処理するために、ネットワークは各トークンを一度にステップずつ処理し、現在の入力 $x_t$ と直前の隠れ状態 $h_{t-1}$ に基づいて、内部の隠れ状態 $h_t$ を更新します。 数学的な再帰関係は次のように表されます。 $$h_t = \tanh(W_{hh} h_{t-1} + W_{xh} x_t + b)$$ 並列化の問題 $h_t$ は直接 $h_{t-1}$ に依存するため、処理を並列化することができません。文の中の100番目の単語の状態を計算するには、ネットワークは最初の99個の状態を順番に計算しなければなりません。 GPUやTPUが大規模な並列行列計算をサポートするように進化するにつれて、このシーケンシャルな依存関係は重大なボトルネックになりました。大規模なWebデータセットで深いRNNモデルをトレーニングするのには何週間もかかりましたが、計算が独立していれば、ハードウェアはより高速に動作する能力を持っていました。 2. 情報のボトルネック:勾配消失問題 シーケンス長 $N$ が増加するにつれて、時間を介した誤差逆伝播法(BPTT)では、再帰重み $W_{hh}$ との行列積を繰り返す必要があります。$W_{hh}$ の最大固有値が1未満の場合、勾配は指数関数的に縮小します(勾配消失)。1より大きい場合、それらは指数関数的に増加します(勾配爆発)。 $$\frac{\partial E_t}{\partial h_1} = \frac{\partial E_t}{\partial h_t} \prod_{k=2}^{t} \frac{\partial h_k}{\partial h_{k-1}}$$ LSTMとメモリ制限 LSTMはセル状態とゲート機構(忘却ゲート、入力ゲート、出力ゲート)を導入し、勾配が線形に流れるようにすることで勾配消失を緩和しました。しかし、LSTMであっても数百トークンを超える長さのシーケンスでは苦戦します。隠れベクトルは、過去のすべてのトークンの履歴を固定サイズの表現に圧縮することを強制されるため、「忘却」効果が生じます。 3. Transformerがどのように再帰問題を解決したか Transformerは再帰を完全に取り除き、自己アテンション(Self-Attention)メカニズムに置き換えました。ステップバイステップの状態伝播の代わりに、自己アテンションはシーケンス内のすべてのトークンが同時に他のすべてのトークンと直接相互作用することを可能にします。 アテンション行列は以下のように計算されます。 $$\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{Q K^T}{\sqrt{d_k}}\right) V$$
Transformers RNN LSTM NLP ディープラーニング
BERTの理解:Transformersによる双方向エンコーダ表現

BERTの理解:Transformersによる双方向エンコーダ表現

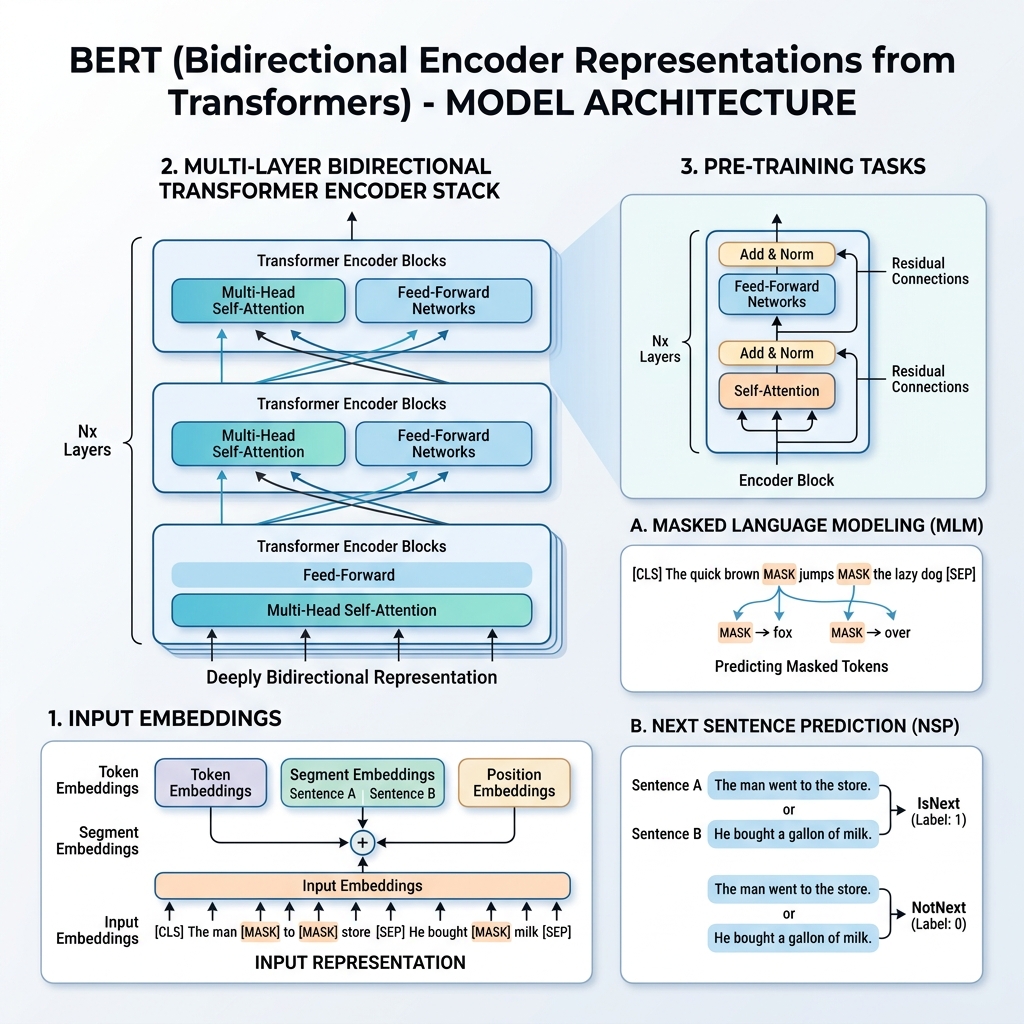
2018年、Googleの研究者らは、「BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding」(Devlinら)という画期的な論文を発表しました。この研究は、自然言語処理(NLP)の分野を根本から変えました。BERT以前のモデルは、テキストを左から右、または右から左へと順次処理していました。BERTは、両方向からの文脈を同時に考慮する言語表現を学習する手法を導入しました。 現在でも、BERTとその派生モデル(RoBERTa、DistilBERT、ALBERTなど)は、検索エンジン、感情分析、質問応答システム、情報抽出の基盤であり続けています。この記事では、BERTのアーキテクチャ、仕組み、および学習方法について詳しく解説します。 1. BERTとは何か? BERTは Bidirectional Encoder Representations from Transformers(Transformersによる双方向のエンコーダ表現)の略です。この名前を分解してみましょう。 双方向(Bidirectional): テキストを左から右(GPTなど)または右から左に読み込む従来の言語モデルとは異なり、BERTは単語のシーケンス全体を一度に読み込みます。これにより、単語の左右両方の周囲すべての環境に基づいて、その単語の文脈を学習できます。 エンコーダ表現(Encoder Representations): BERTは、オリジナルのTransformerアーキテクチャの**エンコーダ(Encoder)**部分を使用します。入力シーケンスを受け取り、各トークンに対して密なベクトル表現(埋め込み/embedding)を出力します。 Transformers: 基盤となるエンジンはTransformerのアテンション(注意)ネットワークであり、長距離の依存関係のモデリングと並列計算を可能にします。 双方向性の力 単方向モデルでは、トークンはそれ以前のトークンにしかアテンションを向けることができません。例えば、次の文を考えてみましょう。 「彼は銀行(bank)にお金を預けることに決めた。」 単方向モデルが「bank」を処理する場合、それより前にある単語しか見ません。しかし、文脈を完全に理解するには、左右両方の文脈を見ることが極めて重要です。双方向LSTMは、左から右と右から左のモデルを個別に学習して出力を結合することでこれを試みましたが、BERTはすべてのレイヤーで最初から単一の深い双方向モデルを共同で学習します。 2. BERTの入力表現 様々な下流タスクでの学習を可能にするため、BERTの入力表現は、単一のトークンシーケンス内で、単一の文と文のペア(例:<質問, 回答>)の両方を表現できます。 任意のトークンについて、その入力表現は次の3つの埋め込みを合算して構築されます。 トークン埋め込み(Token Embeddings): テキストは WordPiece ボキャブラリ(約30,000トークン)を使用してトークン化されます。特殊トークンが追加されます。 [CLS]:すべてのシーケンスの先頭に挿入されます。その最終隠れ状態は分類タスクに使用されます。 [SEP]:文を区切るため、またはシーケンスの末尾に使用されます。 セグメント埋め込み(Segment Embeddings): トークンが文Aと文Bのどちらに属しているかを示す、学習された埋め込み。 位置埋め込み(Position Embeddings): シーケンス内のトークンの位置をモデルに認識させるために追加される、学習された位置ベクトル(最大512トークン)。 $$\text{入力表現} = \text{トークン埋め込み} + \text{セグメント埋め込み} + \text{位置埋め込み}$$ 3. 事前学習プロセス BERTは、**マスク化言語モデル(MLM)と隣接文予測(NSP)**という2つの自己教師ありタスクを同時に使用して、大規模なコーパス(WikipediaおよびBooksCorpus)で事前学習されます。 タスク1:マスク化言語モデル(MLM) 標準的な言語モデリングでは、次の単語を予測する際に、ターゲット単語が自分自身を「見る」のを防ぐため、モデルを左から右のアーキテクチャに制限します。深い双方向表現を学習するために、BERTは入力トークンの一定割合をランダムにマスクし、それらを予測します。 具体的には:
BERT Transformers NLP ディープラーニング AIアーキテクチャ
アラビア語の感情分析:実践的なNLP前処理とモデルのウォークスルー

アラビア語の感情分析:実践的なNLP前処理とモデルのウォークスルー

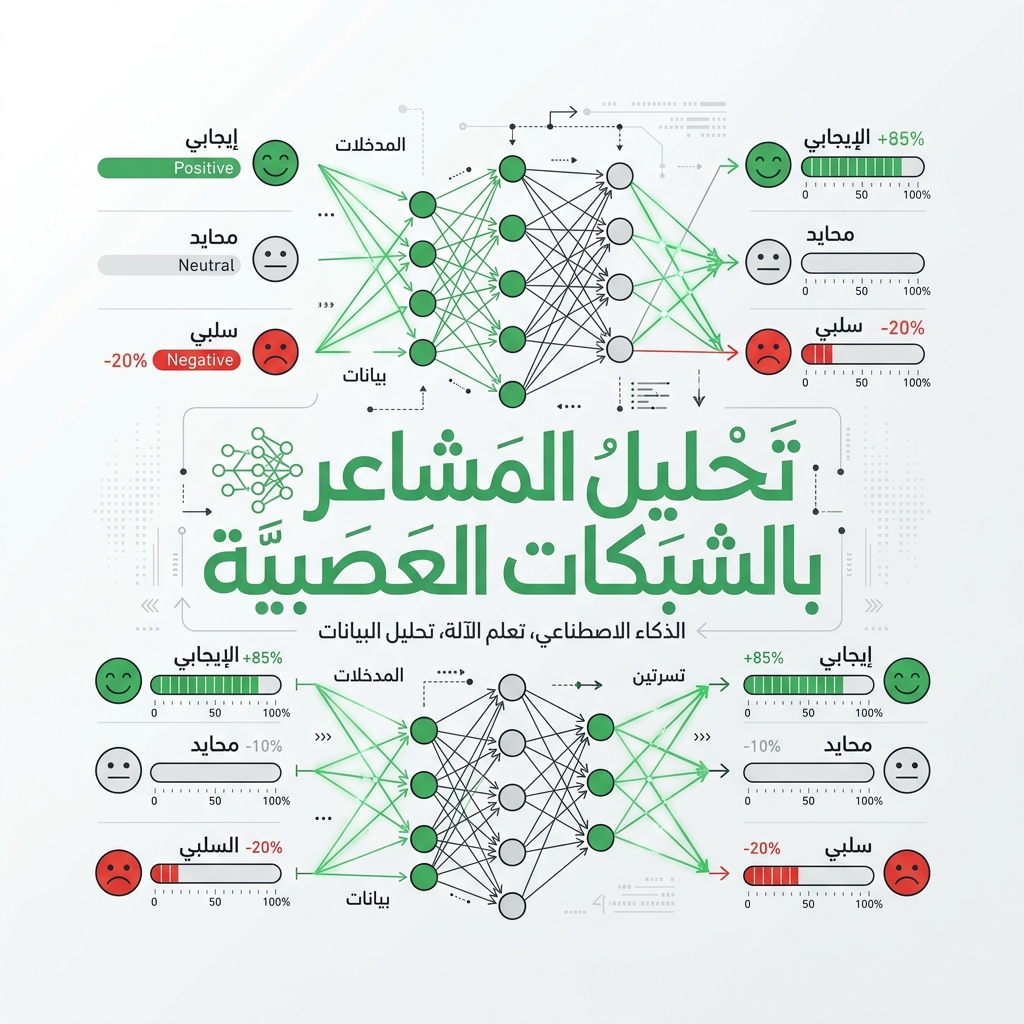
グローバル化したデジタルコミュニケーションの時代において、テキストの背後にある感情的なトーンを特定するタスクである「感情分析」は、企業、政府、研究者にとって不可欠なものとなっています。英語などの言語では感情分析は非常に成熟していますが、これをアラビア語に適用するには、言語的および技術的な独自の課題が存在します。 4億人以上の話者を抱えるアラビア語は、世界で最も広く話されている言語の一つです。しかし、その豊かな形態構造、ダイグロッシア(標準語と口語の共存)、そして複雑な文字システムには、専門的な前処理とモデリング戦略が必要です。 このガイドでは、アラビア語の感情分析の包括的なウォークスルーを提供し、課題、前処理パイプライン、古典的な機械学習の実装(TF-IDF + ロジスティック回帰)、およびHugging FaceのTransformersを使用した現代的なディープラーニングアプローチについて詳しく説明します。 1. アラビア語NLPの言語的課題 コードを書く前に、開発者はなぜアラビア語を標準的な西洋のNLPパイプラインで処理できないのかを理解する必要があります。 ダイグロッシア(二重言語状態): アラビア語は、書き言葉やニュース、公式文書で使用される**現代標準アラビア語(MSA)と、SNSや日常会話で使用される口語方言(ダリジャ/アンミーヤ)**に分かれています。方言(例:エジプト、レバント、湾岸方言)は、語彙、文法、感情表現において大きく異なります。 豊かな形態論: アラビア語は語根ベースの言語であり、パターンを適用することにより、3文字または4文字の語根から単語が派生します。単一の単語に、代名詞、前置詞、時制を表す接頭辞、接尾辞、接中辞が含まれることがあります(例:وسيكتبونها - 「そして彼らはそれを書くでしょう」)。 表記の揺れ: アラビア語の文字は位置によって形が変わることが多く、ユーザーは特定の文字を互換的に使用することがよくあります(例:أ、إ、آ、اなどのアリフの形状や、ىに対するيなどのヤーの形状)。 シャクル(記号): 短母音は、文字の上または下に付く補助記号(ファトハ、ダンマ、カスラなど)として書かれます。これらは意味を明確にしますが、デジタルテキストでは省略されることが多く、曖昧さの原因となったり、不整合に追加されてデータの希薄化を招いたりします。 2. アラビア語NLPパイプライン アラビア語テキストを処理するには、正規化、記号の除去、トークン化、ステミング(語幹抽出)、モデル推論を処理する専用のパイプラインを構築する必要があります。 graph TD A[生のアラビア語テキスト] --> B[正規化とクリーニング] B --> C[記号と句読点の削除] C --> D[トークン化] D --> E[ステミング / レマタイゼーション] E --> F[特徴量のベクトル化 / 埋め込み] F --> G[感情分類器] G --> H[出力:ポジティブ / ネガティブ / ニュートラル] 3. ウォークスルー:古典的な前処理と機械学習(Python) Python、NLTK、およびscikit-learnを使用して完全なパイプラインを実装してみましょう。カスタムの正規化ルールを記述し、NLTKのISRIStemmer(アラビア語専用に設計された情報検索用ステマー)を使用します。
自然言語処理 NLP 感情分析 アラビア語AI Transformers Python 機械学習