🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

Transformers

Comment fonctionne le modèle Transformer Gemini : GQA, SwiGLU et multimodalité native

Comment fonctionne le modèle Transformer Gemini : GQA, SwiGLU et multimodalité native

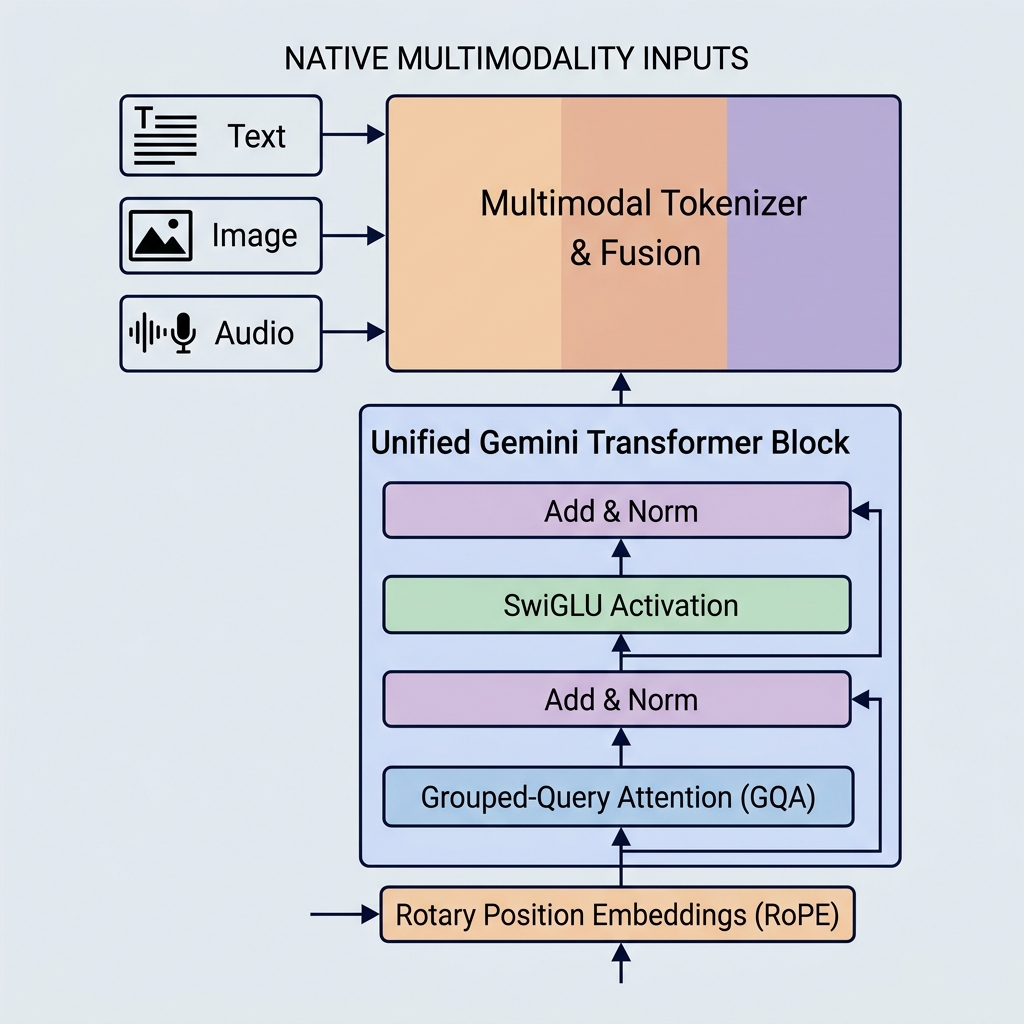
Les modèles Gemini de Google ont défini de nouvelles références en matière d’intelligence artificielle en introduisant une multimodalité native, des fenêtres de contexte massives et des optimisations architecturales clés. Contrairement aux modèles plus anciens comme GPT-3 ou BERT, Gemini est conçu pour gérer plusieurs types de données dès le premier jour et utilise des mécanismes d’attention hautement efficaces.
Gemini Transformers GQA SwiGLU Multimodalité Deep Learning
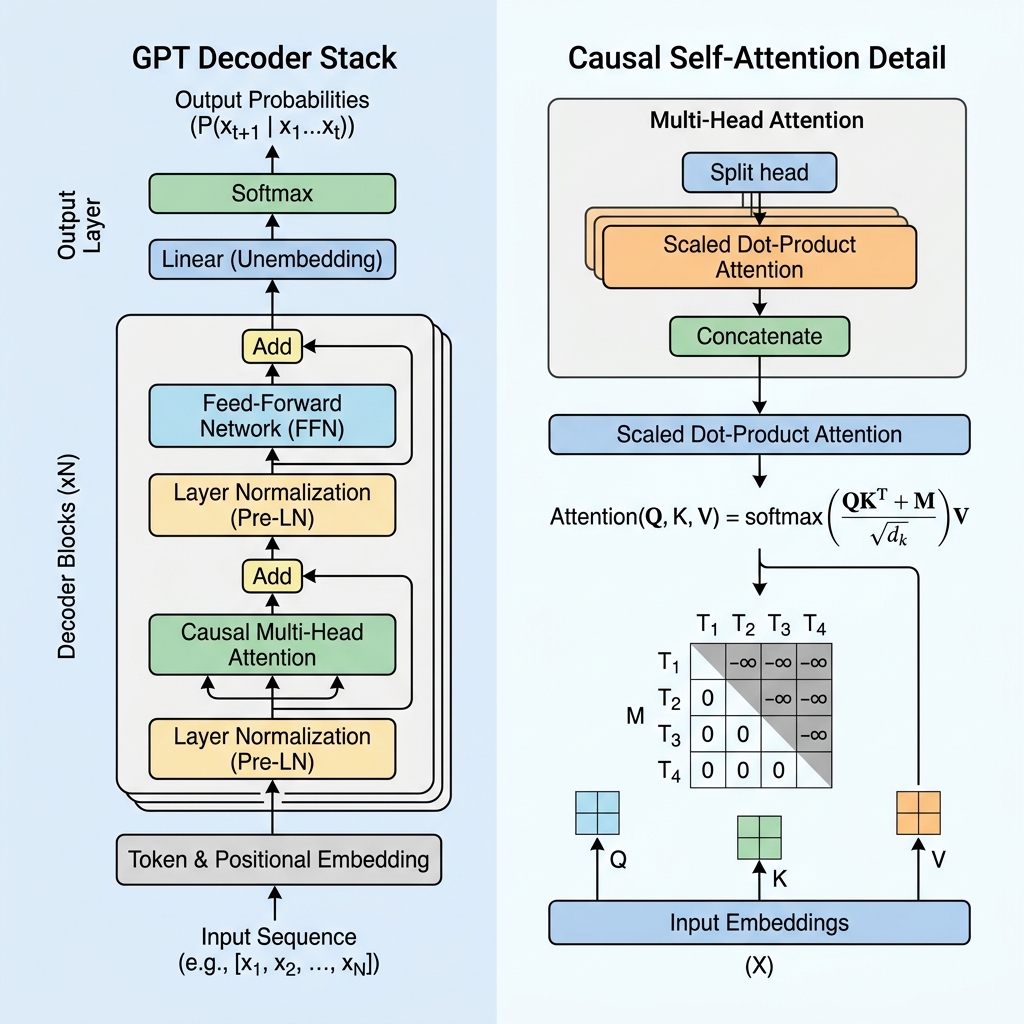
Comment fonctionne le Transformer GPT : L'auto-attention causale expliquée

Comment fonctionne le Transformer GPT : L'auto-attention causale expliquée

Ces dernières années, les modèles GPT (Generative Pre-trained Transformer) ont révolutionné l’intelligence artificielle. Des assistants de code aux agents conversationnels, les modèles basés sur GPT alimentent aujourd’hui les applications génératives les plus avancées. Mais comment fonctionne réellement cette technologie ? Alors que les modèles comme BERT utilisent la partie Encoder du Transformer pour comprendre le texte de manière bidirectionnelle, GPT est une architecture Decoder-only (décodeur uniquement) conçue pour la prédiction autorégressive du token suivant. Dans cet article, nous allons démystifier le fonctionnement du Transformer GPT, plonger dans le mécanisme d’auto-attention causale et l’implémenter en code.
GPT Transformers IA Générative Attention Causale NLP
Pourquoi les Transformers ont remplacé les RNN et les LSTM

Pourquoi les Transformers ont remplacé les RNN et les LSTM

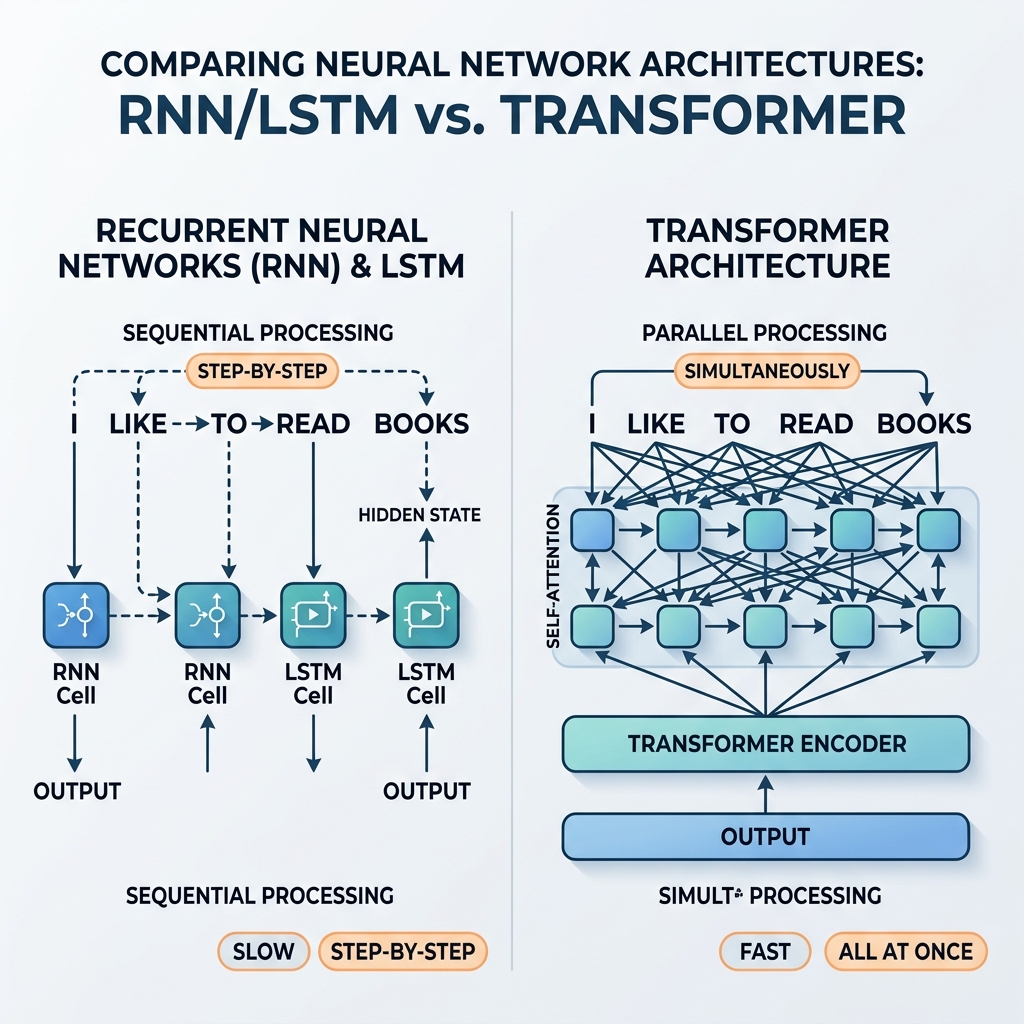
Pendant des années, les réseaux de neurones récurrents (RNN) et les réseaux LSTM (Long Short-Term Memory) ont été les champions incontestés du traitement des données séquentielles. Ils alimentaient des systèmes de traduction de pointe, des assistants vocaux et des modèles de génération de texte. Cependant, en 2017, l’article fondateur “Attention Is All You Need” (Vaswani et al.) a introduit l’architecture Transformer. En quelques années, les RNN et les LSTM ont été presque entièrement éliminés des modèles d’IA grand public.
Transformers RNN LSTM NLP Deep Learning
Comprendre BERT: Représentations d'Encodeur Bidirectionnelles à partir de Transformers

Comprendre BERT: Représentations d'Encodeur Bidirectionnelles à partir de Transformers

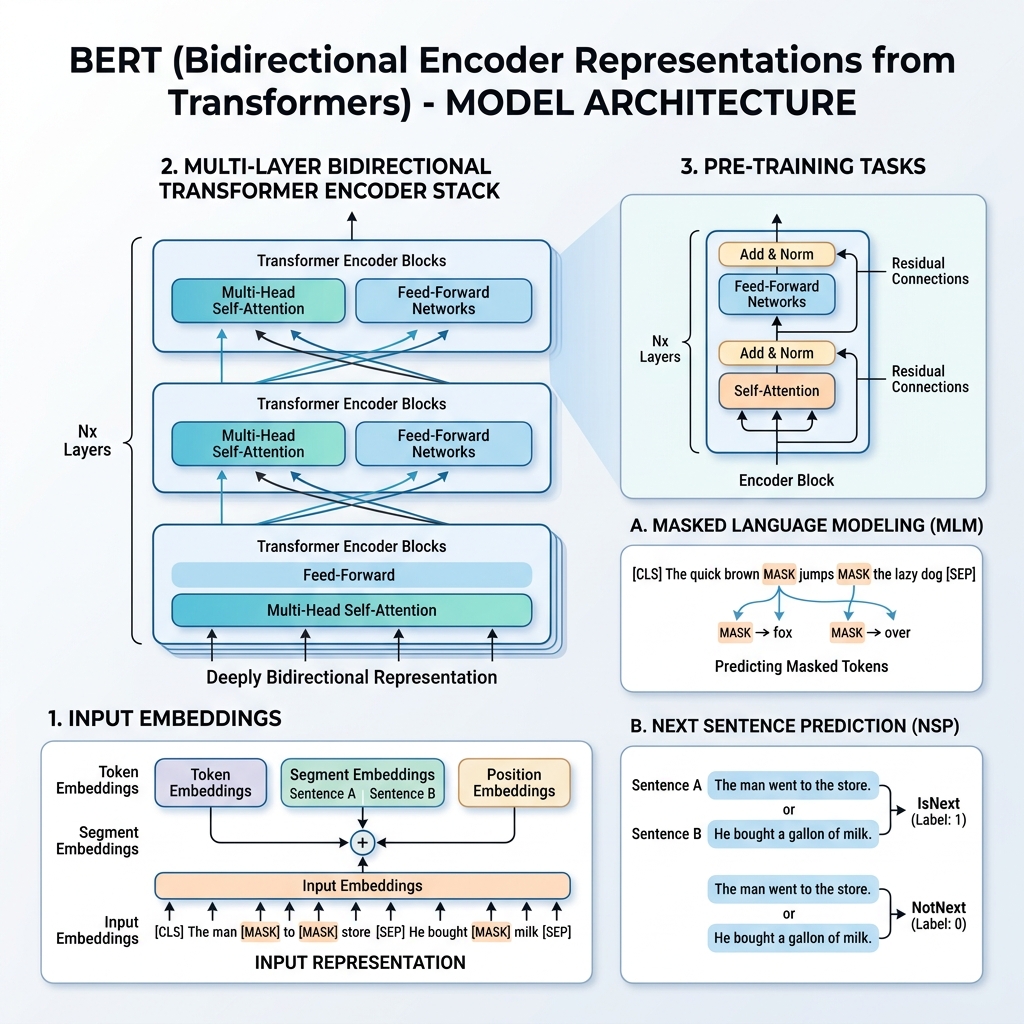
En 2018, les chercheurs de Google ont publié un article fondateur intitulé “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding” (Devlin et al.). Cette recherche a fondamentalement transformé le domaine du traitement du langage naturel (NLP). Avant BERT, les modèles traitaient le texte de manière séquentielle, de gauche à droite ou de droite à gauche. BERT a introduit une méthode pour entraîner des représentations de langage qui examinent simultanément le contexte dans les deux directions.
BERT Transformers NLP Deep Learning Architecture IA
Analyse des sentiments en arabe : guide pratique de prétraitement NLP et de modélisation

Analyse des sentiments en arabe : guide pratique de prétraitement NLP et de modélisation

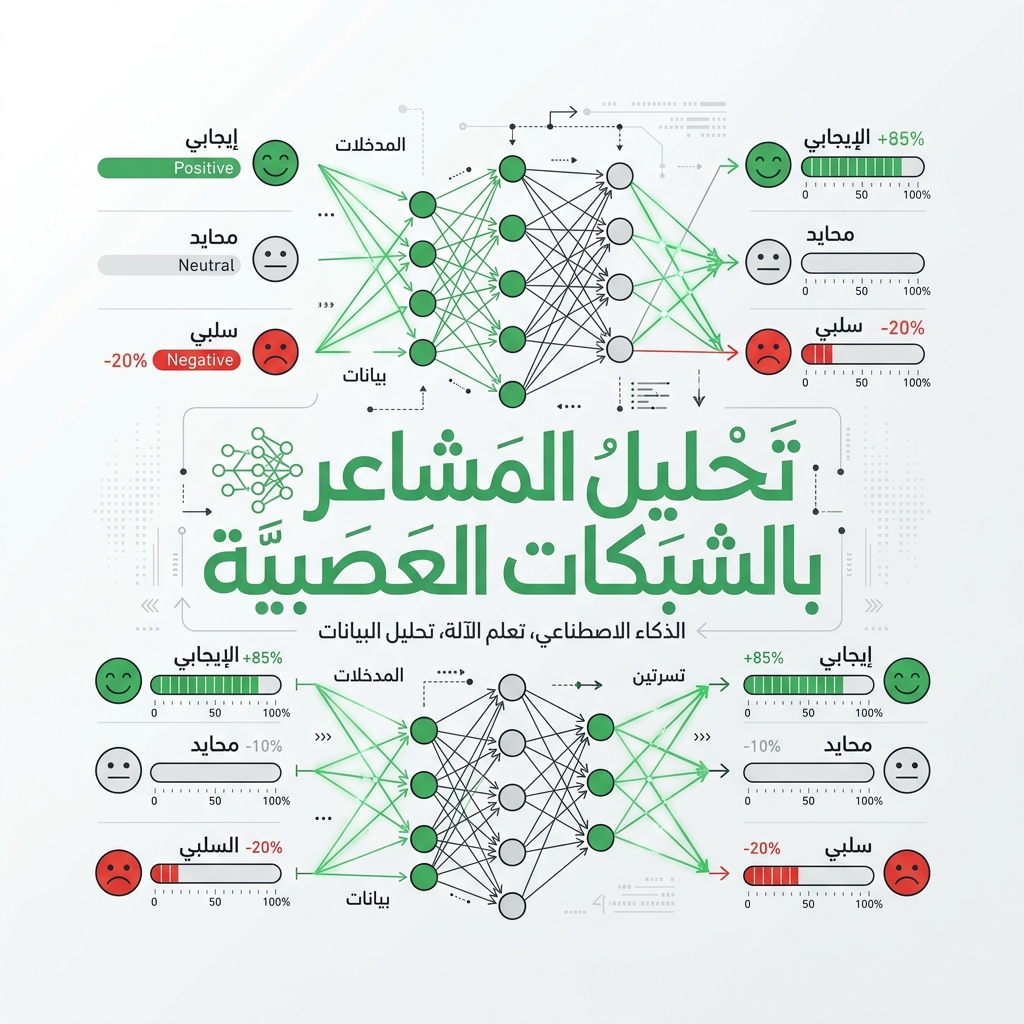
À l’ère de la communication numérique mondialisée, l’analyse des sentiments (l’identification de la tonalité émotionnelle derrière un texte) est devenue cruciale pour les entreprises, les gouvernements et les chercheurs. Bien que l’analyse des sentiments soit très mature pour des langues comme le français, son application à l’arabe présente un ensemble unique de défis linguistiques et techniques.
Traitement du Langage Naturel NLP Analyse des Sentiments IA Arabe Transformers Python Machine Learning