🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

Transformers

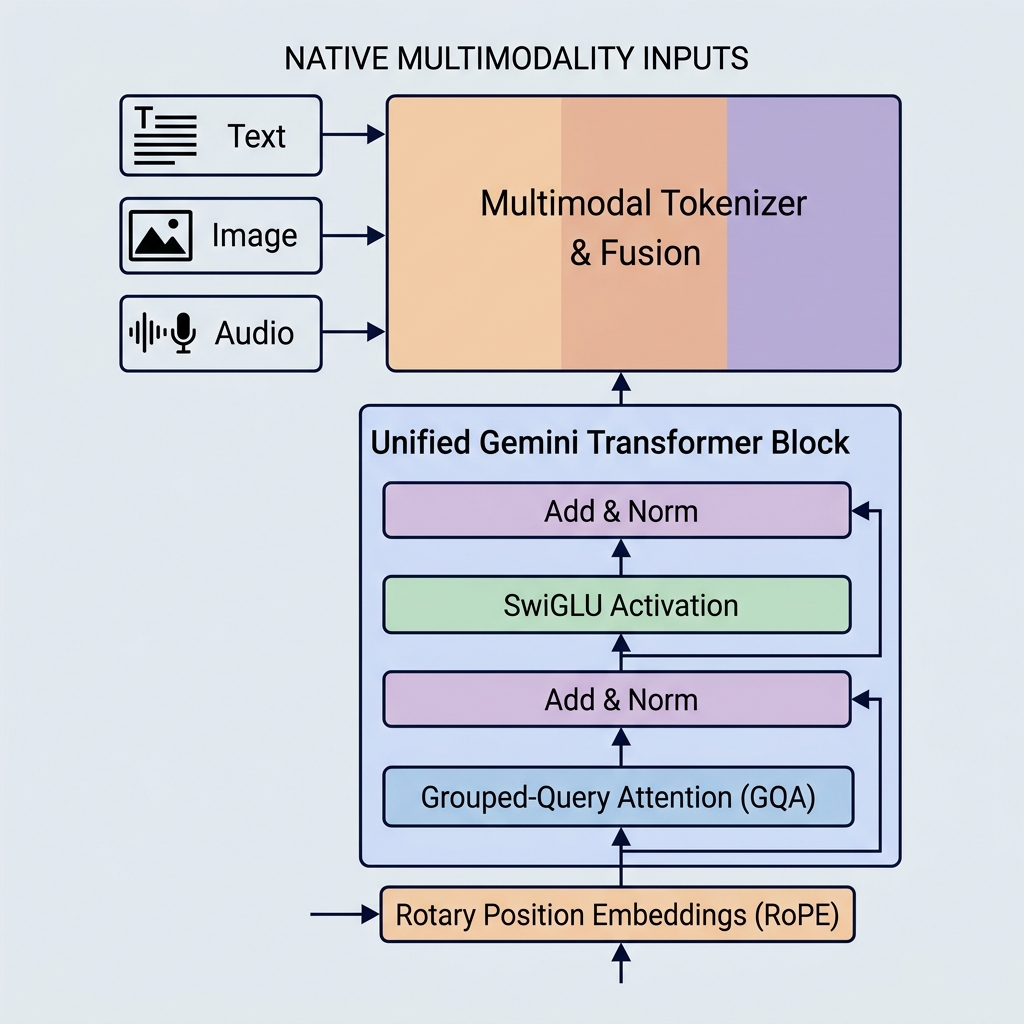
جیمنائی ٹرانسفارمر ماڈل کیسے کام کرتا ہے: GQA، SwiGLU اور نیٹیو ملٹی موڈالٹی

جیمنائی ٹرانسفارمر ماڈل کیسے کام کرتا ہے: GQA، SwiGLU اور نیٹیو ملٹی موڈالٹی

گوگل کے جیمنائی ماڈلز نے نیٹیو ملٹی موڈالٹی، بڑے کانٹیکسٹ ونڈوز، اور اہم فن تعمیراتی اصلاحات متعارف کروا کر اے آئی کی صلاحیتوں میں نئے معیارات قائم کیے ہیں۔ GPT-3 یا BERT جیسے پرانے ماڈلز کے برعکس، جیمنائی کو پہلے دن سے ہی متعدد قسم کے ڈیٹا کو سنبھالنے کے لیے بنایا گیا ہے اور یہ انتہائی موثر توجہ کے میکانزم کا استعمال کرتا ہے۔
Gemini Transformers GQA SwiGLU Multimodality Deep Learning
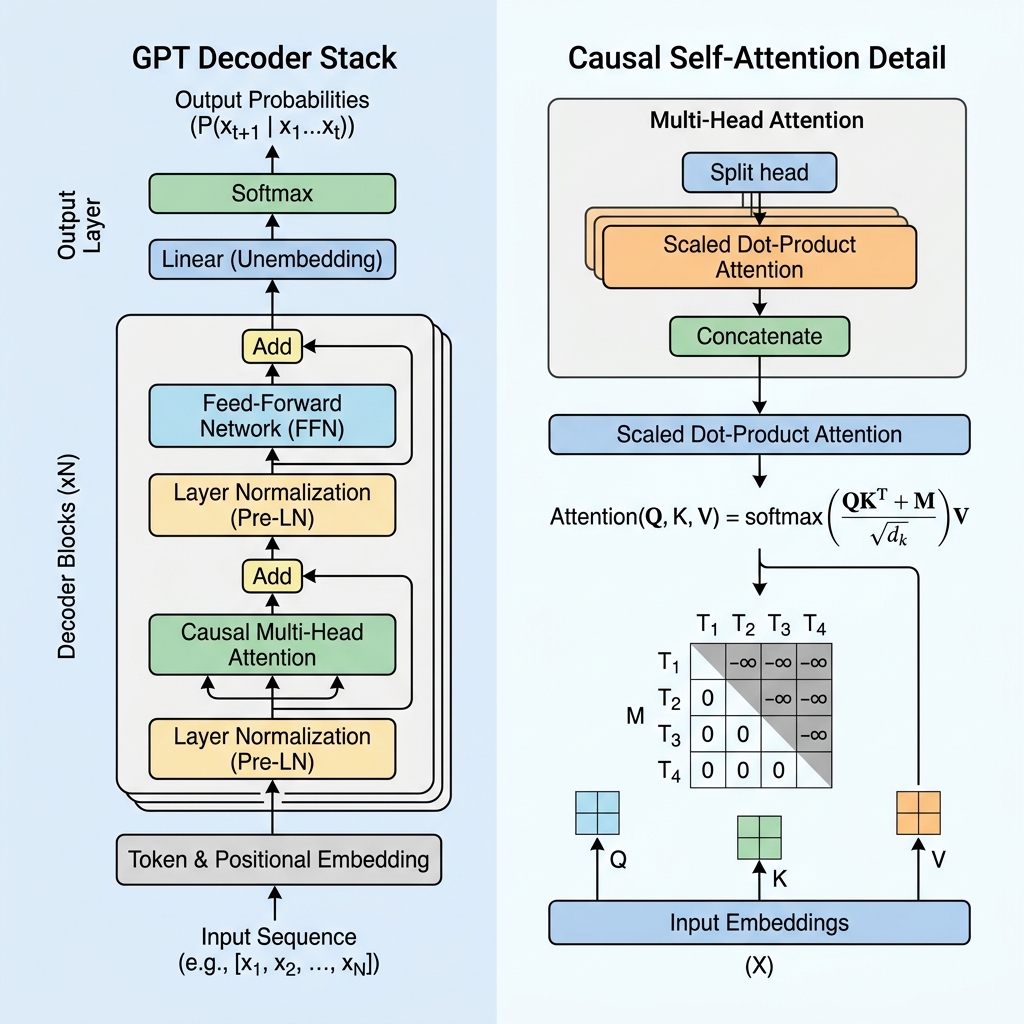
جی پی ٹی ٹرانسفارمر کیسے کام کرتا ہے؟ کازل سیلف اٹینشن کی تفصیل

جی پی ٹی ٹرانسفارمر کیسے کام کرتا ہے؟ کازل سیلف اٹینشن کی تفصیل

حالیہ برسوں میں، جنریٹو پری ٹرینڈ ٹرانسفارمرز (GPT) نے مصنوعی ذہانت کی دنیا میں ایک انقلاب برپا کر دیا ہے۔ کوڈنگ کے معاونین سے لے کر گفتگو کرنے والے سافٹ وئیرز تک، آج کی سب سے جدید ترین جنریٹو ایپلی کیشنز جی پی ٹی ماڈلز پر ہی چلتی ہیں۔ لیکن یہ ٹیکنالوجی اصل میں کیسے کام کرتی ہے؟
GPT Transformers Generative AI Causal Attention NLP
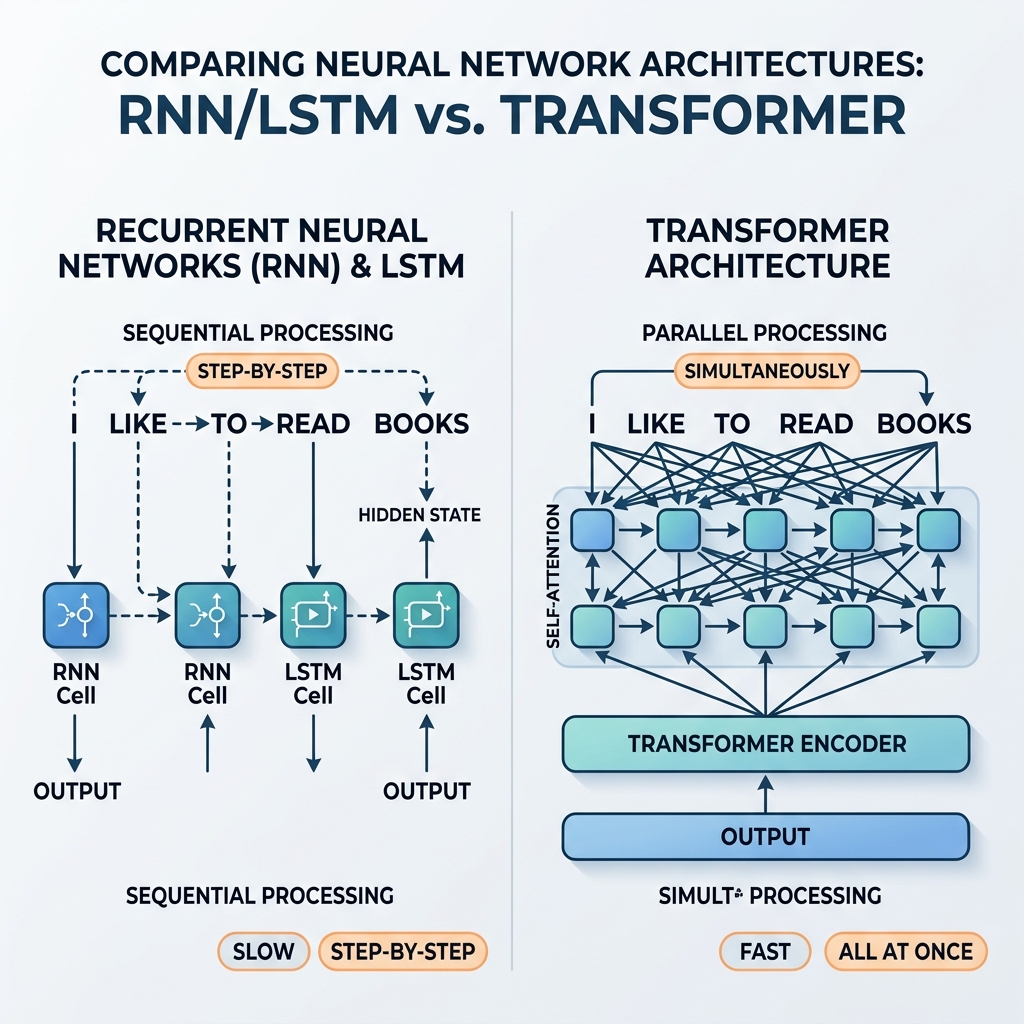
ٹرانسفارمرز نے RNN اور LSTM کی جگہ کیوں لی

ٹرانسفارمرز نے RNN اور LSTM کی جگہ کیوں لی

برسوں تک، ریکرنٹ نیورل نیٹ ورکس (RNNs) اور لانگ شارٹ ٹرم میموری (LSTM) نیٹ ورکس ترتیب وار ڈیٹا پروسیسنگ کے بے تاج بادشاہ تھے۔ انہوں نے جدید ترین ترجمہ کے نظام، صوتی معاونین، اور ٹیکسٹ جنریشن ماڈلز کو طاقت دی۔ تاہم، 2017 میں، تاریخی مقالے “Attention Is All You Need” (Vaswani et al.) نے ٹرانسفارمر فن تعمیر کو متعارف کرایا۔ چند ہی سالوں میں، RNNs اور LSTMs کو مرکزی دھارے کے AI ماڈلز سے تقریباً مکمل طور پر باہر کر دیا گیا۔
Transformers RNN LSTM NLP Deep Learning
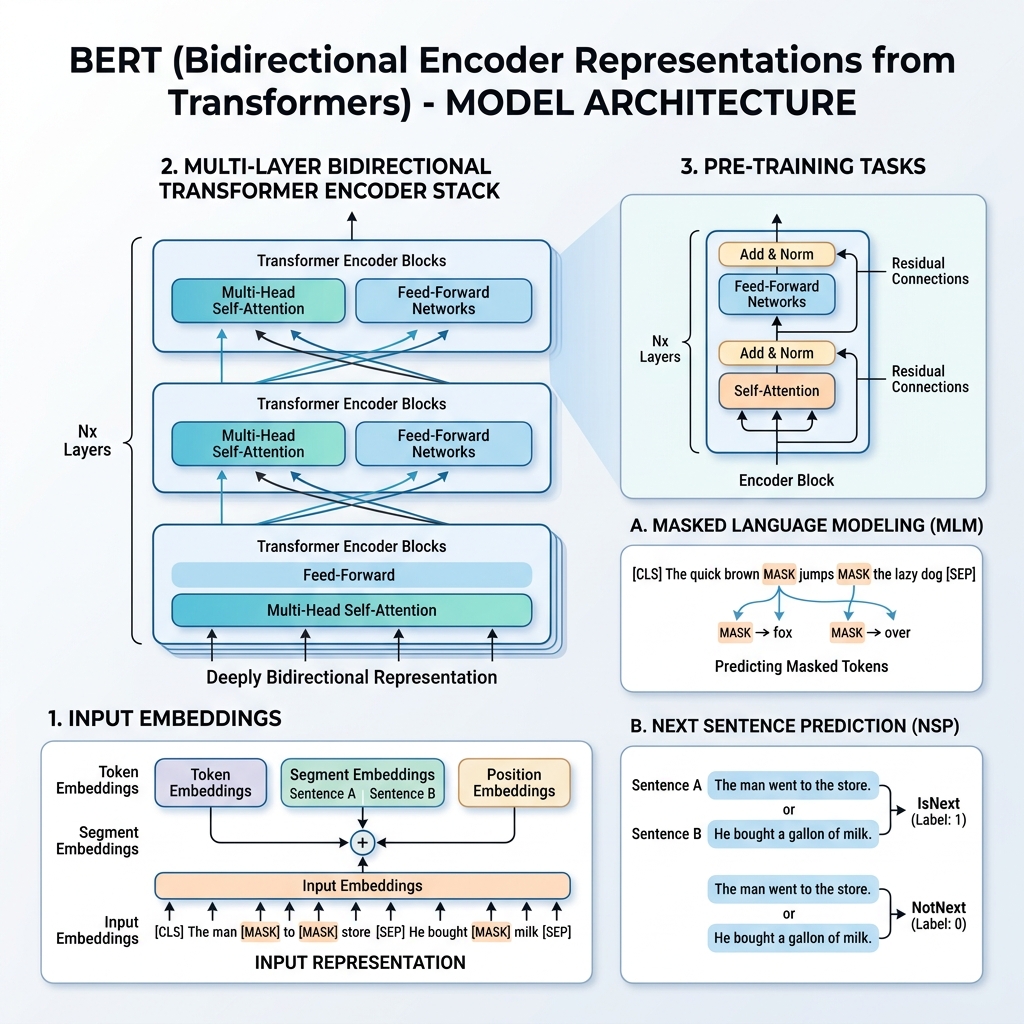
ماڈل کو سمجھنا: ٹرانسفارمرز سے دوطرفہ انکوڈر نمائندگی BERT

ماڈل کو سمجھنا: ٹرانسفارمرز سے دوطرفہ انکوڈر نمائندگی BERT

2018 میں، گوگل کے محققین نے ایک تاریخی مقالہ شائع کیا جس کا عنوان تھا “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding” (Devlin et al.)۔ اس تحقیق نے نیچرل لینگویج پروسیسنگ (NLP) کے شعبے کو بنیادی طور پر بدل دیا۔ BERT سے پہلے، ماڈل متن کو بائیں سے دائیں یا دائیں سے بائیں ترتیب وار پروسیس کرتے تھے۔ BERT نے زبان کی ایسی نمائندگیوں کو تربیت دینے کا طریقہ متعارف کرایا جو ایک ہی وقت میں دونوں سمتوں سے سیاق و سباق کو دیکھتی ہیں۔
BERT Transformers NLP Deep Learning AI Architecture