🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

Transformers

كيف يعمل نموذج ترانسفورمر Gemini: ‏GQA وSwiGLU والوسائط المتعددة الأصلية

كيف يعمل نموذج ترانسفورمر Gemini: ‏GQA وSwiGLU والوسائط المتعددة الأصلية

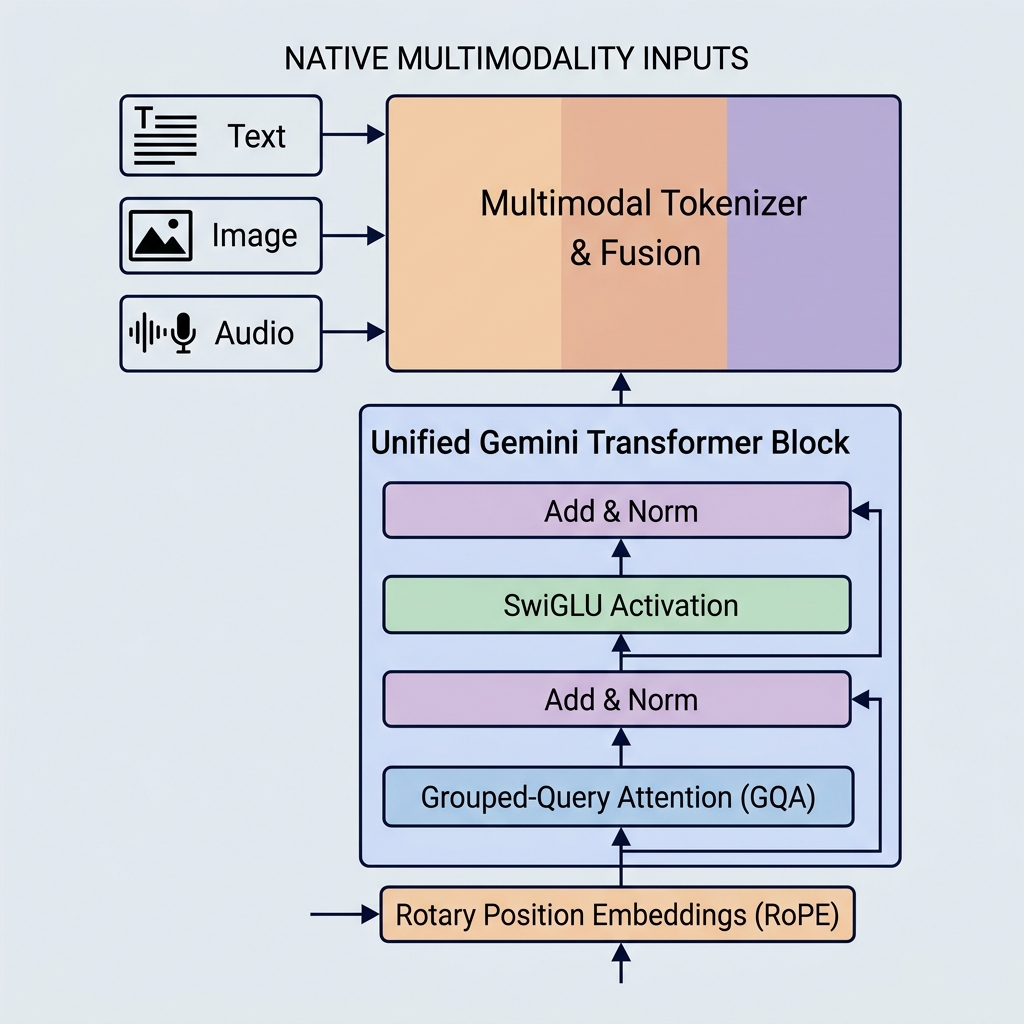
وضعت نماذج Gemini من Google معايير جديدة لقدرات الذكاء الاصطناعي من خلال تقديم الوسائط المتعددة الأصلية، ونوافذ السياق الضخمة، والتحسينات الهيكلية الرئيسية. وخلافاً للنماذج القديمة مثل GPT-3 أو BERT، فقد تم تصميم Gemini للتعامل مع أنواع متعددة من البيانات منذ اليوم الأول، ويستخدم آليات انتباه عالية الكفاءة.
Gemini Transformers GQA SwiGLU Multimodality Deep Learning
كيف يعمل نموذج GPT Transformer: شرح آلية الانتباه الذاتي السببي

كيف يعمل نموذج GPT Transformer: شرح آلية الانتباه الذاتي السببي

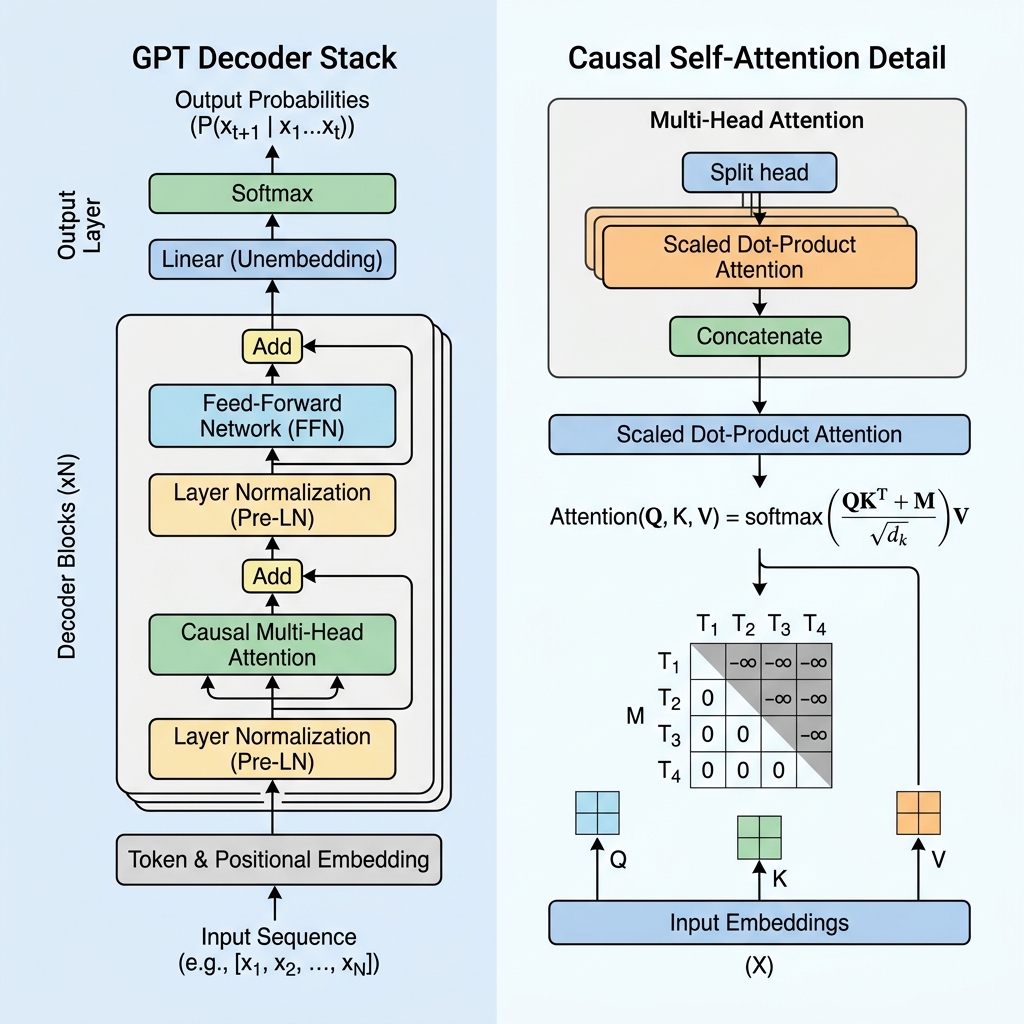
في السنوات الأخيرة، أحدثت النماذج التوليدية مسبقة التدريب (GPT) ثورة حقيقية في مجالات الذكاء الاصطناعي. من مساعدي البرمجة إلى برمجيات المحادثة التفاعلية، تشغل النماذج القائمة على GPT أكثر التطبيقات التوليدية تقدمًا اليوم. ولكن كيف تعمل هذه التكنولوجيا فعليًا؟ بينما تستخدم نماذج مثل BERT جزء الترميز (Encoder) من نموذج Transformer لفهم النصوص بشكل ثنائي الاتجاه، فإن GPT يعتمد على بنية فك الترميز فقط (Decoder-only) المصممة للتنبؤ بالتوكن التالي بشكل تكراري تلقائي (autoregressive). في هذه التدوينة، سنزيل الغموض عن كيفية عمل GPT Transformer، ونغوص عميقًا في آلية الانتباه الذاتي السببي (causal self-attention)، ونقوم بتنفيذها برمجياً.
GPT Transformers الذكاء الاصطناعي التوليدي الانتباه السببي معالجة اللغة الطبيعية
لماذا حلت المحولات (Transformers) محل شبكات RNN و LSTM

لماذا حلت المحولات (Transformers) محل شبكات RNN و LSTM

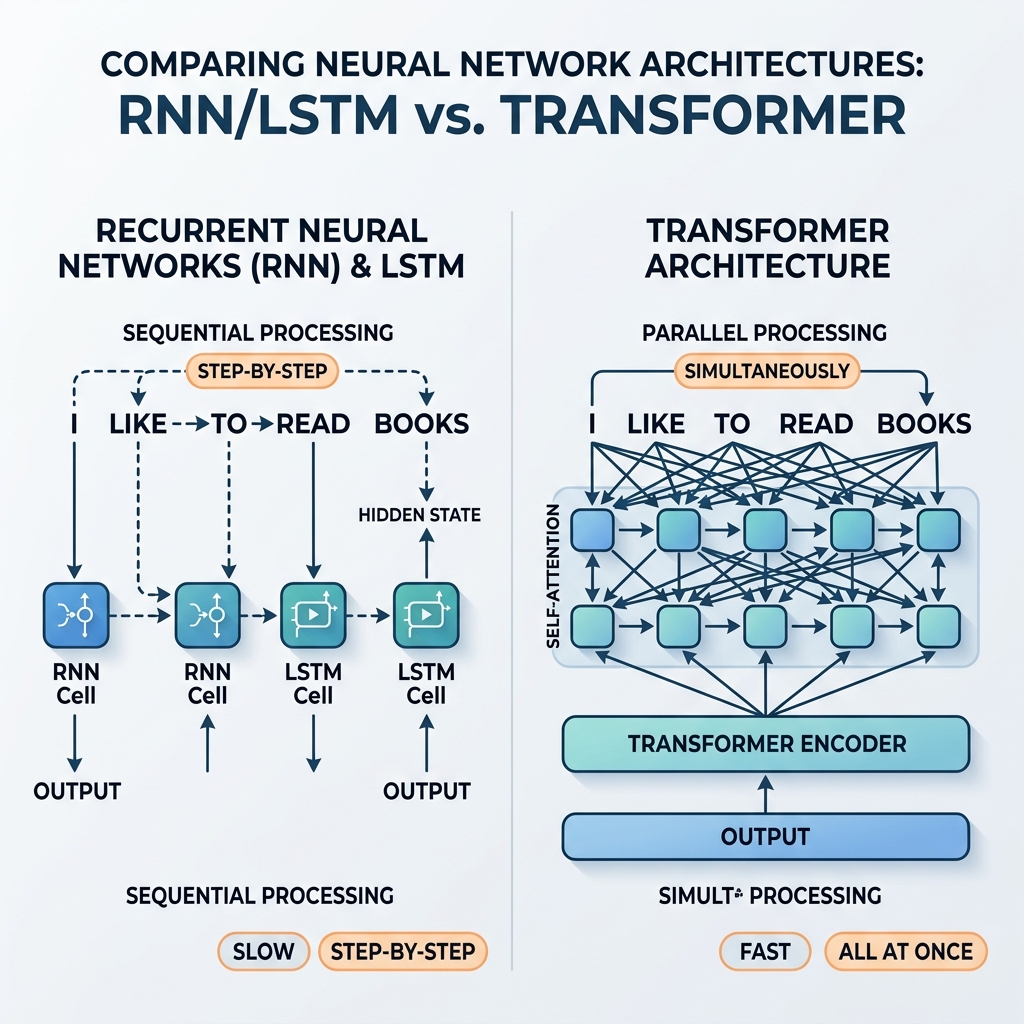
لسنوات عديدة، كانت الشبكات العصبية المتكررة (RNNs) وشبكات الذاكرة طويلة قصيرة المدى (LSTM) هي البطل بلا منازع في معالجة البيانات المتسلسلة. لقد قامت بتشغيل أنظمة الترجمة الحديثة، والمساعدين الصوتيين، ونماذج توليد النصوص. ومع ذلك، في عام 2017، قدمت الورقة البحثية التاريخية “Attention Is All You Need” (Vaswani et al.) بنية المحول (Transformer). وخلال سنوات قليلة، تم التخلص تدريجياً من شبكات RNN و LSTM تماماً من نماذج الذكاء الاصطناعي السائدة.
Transformers RNN LSTM NLP Deep Learning
فهم نموذج BERT: تمثيلات المشفر ثنائية الاتجاه من المحولات

فهم نموذج BERT: تمثيلات المشفر ثنائية الاتجاه من المحولات

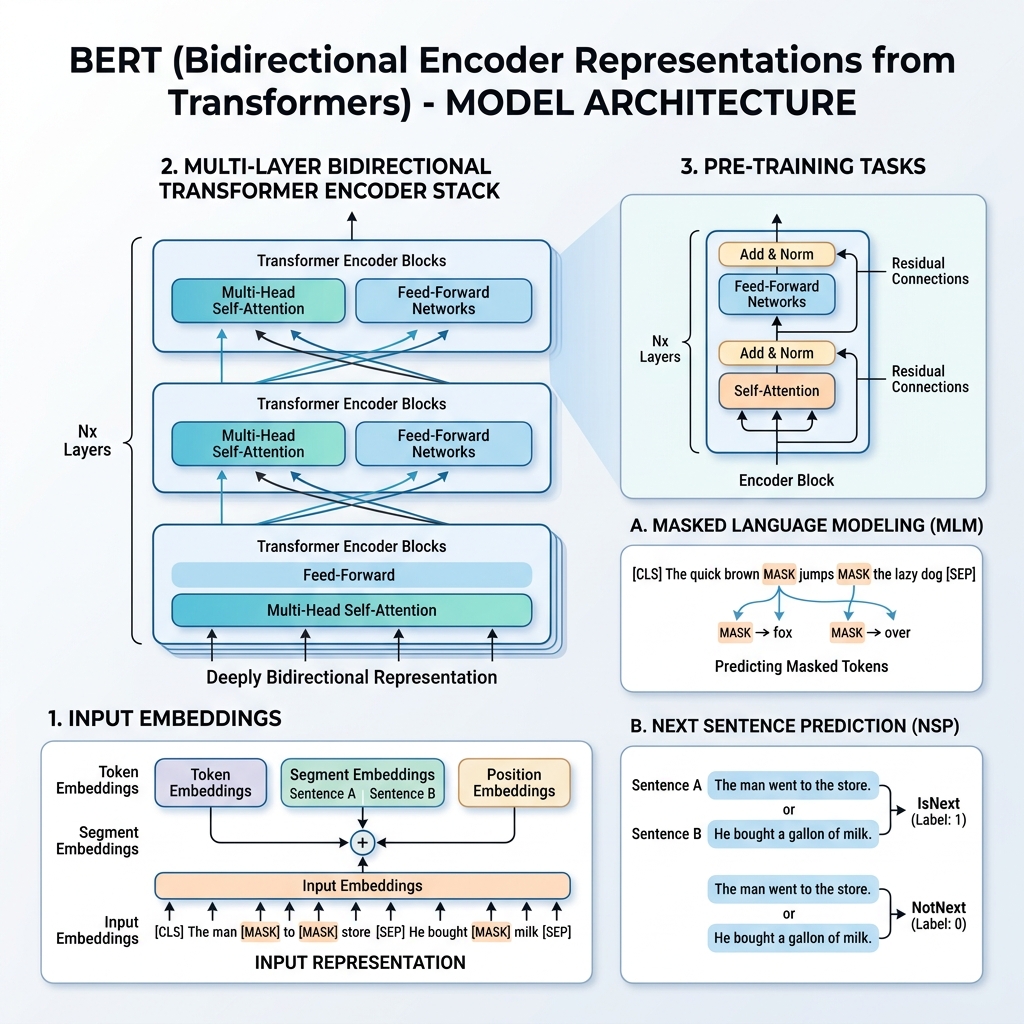
في عام 2018، نشر باحثو Google ورقة بحثية بارزة بعنوان “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding” (Devlin et al.). لقد غير هذا البحث بشكل جذري مجال معالجة اللغة الطبيعية (NLP). قبل BERT، كانت النماذج تعالج النصوص بشكل متسلسل من اليسار إلى اليمين أو من اليمين إلى اليسار. قدم BERT طريقة لتدريب تمثيلات اللغة التي تنظر إلى السياق من كلا الاتجاهين في وقت واحد.
BERT Transformers NLP Deep Learning AI Architecture