🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

NLP

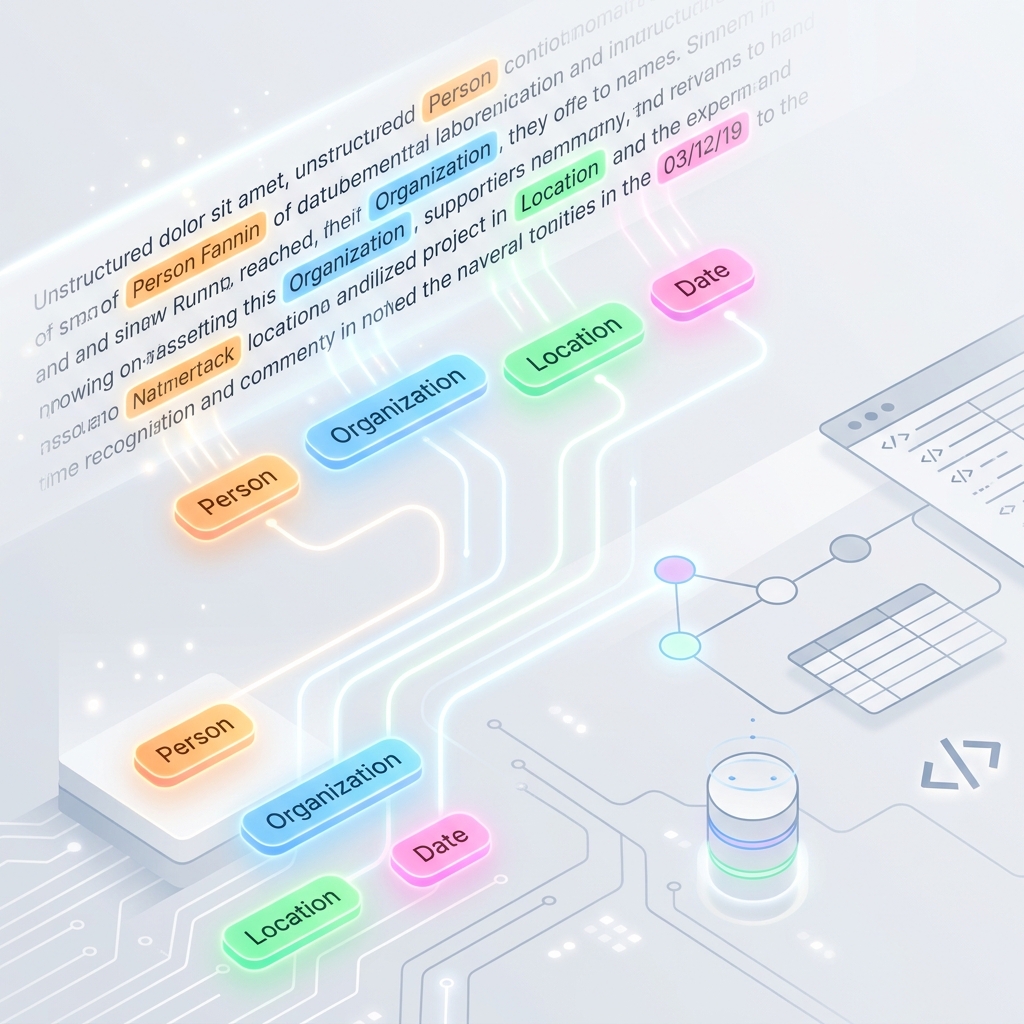
Reconhecimento de Entidades Nomeadas (NER): Do NLP Clássico à Extração baseada em IA

Reconhecimento de Entidades Nomeadas (NER): Do NLP Clássico à Extração baseada em IA

O Reconhecimento de Entidades Nomeadas (NER, na sigla em inglês) é um dos pilares do Processamento de Linguagem Natural (NLP). Trata-se do processo de identificar e classificar automaticamente elementos-chave em textos não estruturados em categorias predefinidas — tais como nomes de pessoas, organizações, localizações, datas, valores monetários e nomes de produtos.
IA NER NLP Aprendizado de Máquina Grandes Modelos de Linguagem
Como funciona o GPT Transformer: Explicação da Autoatenção Causal

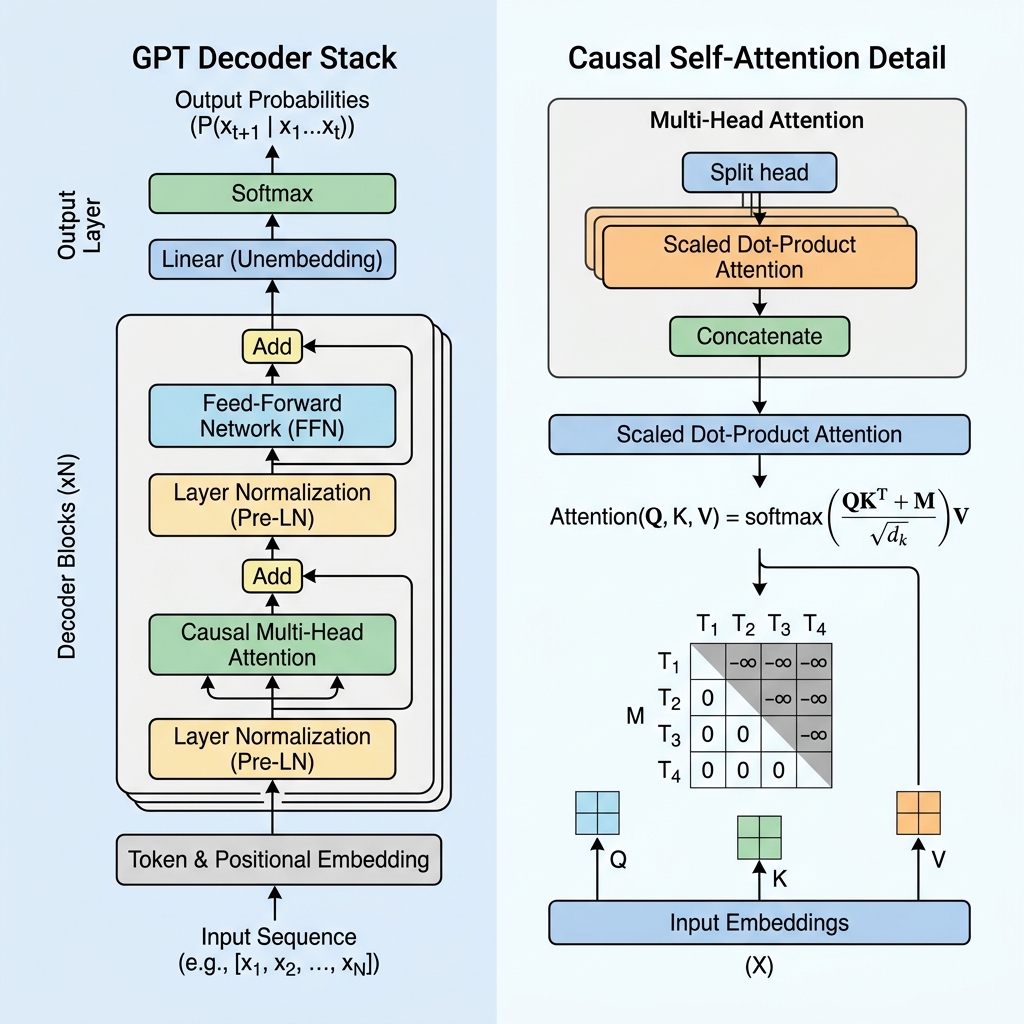
Como funciona o GPT Transformer: Explicação da Autoatenção Causal

Como funciona o GPT Transformer: Explicação da Autoatenção Causal Nos últimos anos, os Transformers Generativos Pré-treinados (GPT) revolucionaram a inteligência artificial. De assistentes de programação a agentes conversacionais, os modelos baseados em GPT alimentam as aplicações generativas mais avançadas da atualidade. Mas como essa tecnologia realmente funciona?
GPT Transformers IA Generativa Atenção Causal NLP
Por que os Transformers substituíram as RNNs e LSTMs

Por que os Transformers substituíram as RNNs e LSTMs

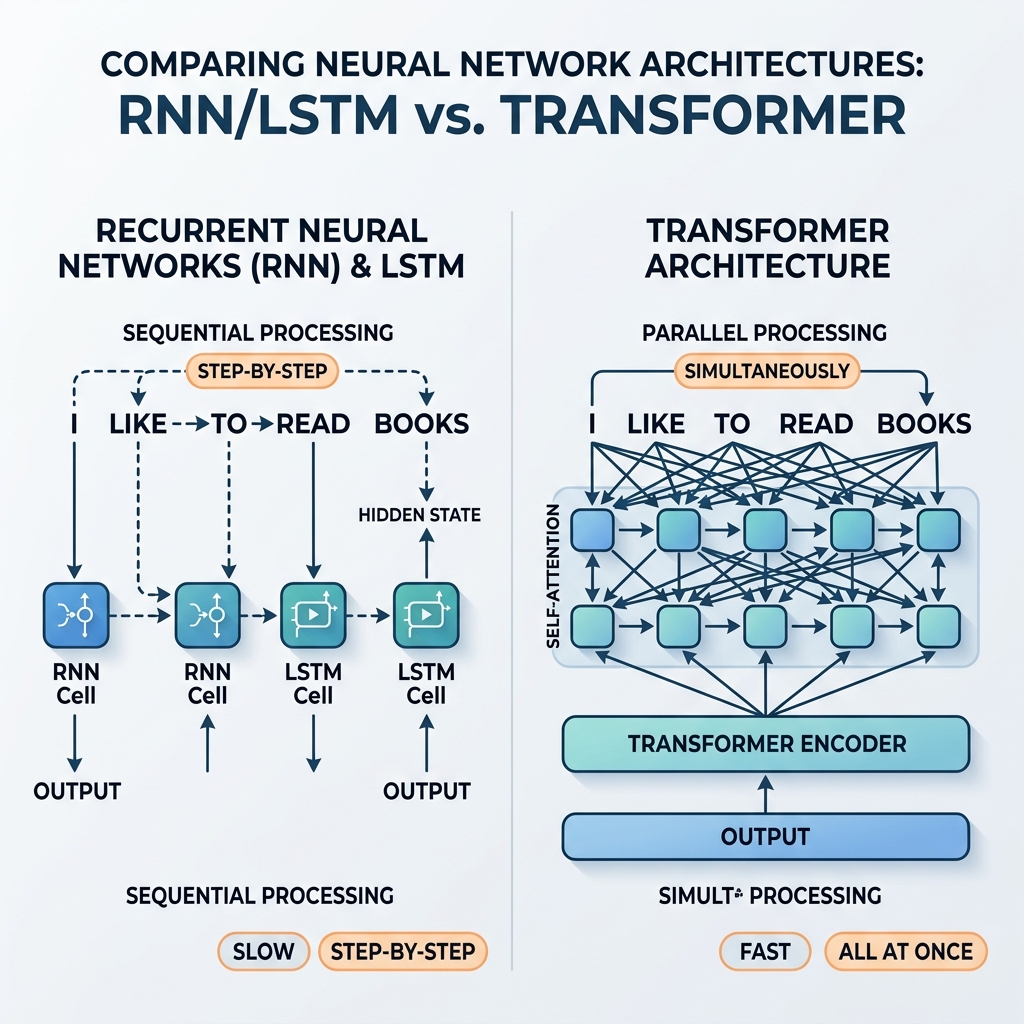
Por anos, as Redes Neurais Recorrentes (RNNs) e as redes de memória de longo prazo (LSTM) foram as campeãs incontestáveis do processamento de dados sequenciais. Elas alimentavam sistemas de tradução de última geração, assistentes de voz e modelos de geração de texto. No entanto, em 2017, o artigo seminal “Attention Is All You Need” (Vaswani et al.) introduziu a arquitetura Transformer. Em poucos anos, as RNNs e LSTMs foram quase inteiramente eliminadas dos modelos de IA tradicionais.
Transformers RNN LSTM NLP Deep Learning
Compreendendo o BERT: Representações de Codificador Bidirecional de Transformers

Compreendendo o BERT: Representações de Codificador Bidirecional de Transformers

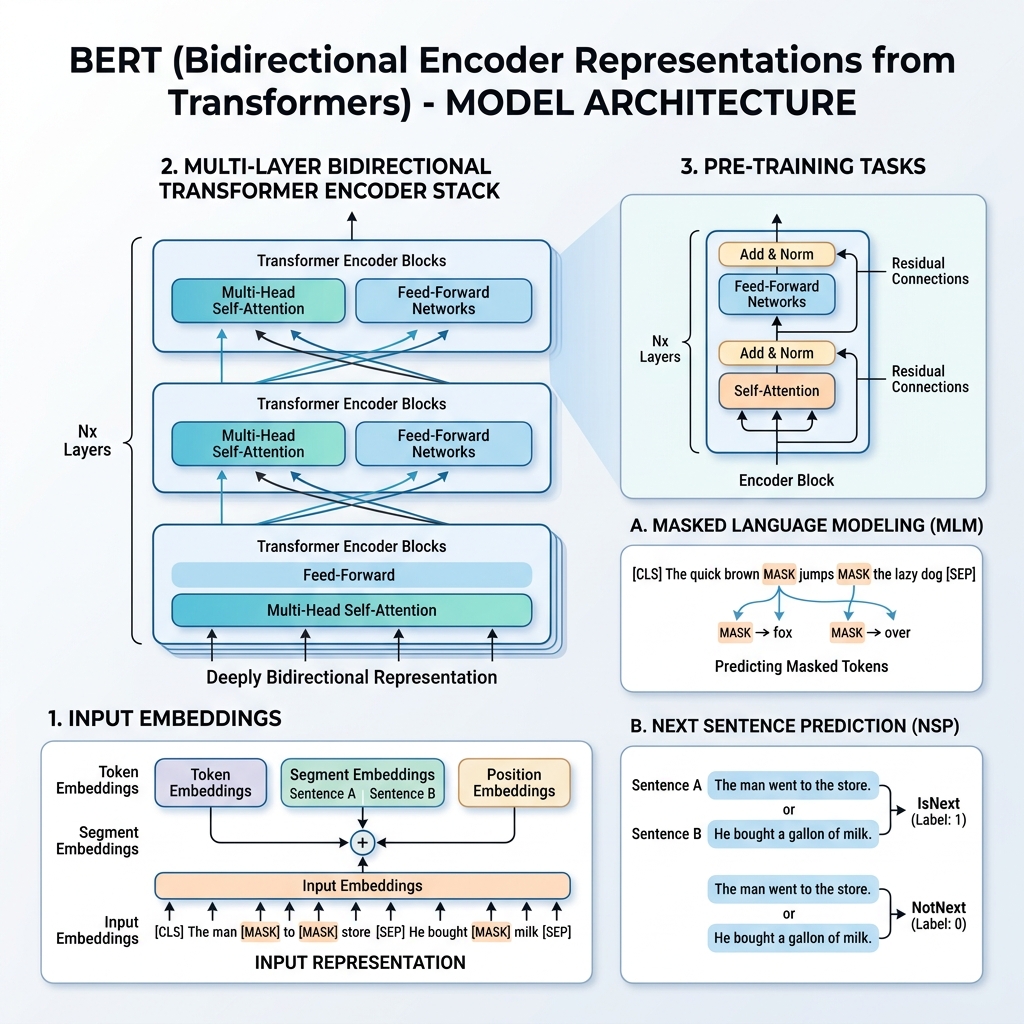
Em 2018, os pesquisadores do Google publicaram um artigo marcante intitulado “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding” (Devlin et al.). Esta pesquisa mudou fundamentalmente o campo do Processamento de Linguagem Natural (NLP). Antes do BERT, os modelos processavam o texto sequencialmente da esquerda para a direita ou da direita para a esquerda. O BERT introduziu um método para treinar representações de linguagem que olham para o contexto de ambas as direções simultaneamente.
BERT Transformers NLP Deep Learning Arquitetura de IA
Entendendo Redes Transformer e o Mecanismo de Self-Attention

Entendendo Redes Transformer e o Mecanismo de Self-Attention

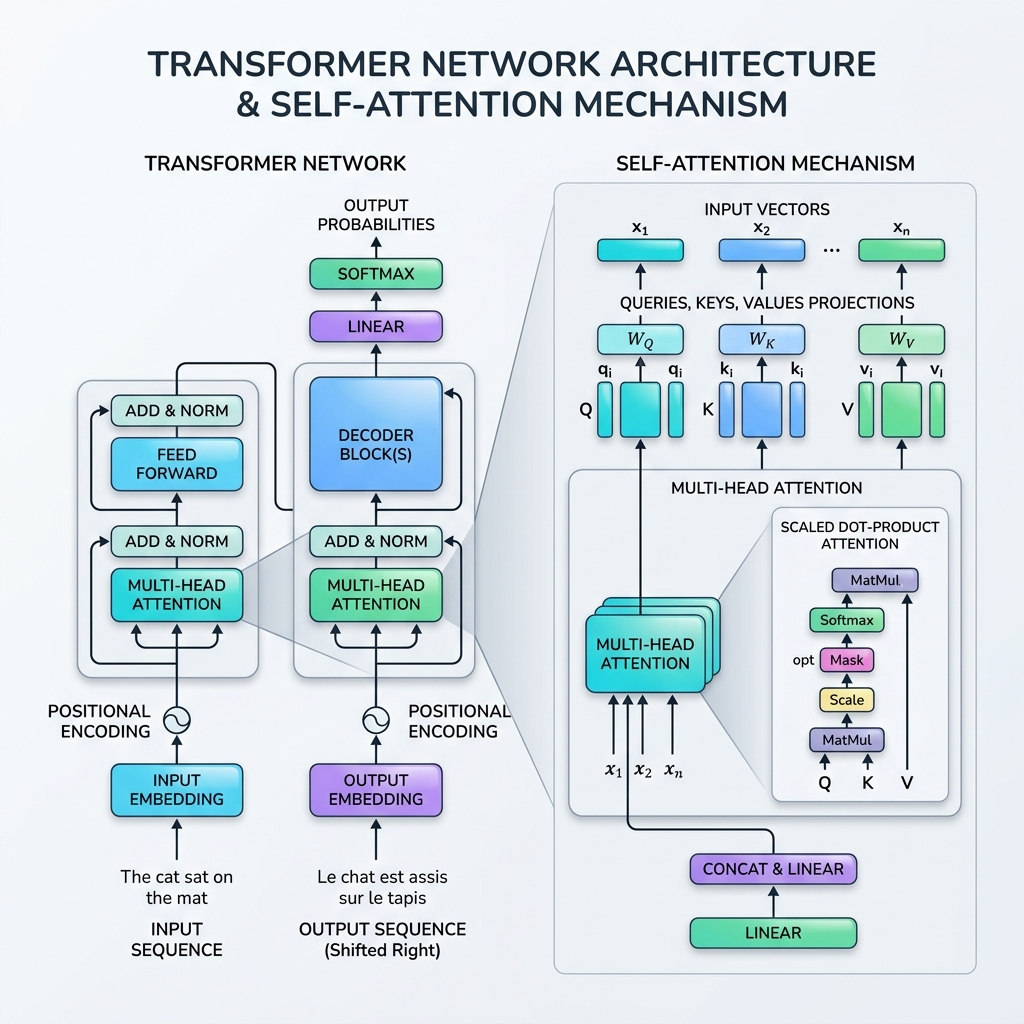
Em 2017, o cenário da inteligência artificial mudou para sempre com a publicação do seminal artigo “Attention Is All You Need” por Vaswani et al. O artigo introduziu o Transformer, uma arquitetura de rede neural revolucionária que descartou completamente a recorrência (RNNs, LSTMs), optando por processar dados sequenciais em paralelo usando o Mecanismo de Self-Attention (Autoatendimento).
Transformer Self-Attention Deep Learning NLP Arquitetura de IA
Desmistificando a Arquitetura Sequence-to-Sequence e o Mecanismo de Atenção

Desmistificando a Arquitetura Sequence-to-Sequence e o Mecanismo de Atenção

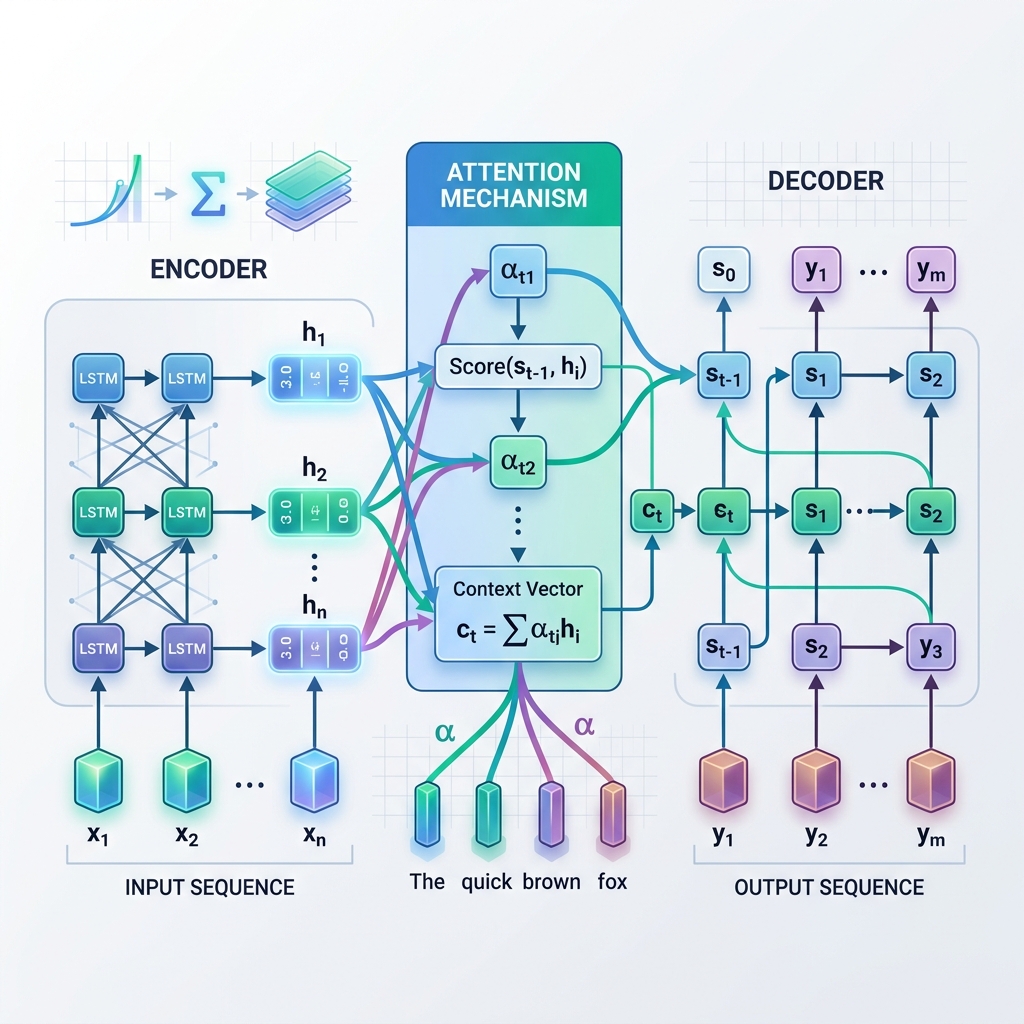
No panorama do Processamento de Linguagem Natural (NLP) e da Inteligência Artificial, a capacidade de traduzir idiomas, resumir artigos e gerar respostas conversacionais passou por uma revolução. No coração dessa transformação está a arquitetura Sequence-to-Sequence (Seq2Seq) e o pioneiro Mecanismo de Atenção. Antes do advento dos Transformers modernos, essas duas inovações resolveram um dos maiores desafios do aprendizado profundo: mapear sequências de entrada para sequências de saída quando seus comprimentos são diferentes.
Seq2Seq Mecanismo de Atenção Deep Learning NLP Inteligência Artificial