🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

NLP

Named Entity Recognition (NER): dalla NLP classica all'estrazione potenziata dall'IA

Named Entity Recognition (NER): dalla NLP classica all'estrazione potenziata dall'IA

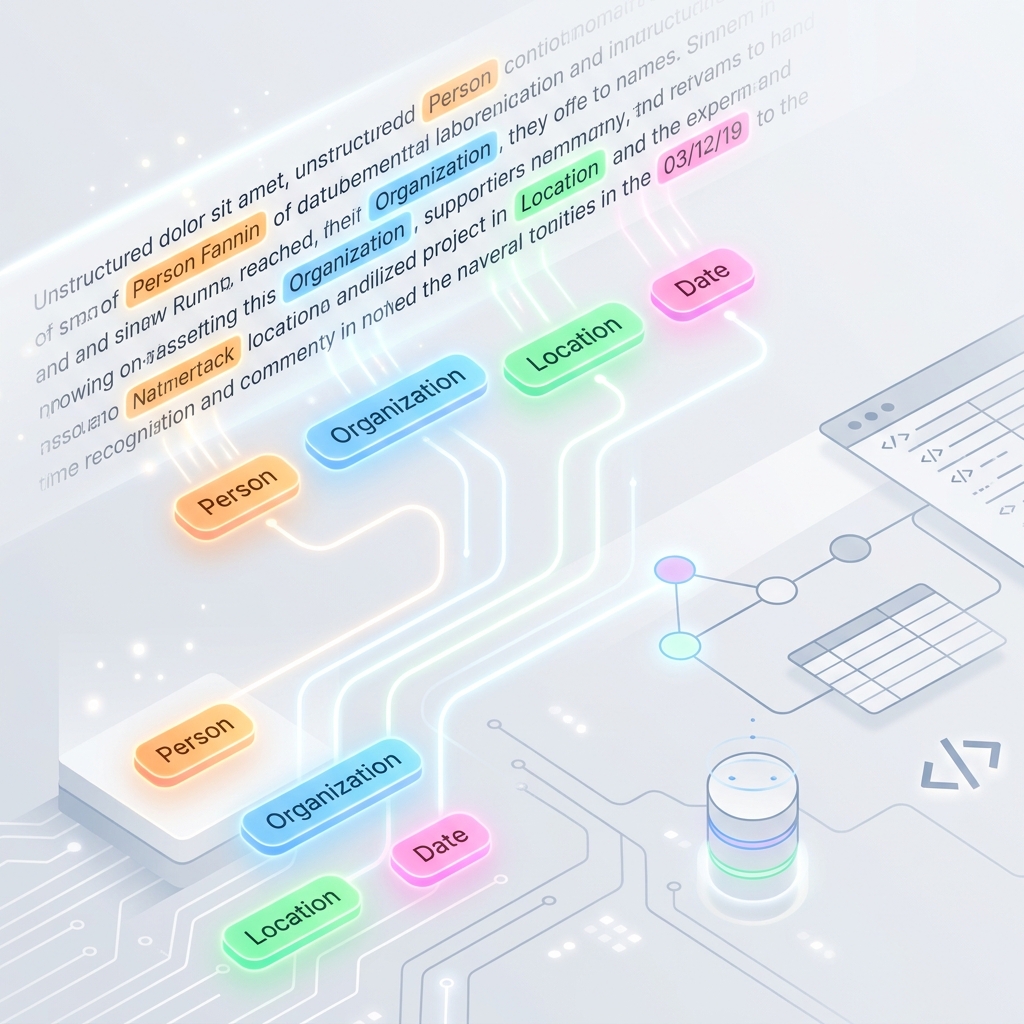
Il Named Entity Recognition (NER) è una pietra miliare del Natural Language Processing (NLP). È il processo di identificazione e classificazione automatica di elementi chiave in un testo non strutturato in categorie predefinite, come nomi di persone, organizzazioni, luoghi, date, valori monetari e nomi di prodotti. Senza il NER, i motori di ricerca, i motori di raccomandazione e i sistemi di analisi automatizzata dei documenti farebbero fatica a capire chi, cosa, dove e quando all’interno di un testo.
AI NER NLP Apprendimento Automatico Modelli Linguistici di Grandi Dimensioni
Come funziona il GPT Transformer: Spiegazione della Causal Self-Attention

Come funziona il GPT Transformer: Spiegazione della Causal Self-Attention

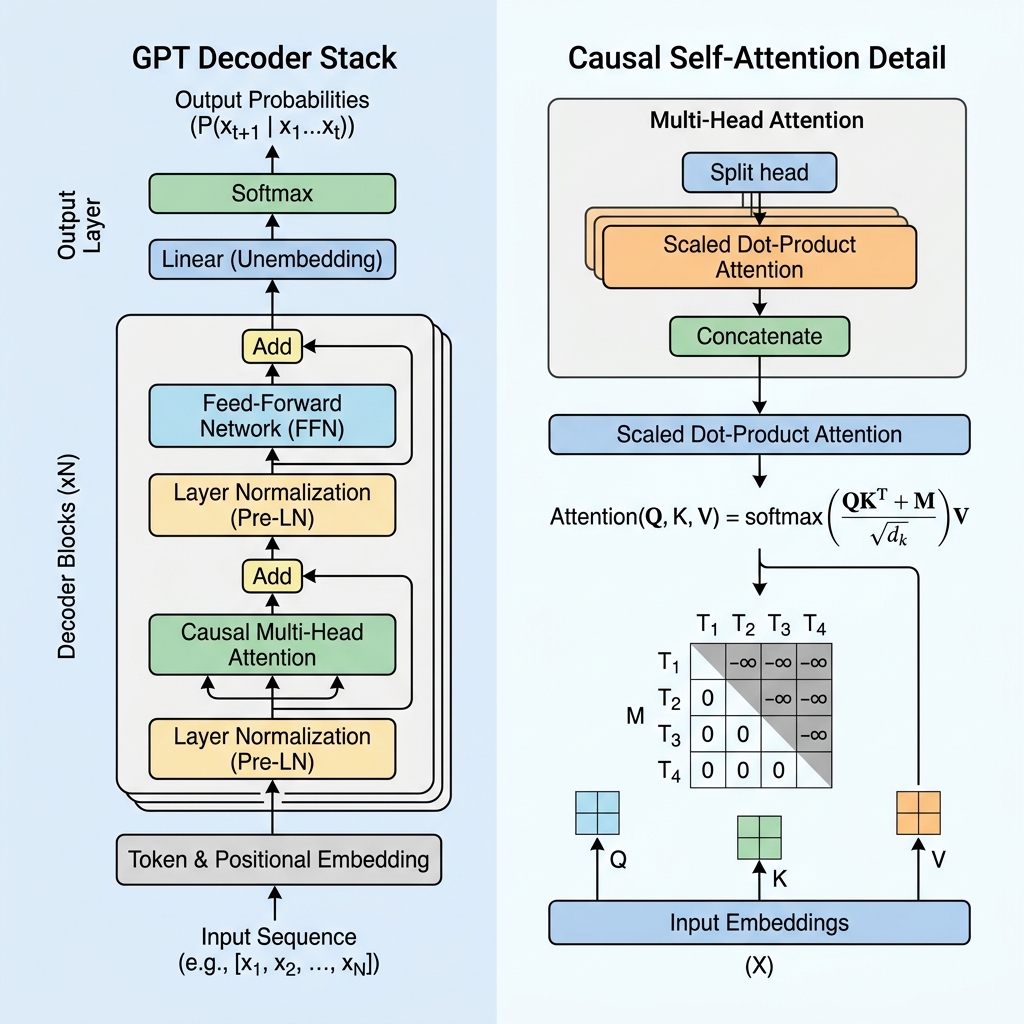
Negli ultimi anni, i Generative Pre-trained Transformers (GPT) hanno rivoluzionato l’intelligenza artificiale. Dagli assistenti di programmazione agli agenti conversazionali, i modelli basati su GPT alimentano oggi le applicazioni generative più avanzate. Ma come funziona effettivamente questa tecnologia? Mentre modelli come BERT utilizzano la parte Encoder del Transformer per comprendere il testo in modo bidirezionale, GPT è un’architettura Decoder-only progettata per la previsione autoregressiva del token successivo. In questo blog demistificheremo il funzionamento del GPT Transformer, approfondiremo il meccanismo di causal self-attention e lo implementeremo nel codice.
GPT Transformer IA Generativa Attenzione Causale NLP
Perché i Transformer hanno sostituito le reti RNN e LSTM

Perché i Transformer hanno sostituito le reti RNN e LSTM

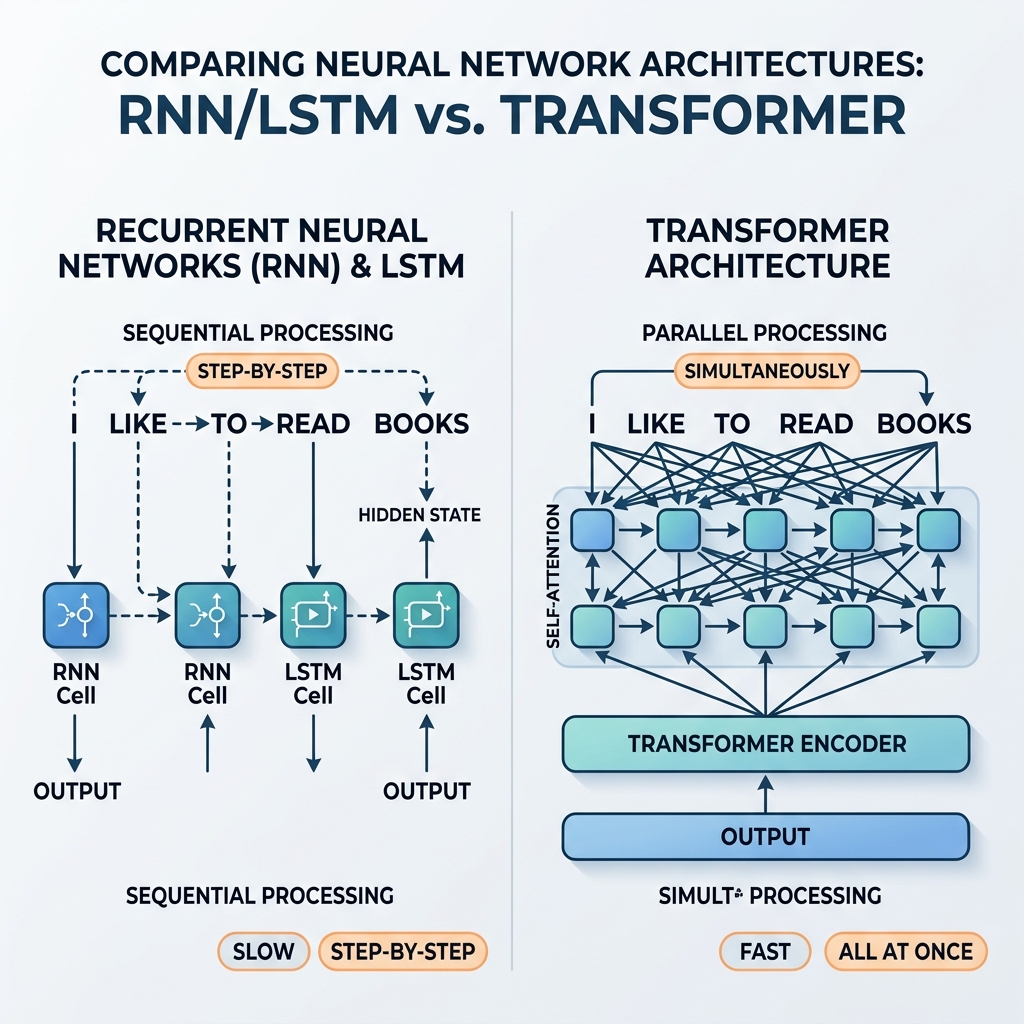
Per anni, le reti neurali ricorrenti (RNN) e le reti Long Short-Term Memory (LSTM) sono state le campionesse indiscusse dell’elaborazione di dati sequenziali. Hanno alimentato sistemi di traduzione all’avanguardia, assistenti vocali e modelli di generazione del testo. Tuttavia, nel 2017, l’articolo seminale “Attention Is All You Need” (Vaswani et al.) ha introdotto l’architettura Transformer. Nel giro di pochi anni, RNN e LSTM sono state quasi interamente eliminate dai modelli di intelligenza artificiale tradizionali.
Transformer RNN LSTM NLP Deep Learning
Comprendere BERT: Rappresentazioni dell'Encoder Bidirezionale dai Transformer

Comprendere BERT: Rappresentazioni dell'Encoder Bidirezionale dai Transformer

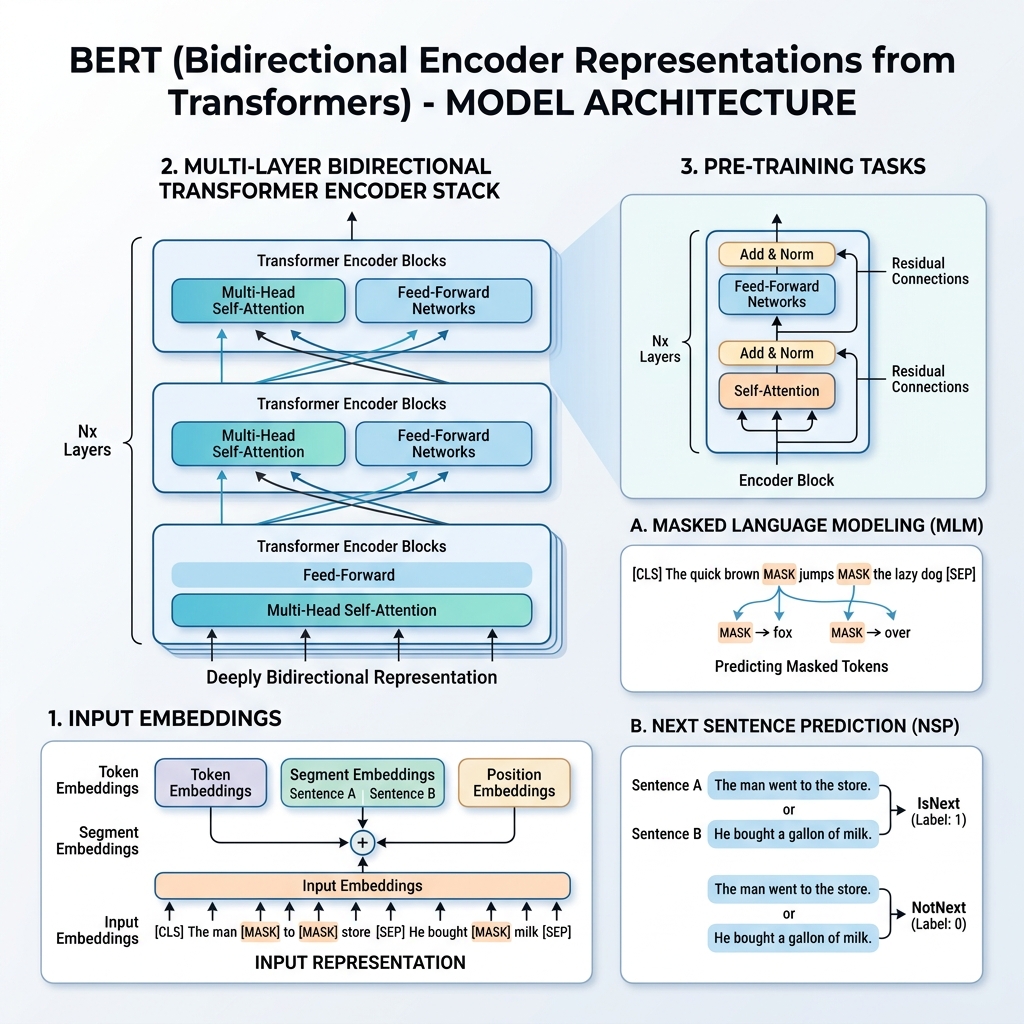
Nel 2018, i ricercatori di Google hanno pubblicato un articolo fondamentale intitolato “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding” (Devlin et al.). Questa ricerca ha cambiato radicalmente il campo del Natural Language Processing (NLP). Prima di BERT, i modelli elaboravano il testo sequenzialmente da sinistra a destra o da destra a sinistra. BERT ha introdotto un metodo per addestrare rappresentazioni linguistiche che guardano contemporaneamente al contesto da entrambe le direzioni.
BERT Transformer NLP Deep Learning Architettura IA
Comprendere le reti Transformer e il meccanismo di Self-Attention

Comprendere le reti Transformer e il meccanismo di Self-Attention

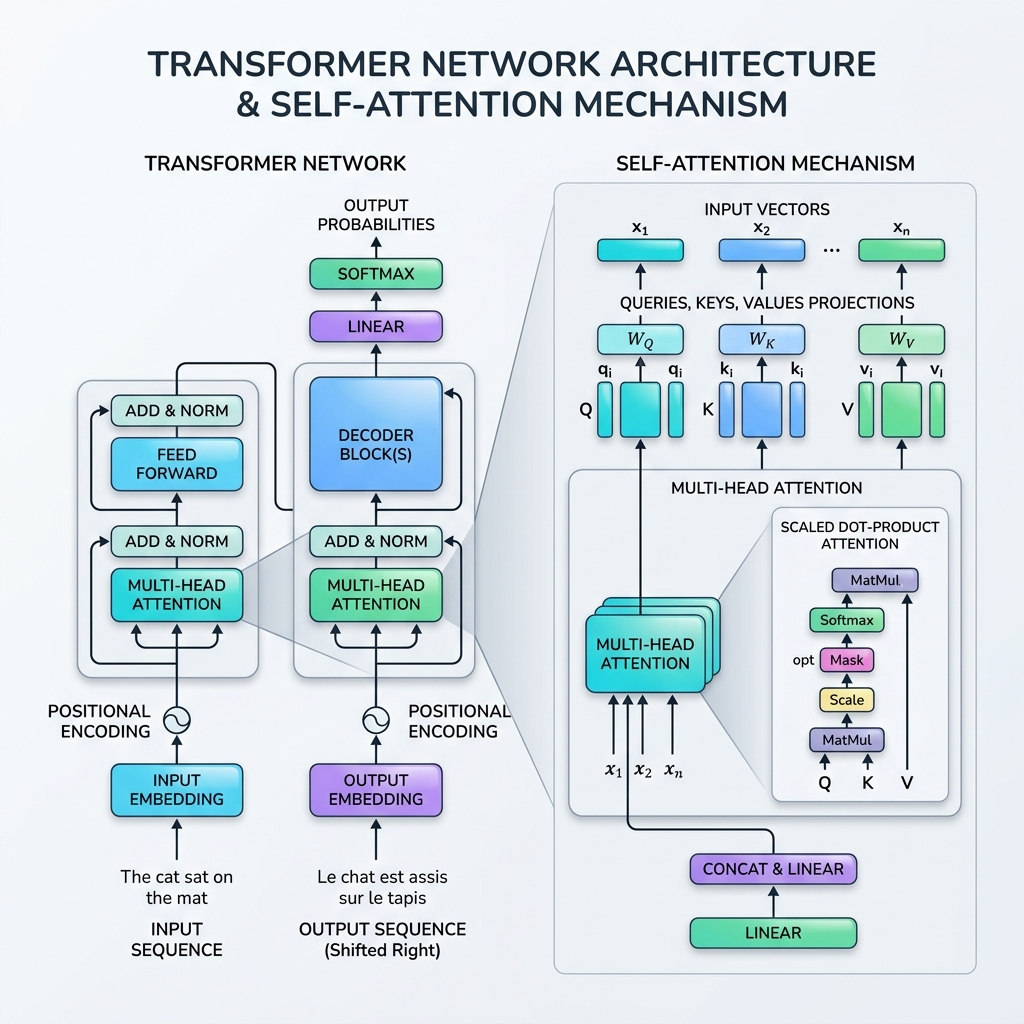
Nel 2017, il panorama dell’intelligenza artificiale è cambiato per sempre con la pubblicazione del seminale articolo “Attention Is All You Need” di Vaswani et al. L’articolo ha introdotto il Transformer, una rivoluzionaria architettura di rete neurale che ha abbandonato completamente la ricorrenza (RNN, LSTM), optando invece per l’elaborazione in parallelo di dati sequenziali tramite il Meccanismo di Self-Attention.
Transformer Self-Attention Deep Learning NLP Architettura IA
Demistificare l'Architettura Sequence-to-Sequence e il Meccanismo di Attenzione

Demistificare l'Architettura Sequence-to-Sequence e il Meccanismo di Attenzione

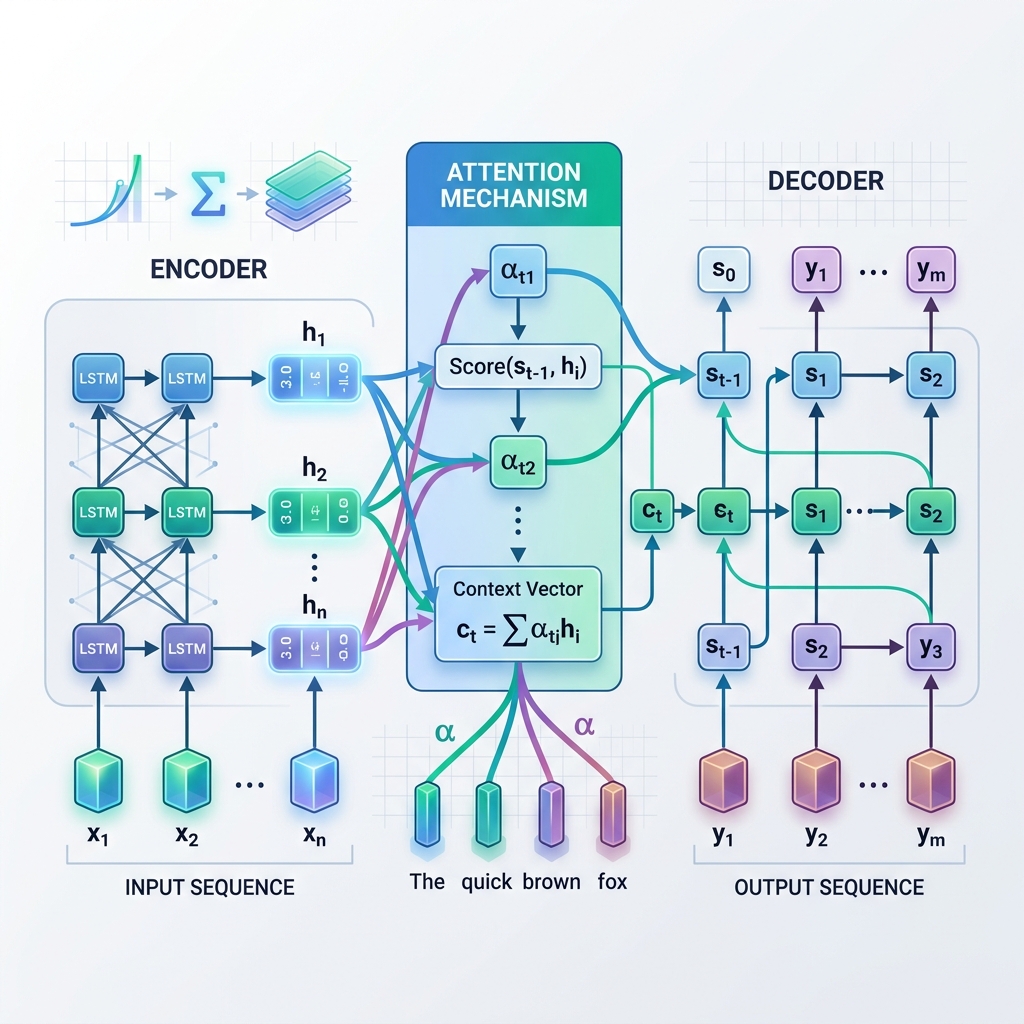
Nel panorama del Natural Language Processing (NLP) e dell’intelligenza artificiale, la capacità di tradurre lingue, riassumere articoli e generare risposte conversazionali ha subito una rivoluzione. Al centro di questa trasformazione si trovano l’architettura Sequence-to-Sequence (Seq2Seq) e il pionieristico Meccanismo di Attenzione. Prima dell’avvento dei moderni Transformer, queste due innovazioni hanno risolto una delle più grandi sfide del deep learning: mappare sequenze di input su sequenze di output quando le loro lunghezze differiscono.
Seq2Seq Meccanismo di Attenzione Deep Learning NLP Intelligenza Artificiale
Analisi del Sentiment in Arabo: Una Guida Pratica alla Pre-elaborazione NLP e ai Modelli

Analisi del Sentiment in Arabo: Una Guida Pratica alla Pre-elaborazione NLP e ai Modelli

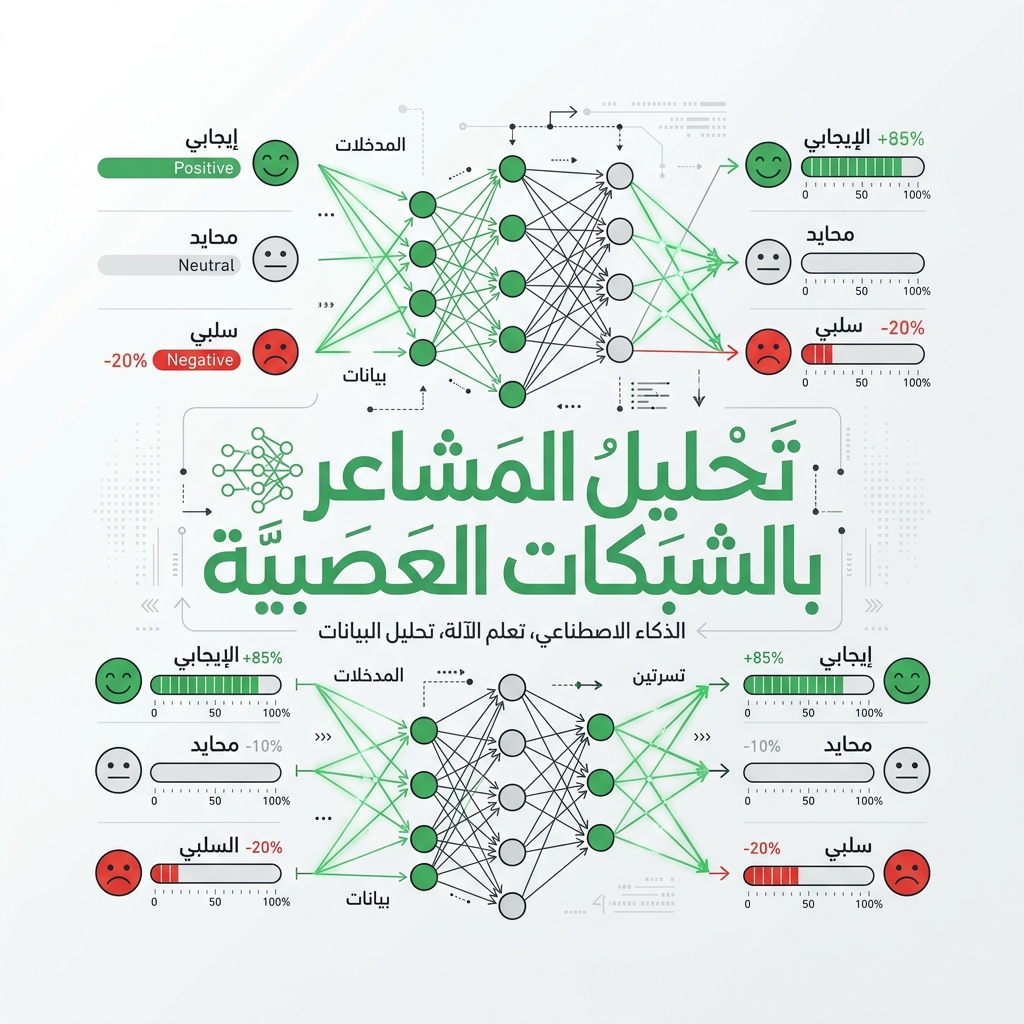
Nell’era della comunicazione digitale globalizzata, l’analisi del sentiment (il compito di identificare il tono emotivo dietro un testo) è diventata cruciale per aziende, governi e ricercatori. Sebbene l’analisi del sentiment sia altamente matura per lingue come l’inglese, l’applicazione all’arabo presenta una serie unica di sfide linguistiche e tecniche. Con oltre 400 milioni di parlanti, l’arabo è una delle lingue più parlate al mondo. Tuttavia, la sua ricca struttura morfologica, la diglossia (coesistenza di forme standard e colloquiali) e il complesso sistema di scrittura richiedono strategie di pre-elaborazione e modellazione specializzate.
Elaborazione del Linguaggio Naturale NLP Analisi del Sentiment IA Araba Transformers Python Machine Learning