🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

NLP

Eigennamenerkennung (NER): Von der klassischen NLP zur KI-gestützten Extraktion

Eigennamenerkennung (NER): Von der klassischen NLP zur KI-gestützten Extraktion

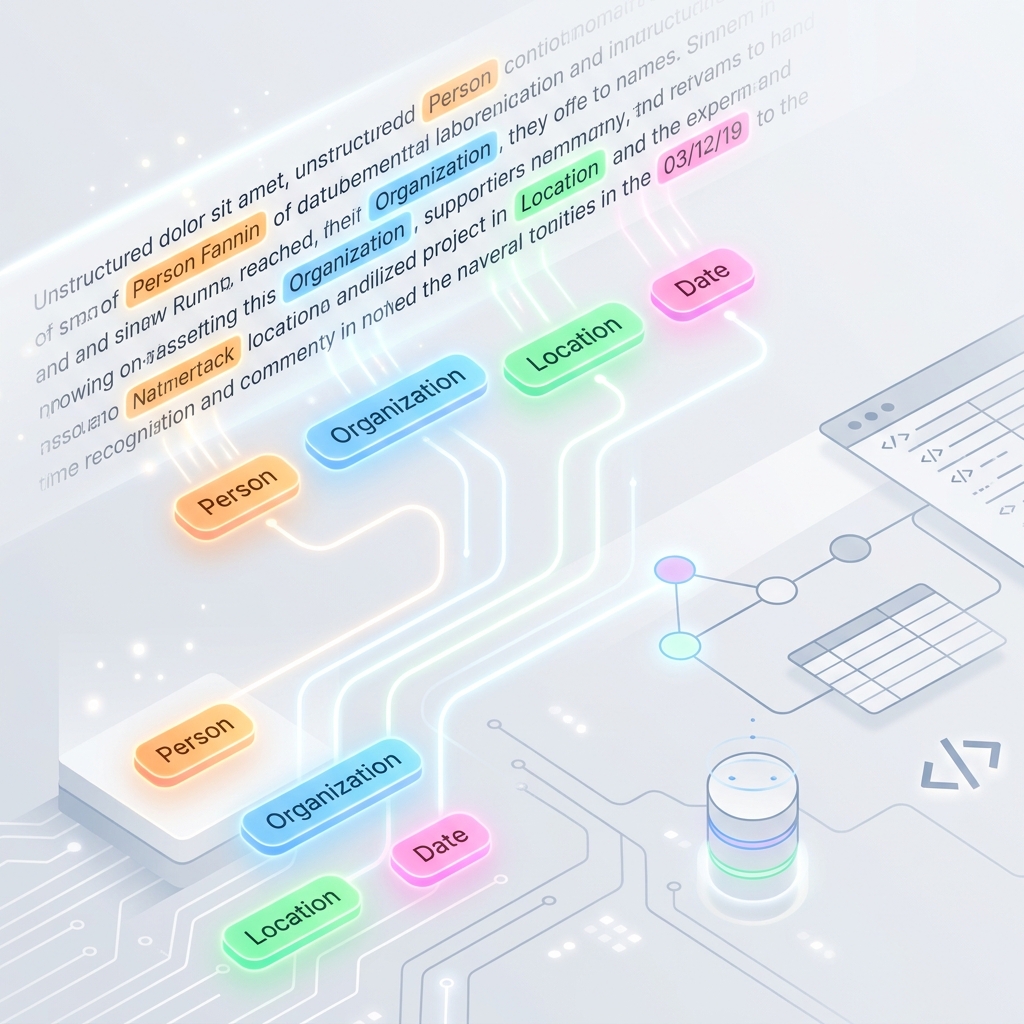
Die Eigennamenerkennung (Named Entity Recognition, kurz NER) ist ein Eckpfeiler der natürlichen Sprachverarbeitung (Natural Language Processing, NLP). Es handelt sich dabei um den Prozess, bei dem wichtige Elemente in unstrukturiertem Text automatisch identifiziert und in vordefinierte Kategorien eingeteilt werden – wie etwa Personennamen, Organisationen, Orte, Daten, Geldbeträge und Produktnamen. Ohne NER würden Suchmaschinen, Empfehlungsdienste und automatisierte Dokumentenanalysesysteme Schwierigkeiten haben zu verstehen, wer, was, wo und wann in einem Text gemeint ist.
KI NER NLP Maschinelles Lernen Große Sprachmodelle
Wie der GPT-Transformer funktioniert: Kausale Self-Attention erklärt

Wie der GPT-Transformer funktioniert: Kausale Self-Attention erklärt

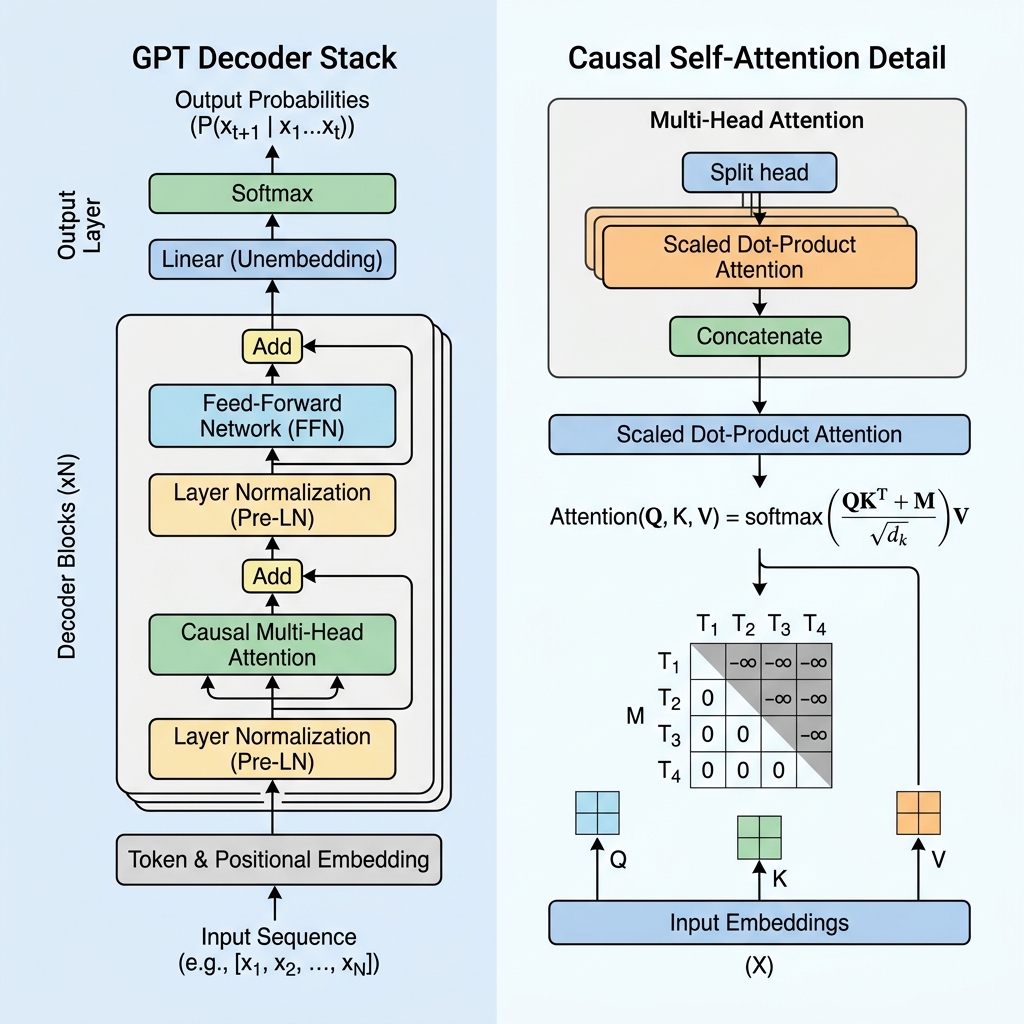
In den letzten Jahren haben Generative Pre-trained Transformers (GPT) die künstliche Intelligenz revolutioniert. Von Programmierassistenten bis hin zu Konversationsagenten treiben GPT-basierte Modelle heute die fortschrittlichsten generativen Anwendungen an. Aber wie funktioniert diese Technologie eigentlich? Während Modelle wie BERT den Encoder-Teil des Transformers nutzen, um Text bidirektional zu verstehen, ist GPT eine Decoder-only-Architektur, die für die autoregressive Vorhersage des nächsten Tokens konzipiert ist. In diesem Blog werden wir die Funktionsweise des GPT-Transformers entmystifizieren, tief in den kausalen Self-Attention-Mechanismus eintauchen und ihn im Code implementieren.
GPT Transformer Generative KI Kausale Attention NLP
Warum Transformer RNNs und LSTMs abgelöst haben

Warum Transformer RNNs und LSTMs abgelöst haben

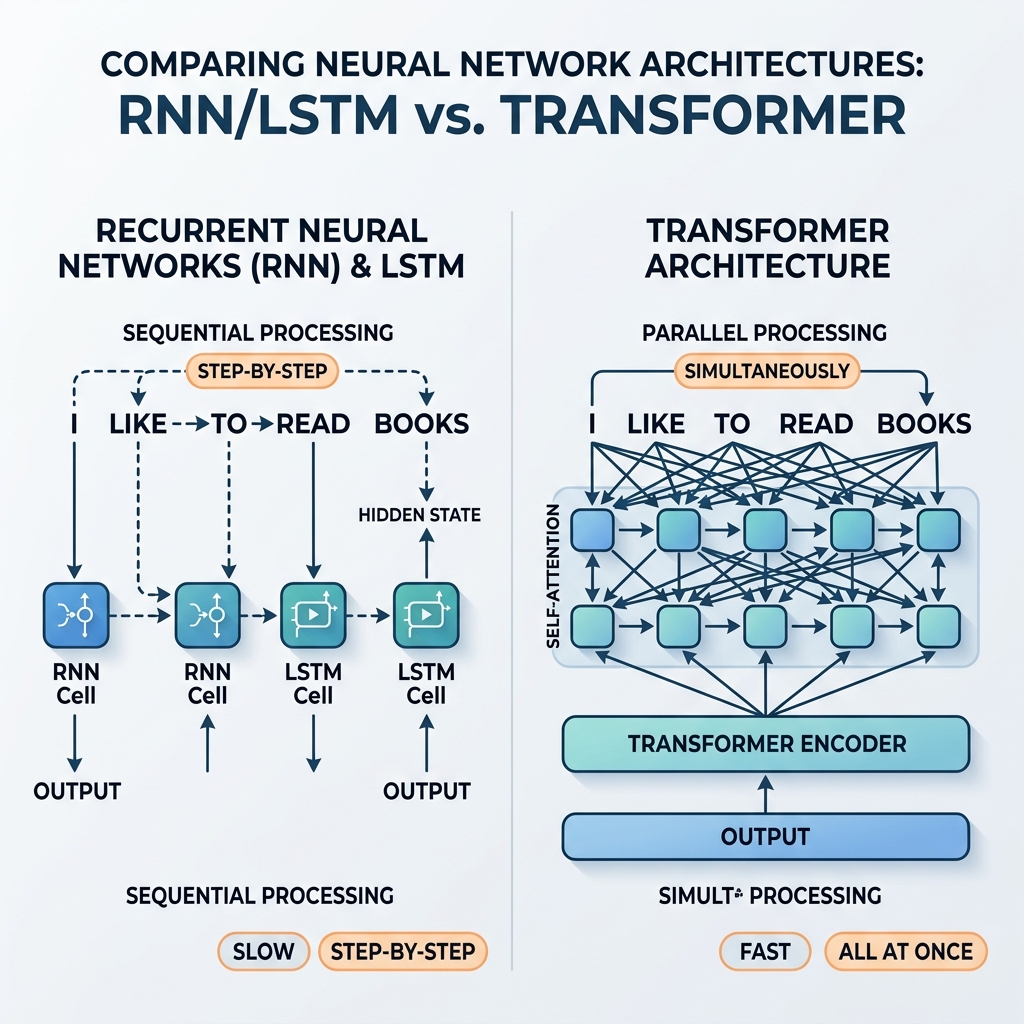
Jahrelang waren Recurrent Neural Networks (RNNs) und Long Short-Term Memory (LSTM) Netzwerke die unbestrittenen Champions der sequentiellen Datenverarbeitung. Sie trieben modernste Übersetzungssysteme, Sprachassistenten und Textgenerierungsmodelle an. Im Jahr 2017 führte das bahnbrechende Paper „Attention Is All You Need“ (Vaswani et al.) jedoch die Transformer-Architektur ein. Innerhalb weniger Jahre wurden RNNs und LSTMs fast vollständig aus den gängigen KI-Modellen verdrängt.
Transformer RNN LSTM NLP Deep Learning
BERT verstehen: Bidirektionale Encoder-Repräsentationen aus Transformern

BERT verstehen: Bidirektionale Encoder-Repräsentationen aus Transformern

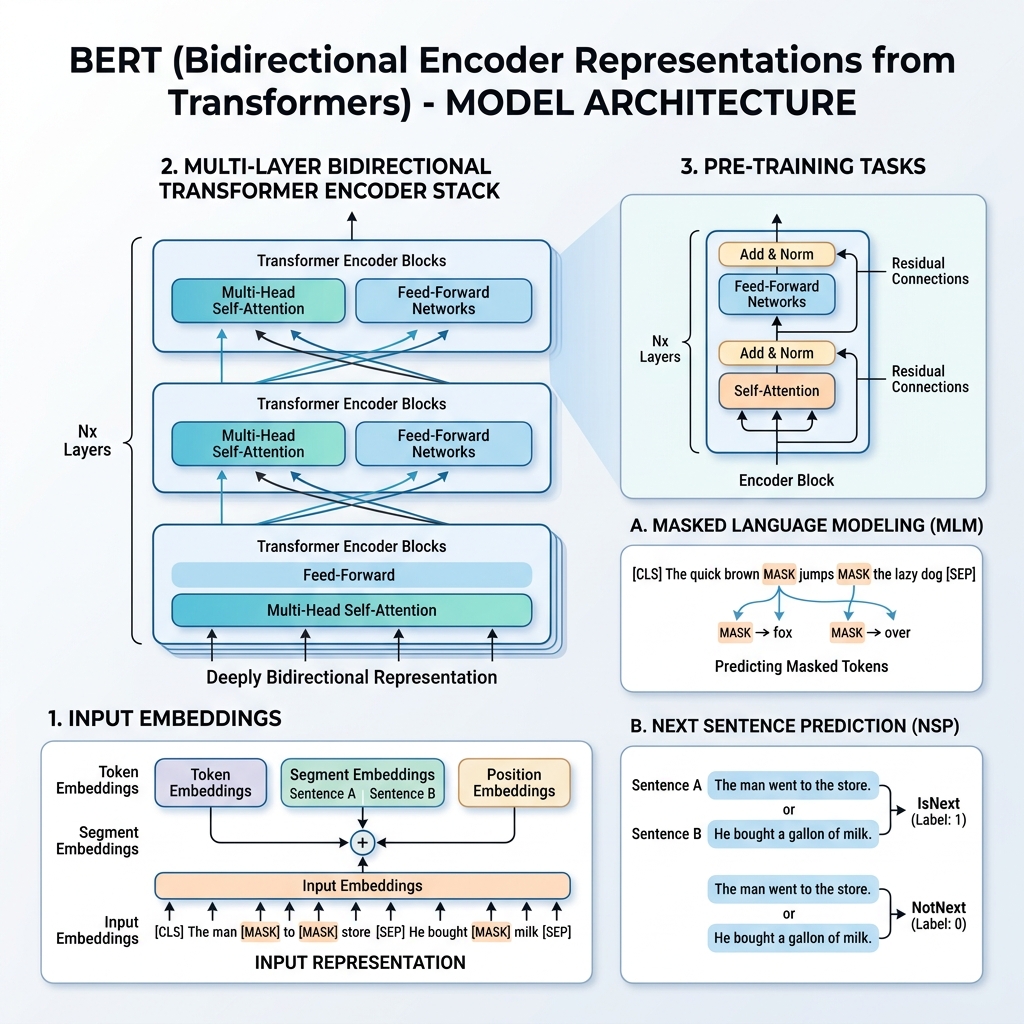
Im Jahr 2018 veröffentlichten Google-Forscher ein bahnbrechendes Paper mit dem Titel „BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding“ (Devlin et al.). Diese Arbeit hat das Feld der natürlichen Sprachverarbeitung (NLP) grundlegend verändert. Vor BERT verarbeiteten Modelle Text sequentiell von links nach rechts oder von rechts nach links. BERT führte eine Methode ein, um Sprachdarstellungen zu trainieren, die den Kontext aus beiden Richtungen gleichzeitig betrachten.
BERT Transformer NLP Deep Learning KI-Architektur
Transformer-Netzwerke und den Self-Attention-Mechanismus verstehen

Transformer-Netzwerke und den Self-Attention-Mechanismus verstehen

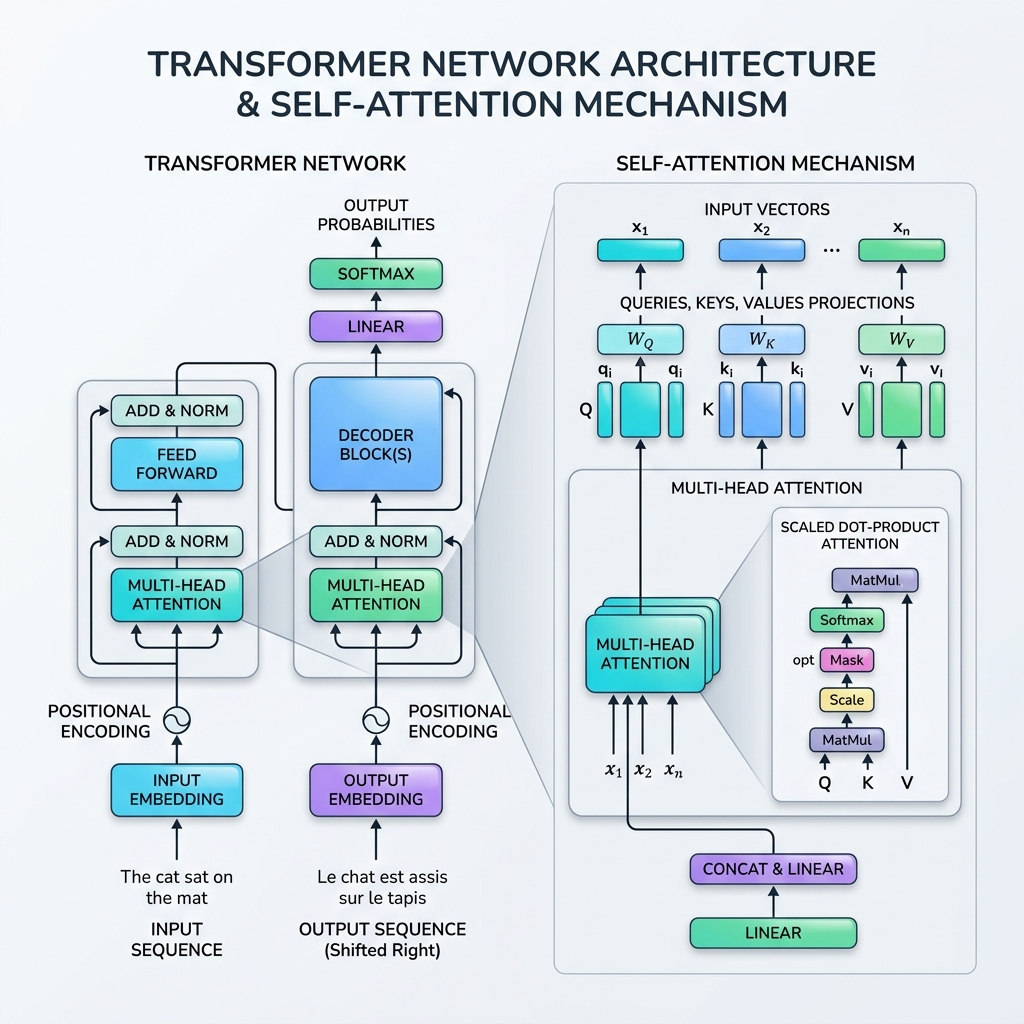
Im Jahr 2017 veränderte sich die Landschaft der künstlichen Intelligenz durch die Veröffentlichung des bahnbrechendenden Papers „Attention Is All You Need“ von Vaswani et al. für immer. Das Paper stellte den Transformer vor, eine revolutionäre neuronale Netzwerkarchitektur, die Rekursion (RNNs, LSTMs) vollständig verwarf und sich stattdessen dafür entschied, sequentielle Daten mithilfe des Self-Attention-Mechanismus parallel zu verarbeiten.
Transformer Self-Attention Deep Learning NLP KI-Architektur
Demystifizierung der Sequence-to-Sequence-Architektur und des Attention-Mechanismus

Demystifizierung der Sequence-to-Sequence-Architektur und des Attention-Mechanismus

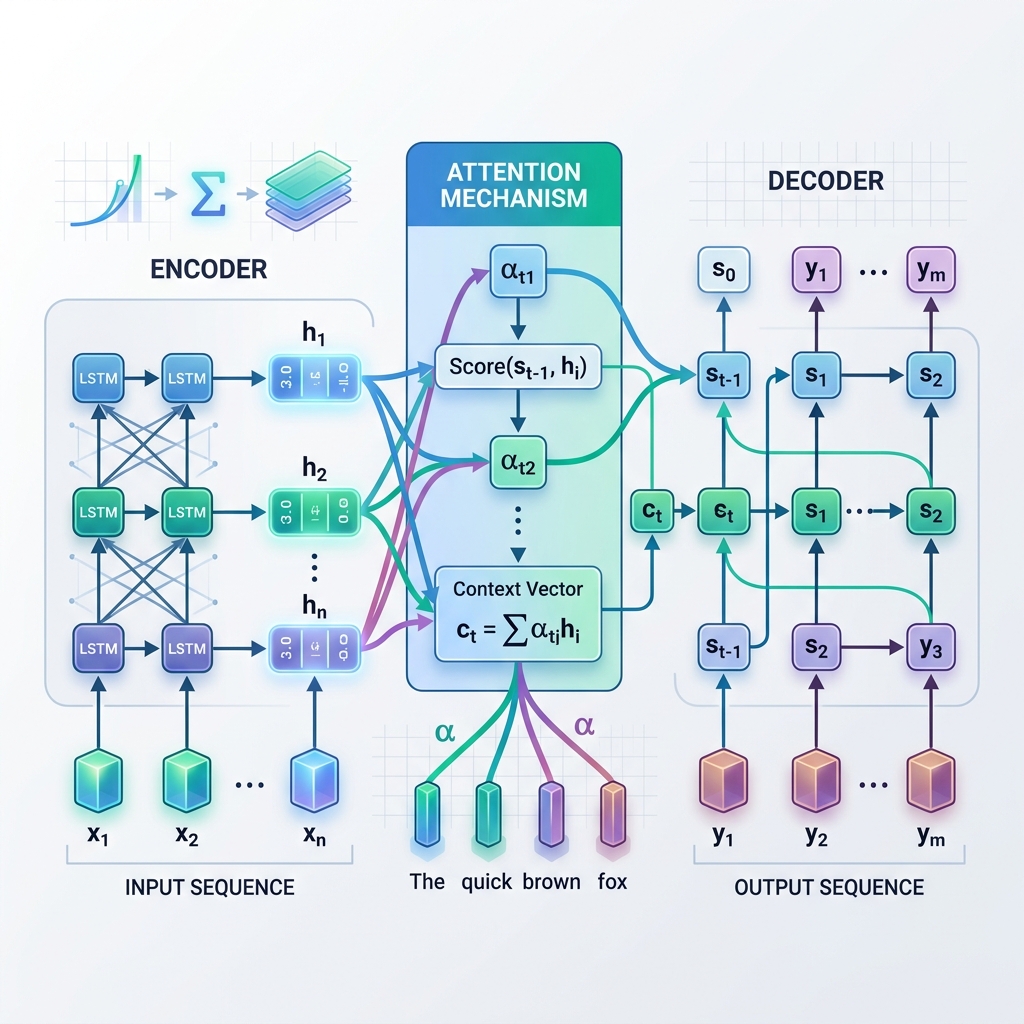
In der Landschaft der natürlichen Sprachverarbeitung (NLP) und der künstlichen Intelligenz hat die Fähigkeit, Sprachen zu übersetzen, Artikel zusammenzufassen und Konversationsantworten zu generieren, eine Revolution erfahren. Im Herzen dieser Transformation liegt die Sequence-to-Sequence (Seq2Seq) Architektur und der wegweisende Attention-Mechanismus. Vor dem Aufkommen moderner Transformer lösten diese beiden Innovationen eine der größten Herausforderungen des Deep Learning: die Abbildung von Eingabesequenzen auf Ausgabesequenzen bei unterschiedlichen Längen.
Seq2Seq Attention-Mechanismus Deep Learning NLP Künstliche Intelligenz
Arabische Sentiment-Analyse: Ein praktischer NLP-Vorverarbeitungs- und Modell-Walkthrough

Arabische Sentiment-Analyse: Ein praktischer NLP-Vorverarbeitungs- und Modell-Walkthrough

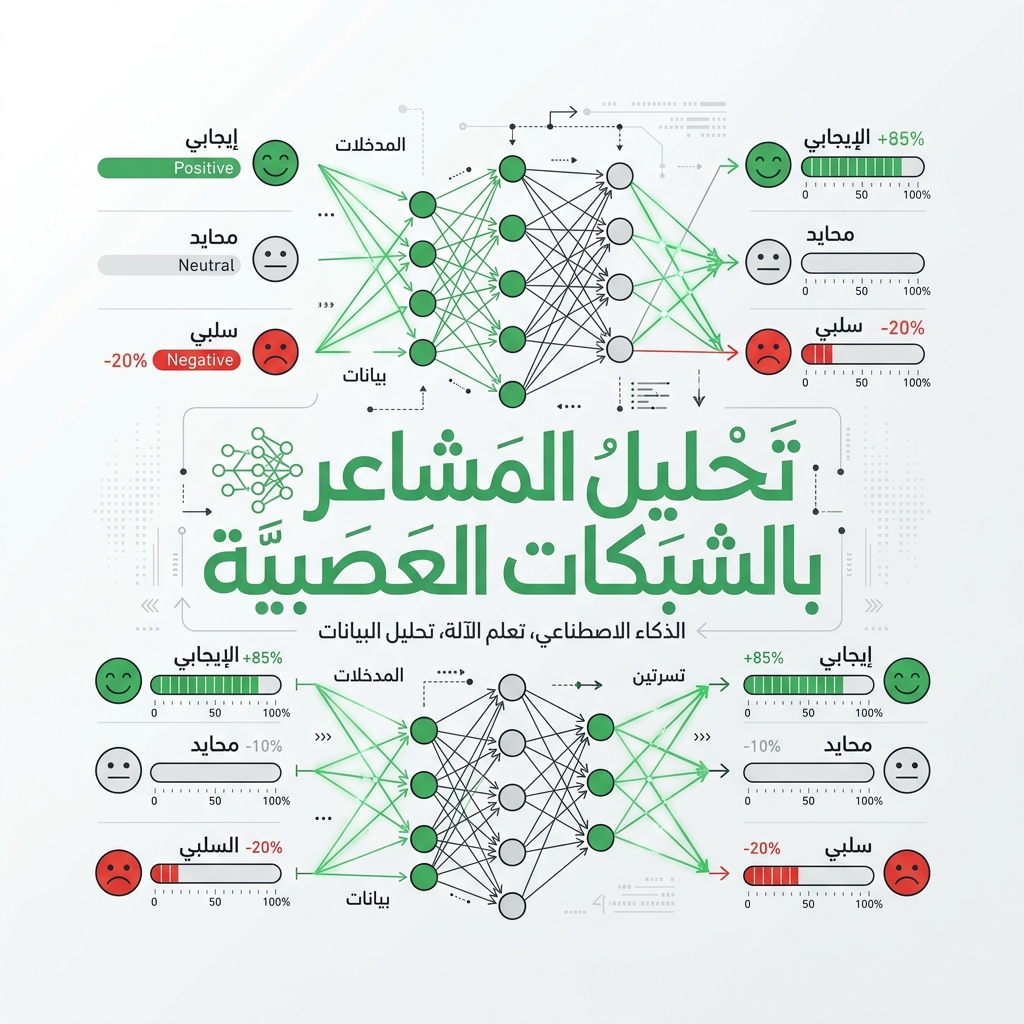
Im Zeitalter der globalisierten digitalen Kommunikation ist die Sentiment-Analyse – die Aufgabe, den emotionalen Ton hinter einem Textkörper zu identifizieren – für Unternehmen, Regierungen und Forscher von entscheidender Bedeutung geworden. Während die Sentiment-Analyse für Sprachen wie Englisch hochentwickelt ist, stellt die Anwendung auf das Arabische eine einzigartige Reihe von linguistischen und technischen Herausforderungen dar. Mit über 400 Millionen Spregern ist Arabisch eine der am weitesten verbreiteten Sprachen der Welt. Seine reiche morphologische Struktur, Diglossie (Koexistenz von Standard- und Umgangsformen) und sein komplexes Schriftsystem erfordern jedoch spezialisierte Vorverarbeitungs- und Modellierungsstrategien.
Natuerliche Sprachverarbeitung NLP Sentiment-Analyse Arabische KI Transformers Python Maschinelles Lernen