🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

自然语言处理

命名实体识别 (NER):从传统自然语言处理到 AI 驱动的数据提取

命名实体识别 (NER):从传统自然语言处理到 AI 驱动的数据提取

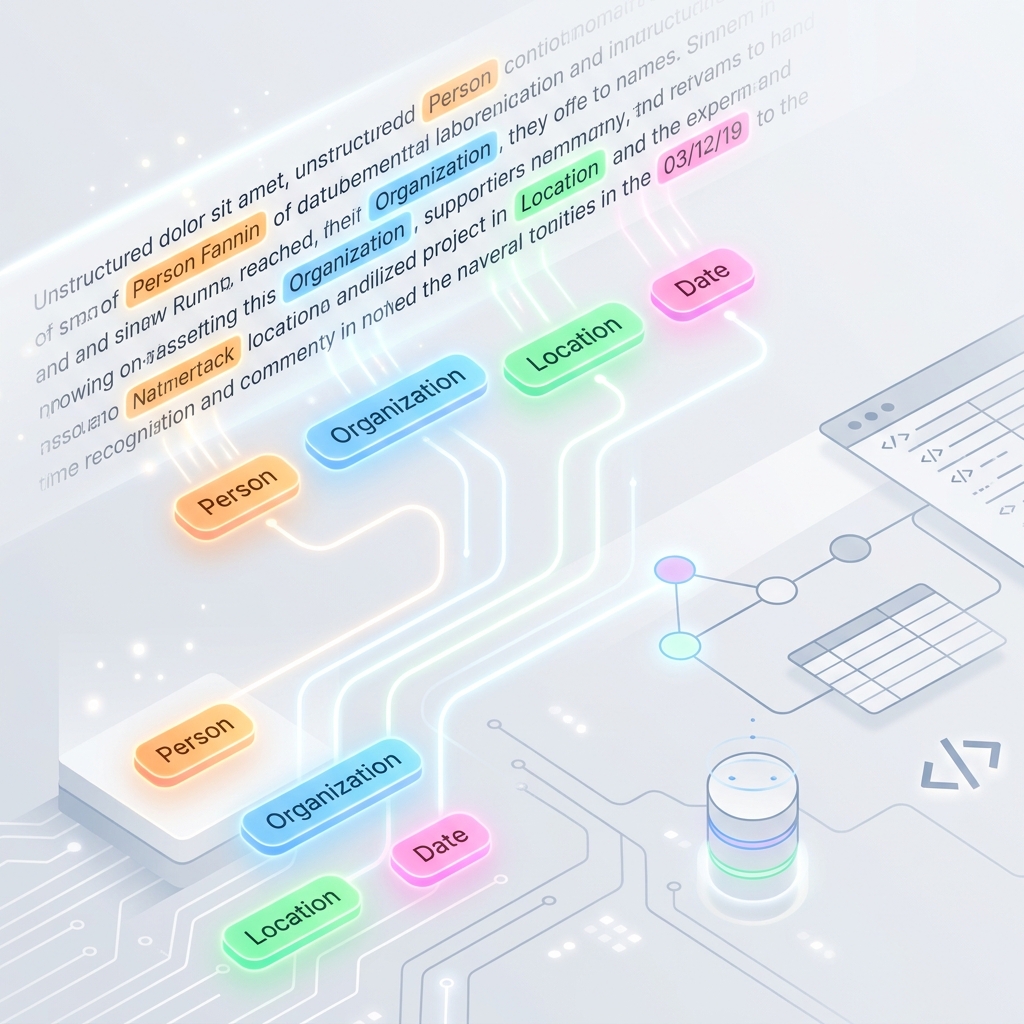
命名实体识别 (Named Entity Recognition,简称 NER) 是自然语言处理 (NLP) 的基石之一。它是从非结构化文本中自动识别关键元素,并将其归类到预定义类别(如人名、组织机构名、地理位置、日期、货币数值以及产品名称)的过程。 如果没有 NER,搜索引擎、推荐系统和自动化文档分析系统将很难理解文本中包含的“人、事、时、地”等核心信息。 本指南将带您全面了解 NER 的定义、该技术的发展历程,以及为什么现代生成式 AI 彻底改变了实体提取的方式。 1. NER 技术的发展演变 为了理解为什么基于 AI 的 NER 具有如此革命性的意义,我们需要回顾过去几十年来实体提取技术的发展阶段。 第一阶段:基于规则和词典的系统 早期的 NER 主要依赖于正则表达式 (Regex) 和人工整理的词典 (Gazetteers)。 工作原理:如果一个词存在于特定的地理位置数据库中,或者匹配某种模式(例如 [3位数字]-[3位数字]-[4位数字] 的电话号码),它就会被提取出来。 局限性:鲁棒性极差。它无法处理拼写错误、新出现的实体或上下文语义。例如,它无法区分 “Apple” 指的是水果还是这家科技公司。 第二阶段:传统 machine learning (CRF 与 SVM) 在 21 世纪初,条件随机场 (CRF) 和支持向量机 (SVM) 等统计机器学习模型成为了行业标准。 工作原理:工程师需要手动提取特征(例如前缀、后缀、大小写模式),并使用标注数据训练模型,以预测某个 Token 属于特定实体的概率。 局限性:需要大量的标注数据集,且手动特征工程非常繁琐耗时。 第三阶段:深度学习 (BiLSTM-CRF 与 BERT) 随着深度学习的兴起,双向长短期记忆网络 (BiLSTM) 结合 CRF,以及后来的 Transformer 模型(如 BERT)彻底改变了 NLP 领域。
人工智能 命名实体识别 自然语言处理 机器学习 大语言模型
GPT Transformer 如何工作:因果自注意力机制解析

GPT Transformer 如何工作:因果自注意力机制解析

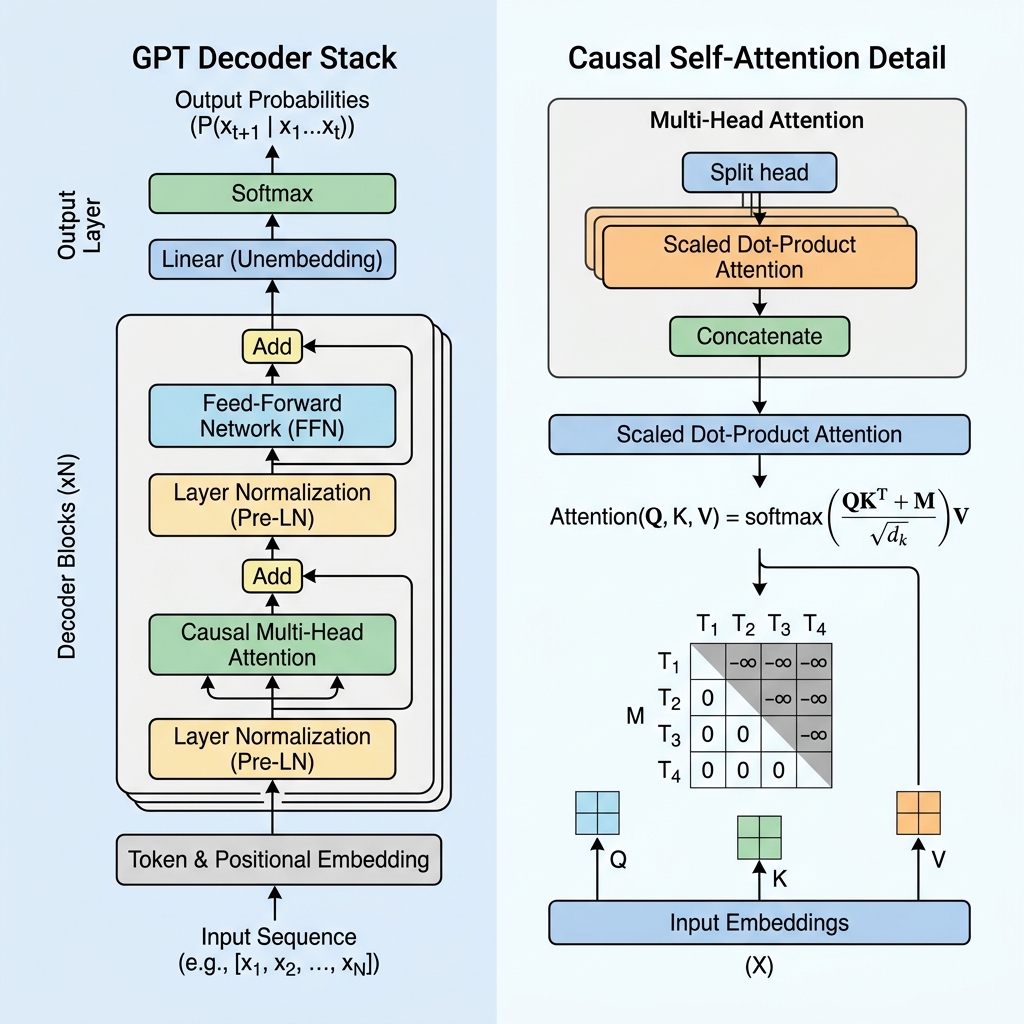
近年来,生成式预训练 Transformer(GPT)彻底改变了人工智能。从代码助手到对话智能体,基于 GPT 的模型正在为当今最先进的生成式应用提供动力。但是这项技术究竟是如何工作的呢? 虽然像 BERT 这样的模型使用 Transformer 的**编码器(Encoder)部分来双向理解文本,但 GPT 采用的是仅解码器(Decoder-only)**的架构,专为自回归的下一 token 预测而设计。在本文中,我们将揭秘 GPT Transformer 的工作原理,深入探讨因果自注意力(Causal Self-Attention)机制,并在代码中对其进行实现。 1. 自回归生成循环 在核心层面,GPT 是一个自回归模型。这意味着要生成一段文本序列,它会一个接一个地预测下一个 token,并使用已生成的 token 作为下一次预测的上下文。 其工作流程遵循以下步骤: 输入: 模型接收一个提示词(prompt):"Deep learning is"。 预测: 模型处理该提示,并在其整个词汇表上输出一个概率分布。它对下一个 token 进行采样:"awesome"。 循环: 新生成的 token 被追加到输入中,使其变为:"Deep learning is awesome"。这个新序列成为下一步的输入。 终止: 重复该过程,直到模型输出特殊的序列结束符([EOS])或达到预设的长度限制。 2. 因果掩码:解码器的核心 在像 BERT 这样仅包含编码器的模型中,每个 token 都可以关注所有其他 token,同时回顾过去并展望未来。然而,对于预测下一个 token 的生成式模型来说,在训练期间看到未来的 token 属于“作弊”。 为了防止模型看到未来的 token, GPT 使用了因果自注意力机制(或称掩码自注意力机制)。
GPT Transformer 生成式AI 因果注意力 自然语言处理
为什么 Transformer 取代了 RNN 和 LSTM

为什么 Transformer 取代了 RNN 和 LSTM

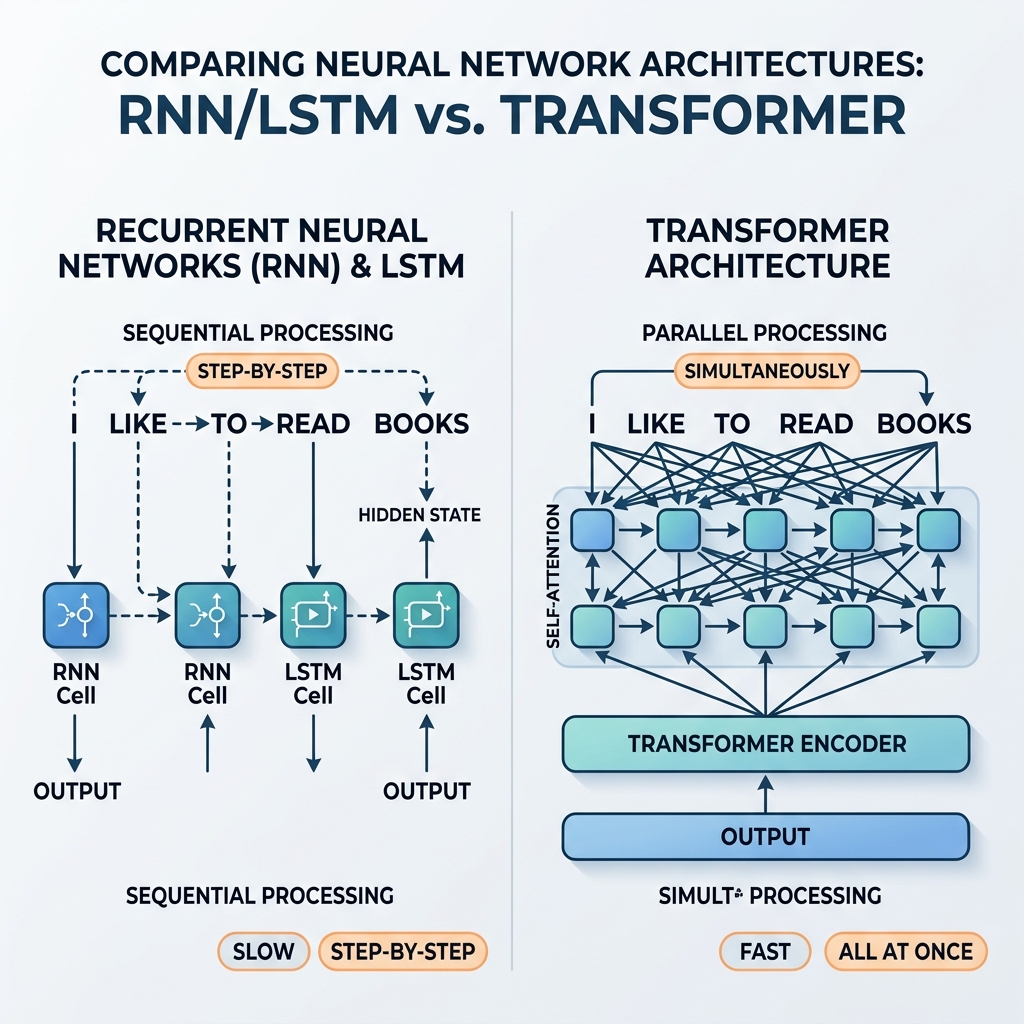
多年来,循环神经网络(RNN)和长短期记忆网络(LSTM)一直是序列数据处理领域无可争议的霸主。它们为最先进的翻译系统、语音助手和文本生成模型提供了强大的技术支持。然而,在 2017 年,一篇名为 “Attention Is All You Need”(Vaswani 等人)的里程碑式论文引入了 Transformer 架构。在短短几年内,RNN 和 LSTM 几乎完全退出了主流 AI 模型的舞台。 为什么会发生如此快速的转变?是什么让 Transformer 在结构上比循环网络更具优势?本文将探讨 RNN/LSTM 的数学和架构瓶颈,以及 Transformer 是如何克服它们的。 1. 核心瓶颈:串行限制 RNN 的决定性特征是其递归状态转换。为了处理输入序列,网络一步一步地处理每个 token,根据当前输入 $x_t$ 和前一个隐状态 $h_{t-1}$ 来更新其内部隐状态 $h_t$。 数学上的递推关系表示为: $$h_t = \tanh(W_{hh} h_{t-1} + W_{xh} x_t + b)$$ 并行化问题 由于 $h_t$ 直接依赖于 $h_{t-1}$,处理过程无法并行化。要计算一个句子中第 100 个单词的状态,网络必须顺序计算前 99 个状态。 随着 GPU 和 TPU 的发展以支持海量的并行矩阵计算,这种串行依赖性成为了致命的瓶颈。在大型网络数据集上训练深度 RNN 模型需要数周时间,而如果计算相互独立,硬件本可以运行得快得多。
Transformers RNN LSTM 自然语言处理 深度学习
深入理解 BERT 模型:双向 Transformer 编码器表示

深入理解 BERT 模型:双向 Transformer 编码器表示

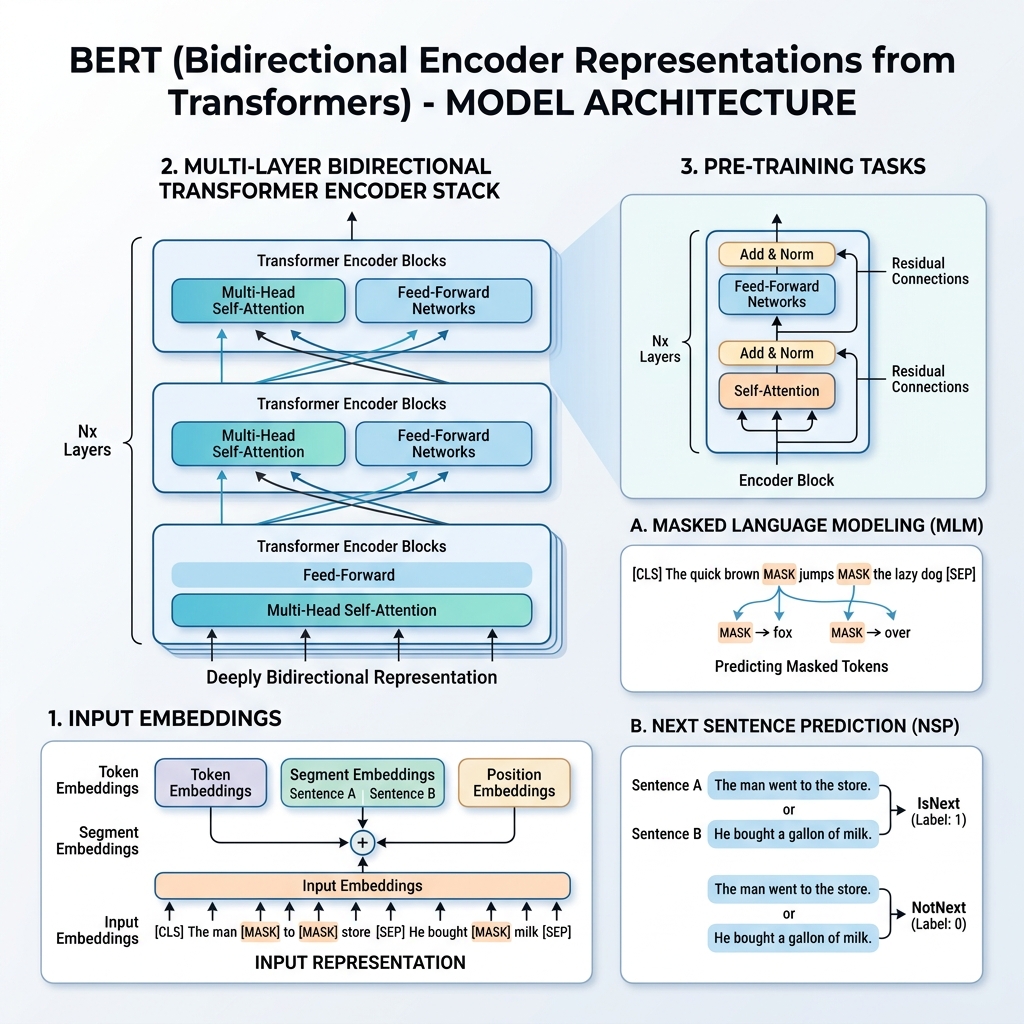
2018 年,Google 研究人员发表了一篇具有里程碑意义的论文,题为 “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding”(Devlin 等人)。这项研究彻底改变了自然语言处理(NLP)领域。在 BERT 之前,模型大多是自左向右或自右向左单向处理文本。BERT 引入了一种方法,可以同时从两个方向来训练语言表示。 今天,BERT 及其衍生模型(如 RoBERTa、DistilBERT 和 ALBERT)仍然是搜索引擎、情感分析、问答系统和信息提取的基石。本文将带您揭开 BERT 架构的神秘面纱,解析其工作原理和训练方式。 1. 什么是 BERT? BERT 的全称是 Bidirectional Encoder Representations from Transformers(基于 Transformers 的双向编码器表示)。让我们拆解一下这个名字: 双向(Bidirectional): 与从左到右(如 GPT)或从右到左读取文本的传统语言模型不同,BERT 一次性读取整个单词序列。这使它能够根据某个单词的整个上下文(左右两侧)来学习该单词的语义。 编码器表示(Encoder Representations): BERT 使用了原始 Transformer 架构中的**编码器(Encoder)**部分。它接收输入序列,并为每个 token 输出一个密集的向量表示(嵌入/embedding)。 Transformers: 其底层引擎是 Transformer 注意力网络,它能够对长距离依赖关系进行建模并支持并行计算。 双向表示的强大之处 在单向模型中,一个 token 只能关注之前的 token。例如在句子中: “他决定把钱存进银行(bank)。”
BERT Transformers 自然语言处理 深度学习 AI 架构
理解 Transformer 网络与自注意力(Self-Attention)机制

理解 Transformer 网络与自注意力(Self-Attention)机制

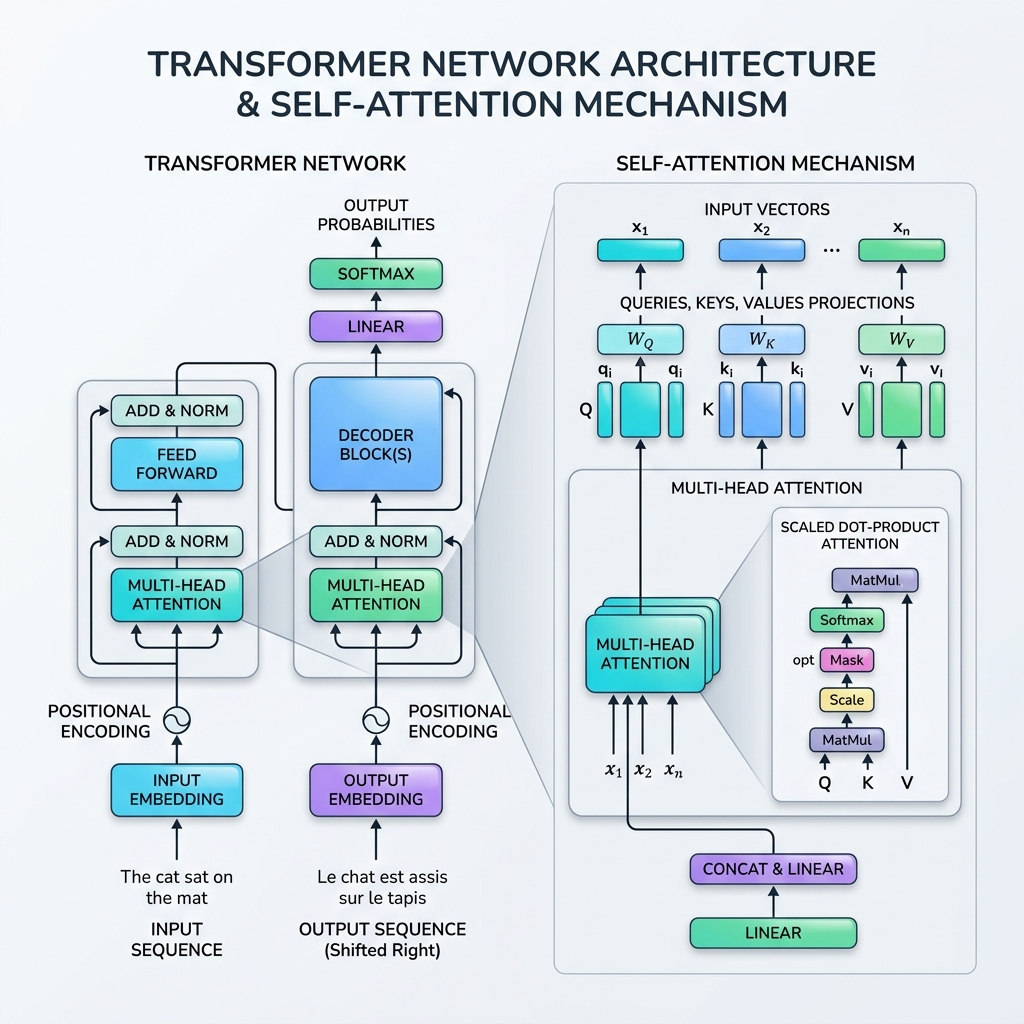
2017年,随着 Vaswani 等人发表了里程碑式的论文 《Attention Is All You Need》,人工智能领域发生了翻天覆地的变化。该论文引入了 Transformer,一种革命性的神经网络架构,它完全摒弃了循环结构(RNN、LSTM),转而使用**自注意力机制(Self-Attention Mechanism)**并行处理序列数据。 如今,Transformer 驱动着几乎所有最先进的大语言模型(LLM),包括 GPT-4、Gemini, Claude 和 Llama。本篇博客将揭开 Transformer 网络的神秘面纱,并从数学和实践的角度解析自注意力机制是如何实现的。 1. 串行处理的瓶颈(RNN 与 Transformer 的对比) 在 Transformer 出现之前,循环神经网络(RNN)和长短期记忆(LSTM)网络是序列建模的标准方法。然而,RNN 必须按顺序(一次处理一个词)处理 Token。为了计算第 10 个词的隐藏状态,模型必须先计算第 1 到第 9 个词的隐藏状态。 这种串行特性带来了两个严重的局限性: 无法并行化: 现代 GPU 的计算能力无法得到高效利用,因为每一步计算都必须等待上一步完成。 梯度消失/爆炸: 当模型处理到长序列的末尾时,序列开头的早期信息会被压缩并丢失(即瓶颈问题)。 Transformer 同时解决了这两个问题。通过用自注意力取代循环结构,Transformer 可以同时处理整个输入序列,实现了海量的并行化计算,并在序列中的任意两个 Token 之间建立直接联系,无论它们相距多远。 2. 什么是自注意力机制? 自注意力允许模型评估同一序列中不同词之间的关系。模型不再孤立地处理每个词,而是通过结合句子中所有其他词的上下文来表示当前词。 例如在以下句子中: “The bank of the river was muddy.”(河岸很泥泞。) “The money was deposited in the bank.”(钱存进了银行。) 单词“bank”根据上下文具有不同的含义。自注意力机制使模型能够在第一个句子中关注“river”(河流),在第二个句子中关注“money”(金钱),从而正确调整“bank”的特征表示。
Transformer 自注意力 深度学习 自然语言处理 AI架构
揭秘序列到序列(Seq2Seq)架构与注意力(Attention)机制

揭秘序列到序列(Seq2Seq)架构与注意力(Attention)机制

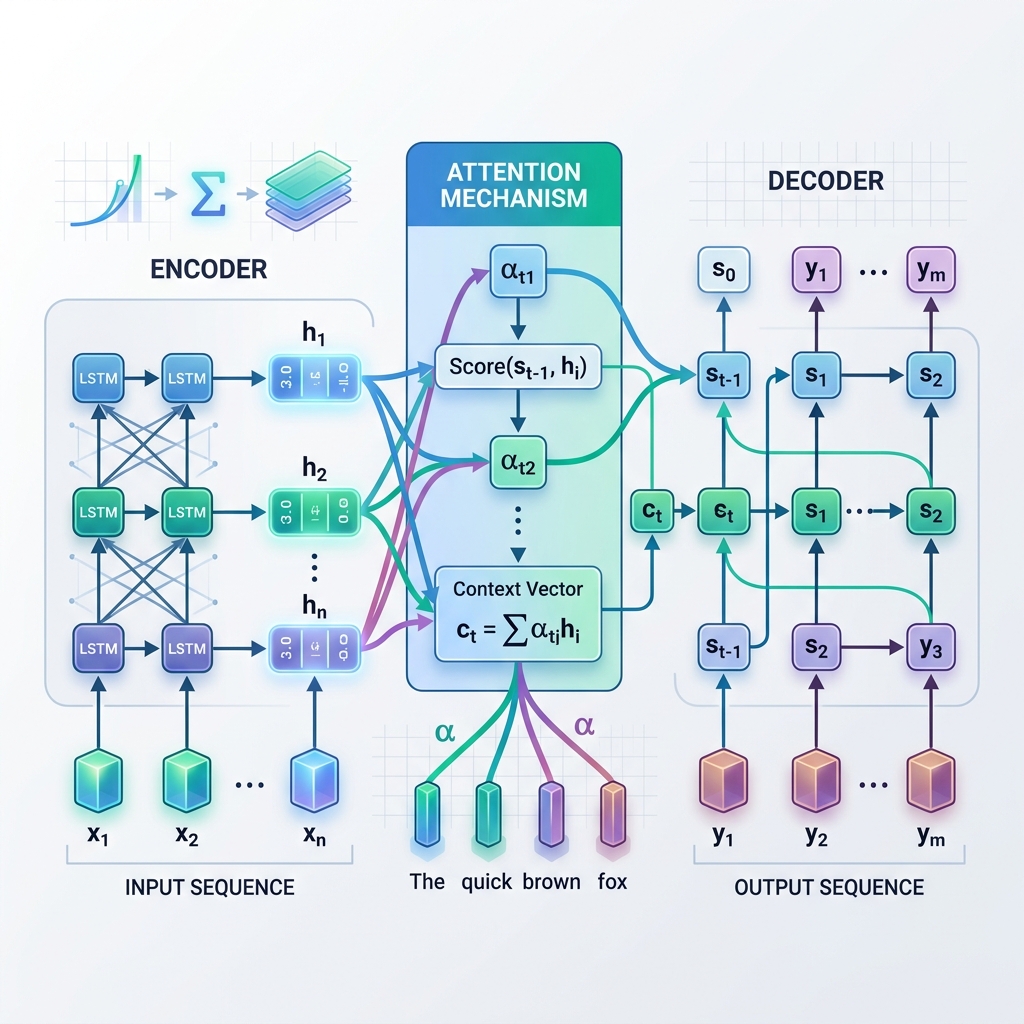
在自然语言处理(NLP)和人工智能领域,机器翻译、文本摘要以及对话生成等技术在过去几年中经历了一场革命。这场变革的核心正是序列到序列(Seq2Seq)架构以及开创性的注意力(Attention)机制。 在现代 Transformer 架构诞生之前,这两大创新解决了深度学习领域最棘手的挑战之一:在输入序列和输出序列长度不同时,如何建立它们之间的映射。 1. 理论奠基:什么是序列到序列(Seq2Seq)? 序列到序列(Seq2Seq)模型由谷歌等机构的研究人员于 2014 年提出,它是一种专门用于处理序列数据的编码器-解码器(Encoder-Decoder)框架。它被广泛应用于输入序列长度与输出序列长度不一致的任务中,例如: 机器翻译: 将英文的 “How are you?"(3个单词)翻译为中文的“你好吗?”(3个汉字)或西班牙语的 “¿Cómo estás?"(2个单词)。 文本摘要: 将一篇 500 字的文章压缩为 50 字的摘要。 问答系统: 将问题序列映射到相应的回答序列。 编码器-解码器机制 标准的 Seq2Seq 模型由两个循环神经网络(RNN)组成,通常采用 LSTM(长短期记忆网络)或 GRU(门控循环单元): 编码器(Encoder): 逐个 Token(词元)地处理输入序列。在每一步中,它会根据当前输入的 Token 和上一步的隐藏状态来更新隐藏状态。处理完整个输入后,编码器会提取最后一个隐藏状态。这个最终的隐藏状态被称为上下文向量(Context Vector)(或瓶颈向量)。 解码器(Decoder): 将上下文向量作为其初始隐藏状态,并以自回归的方式逐个 Token 地生成输出序列。在每一步中,它都会根据当前的隐藏状态和前一步生成的单词来预测下一个单词。 2. 瓶颈问题(Bottleneck Problem) 虽然经典的编码器-解码器模型是一项巨大的技术突破,但它存在一个致命的局限性,即信息瓶颈(Information Bottleneck)。 在标准的 Seq2Seq 模型中,编码器被迫将输入句子的完整语义——无论它是 5 个词还是 100 个词——全部压缩进一个固定大小的上下文向量中。 这导致了以下问题: 长期记忆丢失(Long-Term Memory Loss): 对于长句子,当编码器处理到序列末尾时,序列开头的语义信息已经被稀释或遗忘。 性能严重衰退: 随着输入句子长度的增加,翻译或摘要的质量会显著下降。 将复杂的长篇大论压缩进单一向量,就如同在翻译整章书之前,尝试用一句话来概括它一样。信息在这一压缩过程中不可避免地会丢失。
Seq2Seq 注意力机制 深度学习 自然语言处理 人工智能
阿拉伯语情感分析:实用的 NLP 预处理和模型演练

阿拉伯语情感分析:实用的 NLP 预处理和模型演练

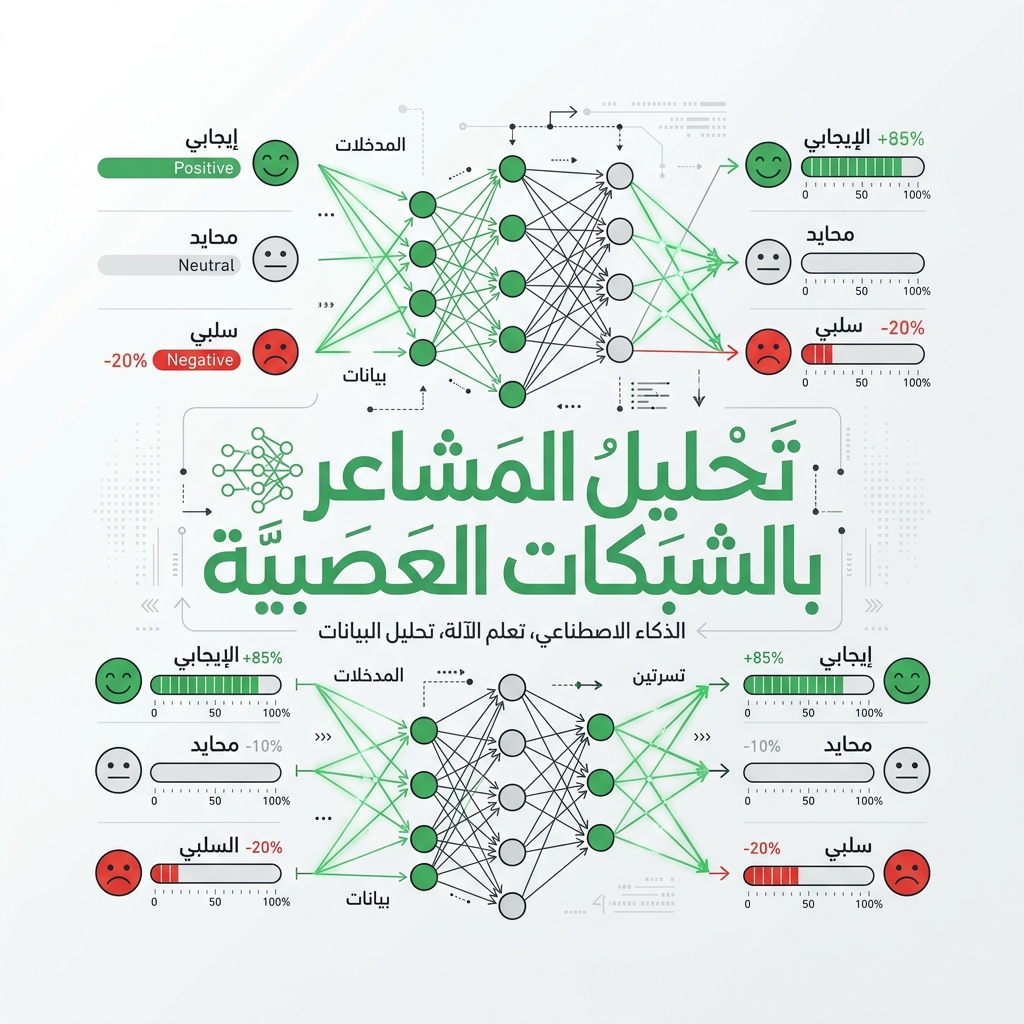
在全球化数字通信时代,情感分析(识别文本背后情绪基调的任务)已成为企业、政府和研究人员的关键工具。虽然英语等语言的情感分析已经高度成熟,但将其应用于阿拉伯语则面临着一系列独特的语言和技术挑战。 阿拉伯语拥有超过 4 亿使用者,是世界上使用最广泛的语言之一。然而,其丰富的形态结构、双层语言现象(标准语与口语并存)以及复杂的书写系统需要专门的预处理和建模策略。 本指南提供了阿拉伯语情感分析的全面演练,详细介绍了挑战、预处理流程、经典的机器学习实现(TF-IDF + 逻辑回归)以及使用 Hugging Face Transformers 的现代深度学习方法。 1. 阿拉伯语 NLP 的语言挑战 在编写代码之前,开发人员必须了解为什么阿拉伯语不能使用标准的西方 NLP 流程进行处理: 双层语言现象 (Diglossia): 阿拉伯语分为现代标准阿拉伯语 (MSA)(用于正式写作、新闻和官方文档)和口语方言 (Darja/Ammiya)(用于社交媒体和日常交流)。方言(例如埃及、黎凡特、海湾方言)在词汇、语法和情感表达上存在显著差异。 丰富的形态学 (Rich Morphology): 阿拉伯语是一种模板化语言,单词是通过应用特定模式从三字母或四字母词根衍生而来的。单个单词可以包含表示代词、介词和时态的前缀、后缀和中缀(例如 وسيكتبونها - “他们将写下它”)。 拼写变化 (Orthographic Variations): 阿拉伯语字母的形状经常根据其在单词中的位置而变化,并且用户经常混用某些字母(例如 Alif 的变体 أ、إ、آ、ا,或 Yaa 变体 ي 与 ى)。 变音符号 (Tashkeel): 短元音以变音符号的形式写在字母的上方或下方(例如 Fat-hah、Dammah、Kasrah)。虽然它们可以明确含义,但在数字文本中通常被省略,从而导致歧义;或者添加不一致,导致数据稀疏。 2. 阿拉伯语 NLP 预处理流程 为了处理阿拉伯语文本,我们必须构建一个专门的预处理流程,处理文本规范化、去变音符、分词、词干提取和模型推理: graph TD A[原始阿拉伯语文本] --> B[规范化与清洗] B --> C[去除变音符号与标点] C --> D[分词] D --> E[词干提取 / 词形还原] E --> F[特征向量化 / 词嵌入] F --> G[情感分类器] G --> H[输出结果:积极 / 消极 / 中性] 3. 步步详解:经典预处理与机器学习 (Python) 让我们使用 Python、NLTK 和 scikit-learn实现一个完整的流程。我们将编写自定义的规范化规则,并使用 NLTK 的 ISRIStemmer(专门为阿拉伯语设计的检索词干提取器)。
自然语言处理 NLP 情感分析 阿拉伯语人工智能 Transformers Python 机器学习