🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

Deep Learning

Generative KI erklärt: Wie Maschinen erschaffen lernen

Generative KI erklärt: Wie Maschinen erschaffen lernen

Generative KI ist einer der transformativsten technologischen Veränderungen des 21. Jahrhunderts. Im Gegensatz zu herkömmlichen KI-Systemen, die klassifizieren, vorhersagen oder erkennen, erstellt generative KI Text, Bilder, Audio, Video, Code und sogar dreidimensionale Strukturen. Es ist die Technologie hinter ChatGPT, der Artikel schreibt, Midjourney fotorealistische Kunst malt und GitHub Copilot, der ganze Funktionen aus einem Kommentar ausführt.
AI Generative AI LLMs Deep Learning Machine Learning GPT Diffusion Models
Wie das Gemini-Transformer-Modell funktioniert: GQA, SwiGLU und native Multimodalität

Wie das Gemini-Transformer-Modell funktioniert: GQA, SwiGLU und native Multimodalität

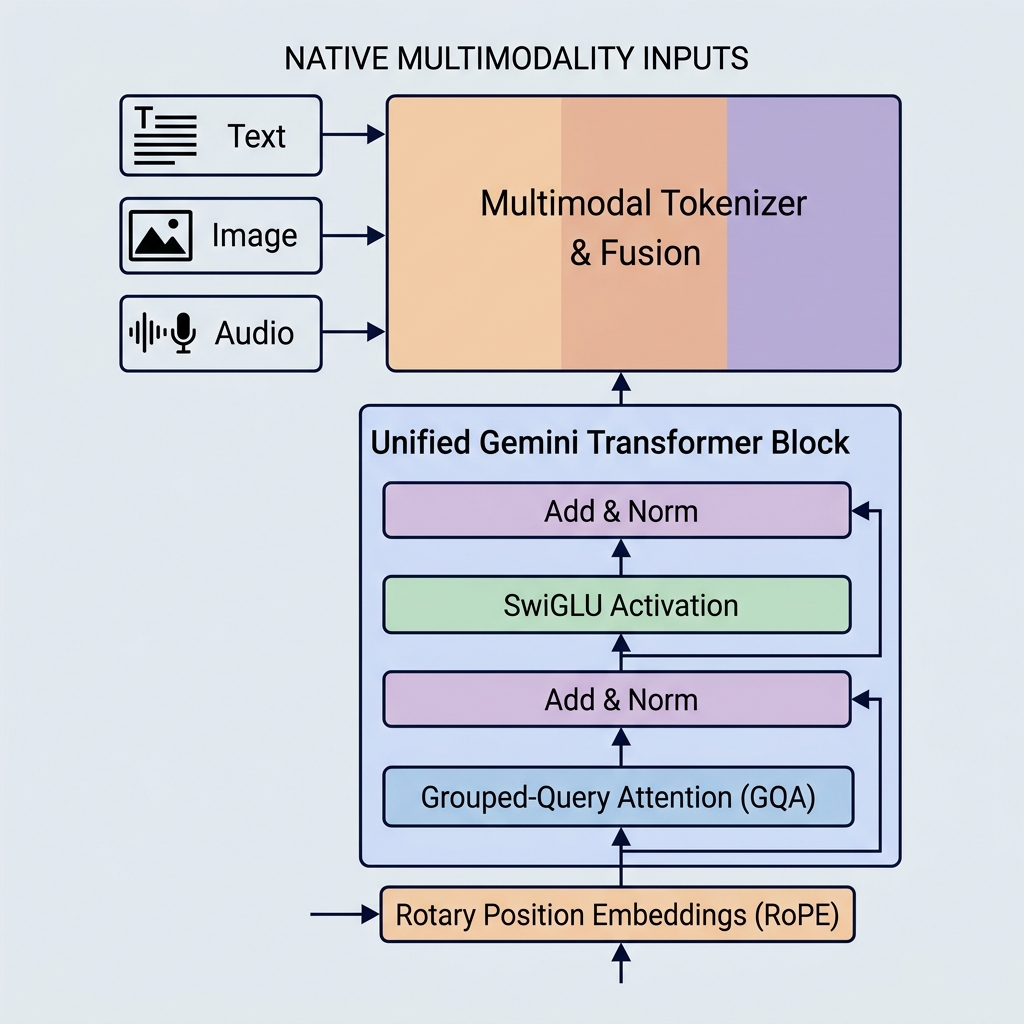
Die Gemini-Modelle von Google haben durch die Einführung nativer Multimodalität, riesiger Kontextfenster und wichtiger architektonischer Optimierungen neue Maßstäbe für KI-Fähigkeiten gesetzt. Im Gegensatz zu älteren Modellen wie GPT-3 oder BERT ist Gemini von Anfang an für die Verarbeitung mehrerer Datentypen ausgelegt und nutzt hocheffiziente Aufmerksamkeitsmechanismen.
Gemini Transformer GQA SwiGLU Multimodalität Deep Learning
Warum Transformer RNNs und LSTMs abgelöst haben

Warum Transformer RNNs und LSTMs abgelöst haben

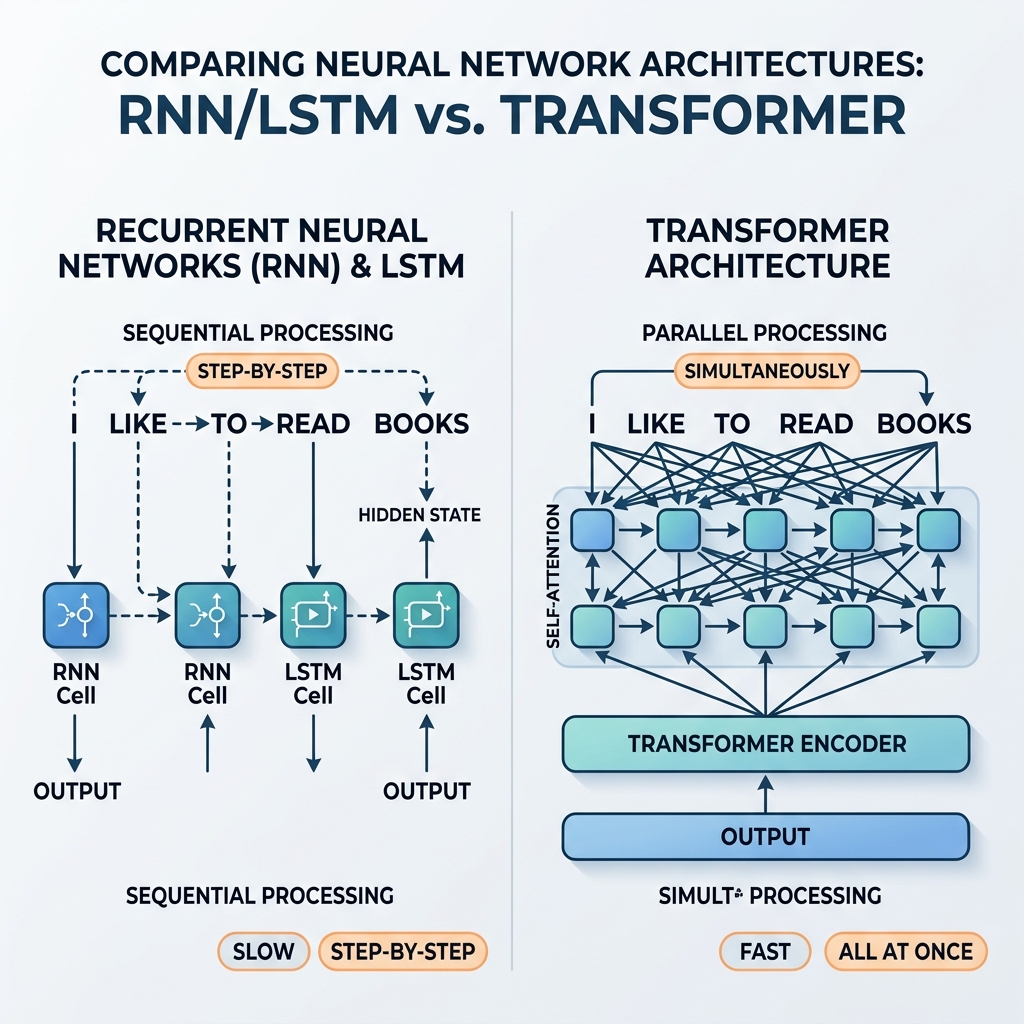
Jahrelang waren Recurrent Neural Networks (RNNs) und Long Short-Term Memory (LSTM) Netzwerke die unbestrittenen Champions der sequentiellen Datenverarbeitung. Sie trieben modernste Übersetzungssysteme, Sprachassistenten und Textgenerierungsmodelle an. Im Jahr 2017 führte das bahnbrechende Paper „Attention Is All You Need“ (Vaswani et al.) jedoch die Transformer-Architektur ein. Innerhalb weniger Jahre wurden RNNs und LSTMs fast vollständig aus den gängigen KI-Modellen verdrängt.
Transformer RNN LSTM NLP Deep Learning
BERT verstehen: Bidirektionale Encoder-Repräsentationen aus Transformern

BERT verstehen: Bidirektionale Encoder-Repräsentationen aus Transformern

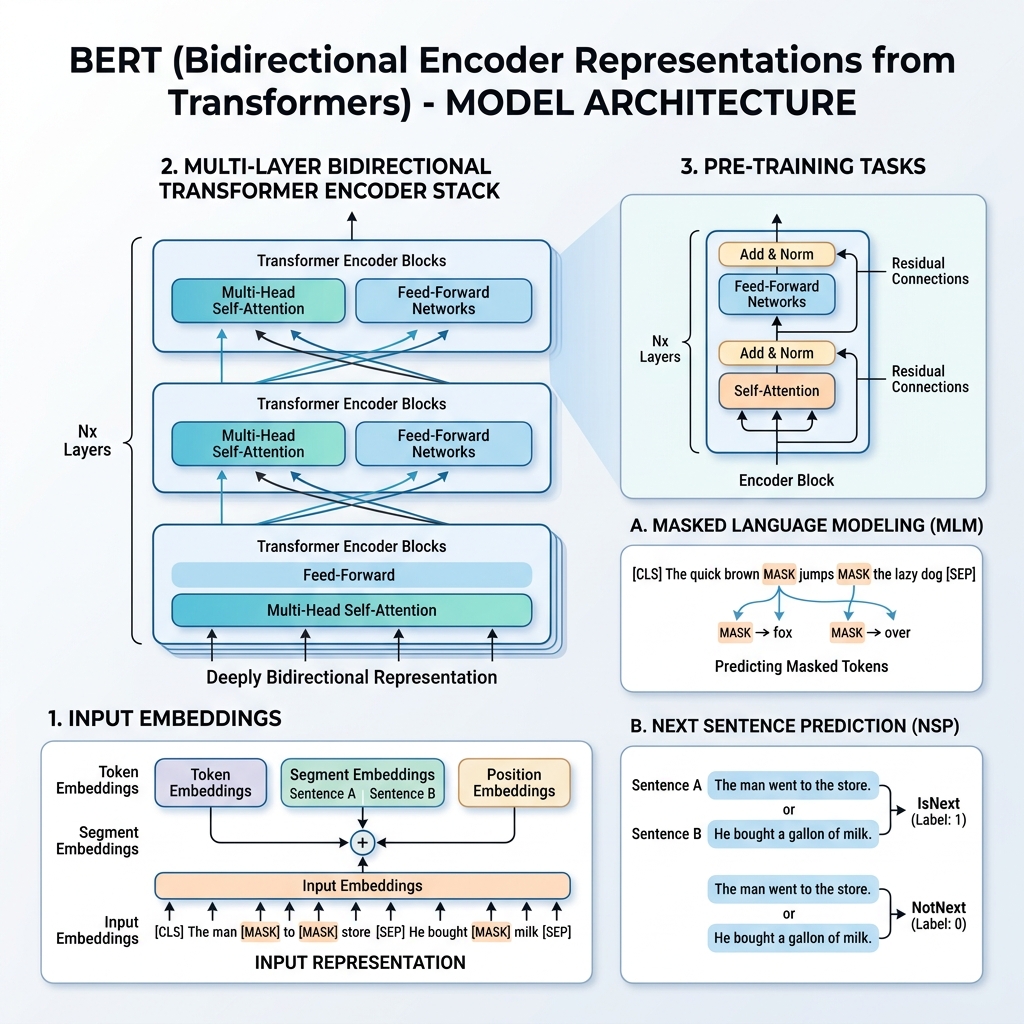
Im Jahr 2018 veröffentlichten Google-Forscher ein bahnbrechendes Paper mit dem Titel „BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding“ (Devlin et al.). Diese Arbeit hat das Feld der natürlichen Sprachverarbeitung (NLP) grundlegend verändert. Vor BERT verarbeiteten Modelle Text sequentiell von links nach rechts oder von rechts nach links. BERT führte eine Methode ein, um Sprachdarstellungen zu trainieren, die den Kontext aus beiden Richtungen gleichzeitig betrachten.
BERT Transformer NLP Deep Learning KI-Architektur
Transformer-Netzwerke und den Self-Attention-Mechanismus verstehen

Transformer-Netzwerke und den Self-Attention-Mechanismus verstehen

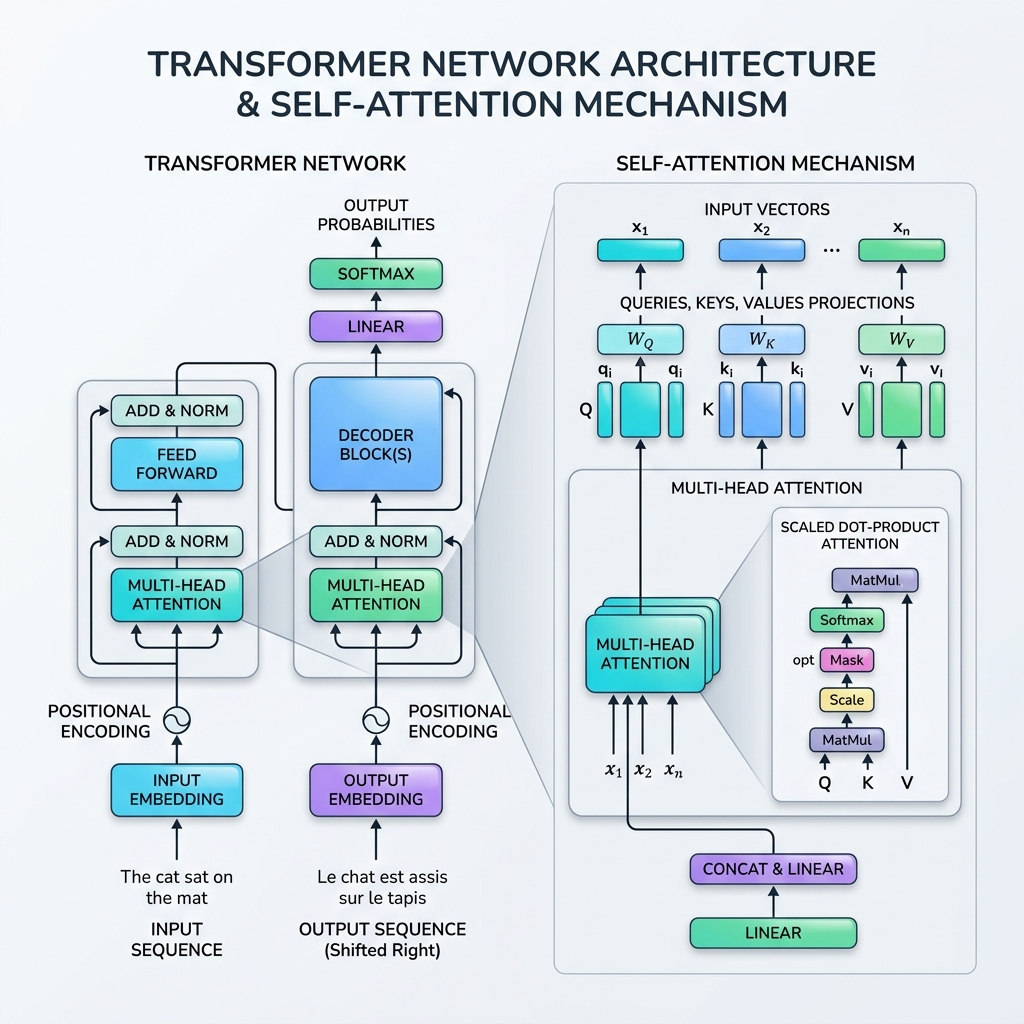
Im Jahr 2017 veränderte sich die Landschaft der künstlichen Intelligenz durch die Veröffentlichung des bahnbrechendenden Papers „Attention Is All You Need“ von Vaswani et al. für immer. Das Paper stellte den Transformer vor, eine revolutionäre neuronale Netzwerkarchitektur, die Rekursion (RNNs, LSTMs) vollständig verwarf und sich stattdessen dafür entschied, sequentielle Daten mithilfe des Self-Attention-Mechanismus parallel zu verarbeiten.
Transformer Self-Attention Deep Learning NLP KI-Architektur
Demystifizierung der Sequence-to-Sequence-Architektur und des Attention-Mechanismus

Demystifizierung der Sequence-to-Sequence-Architektur und des Attention-Mechanismus

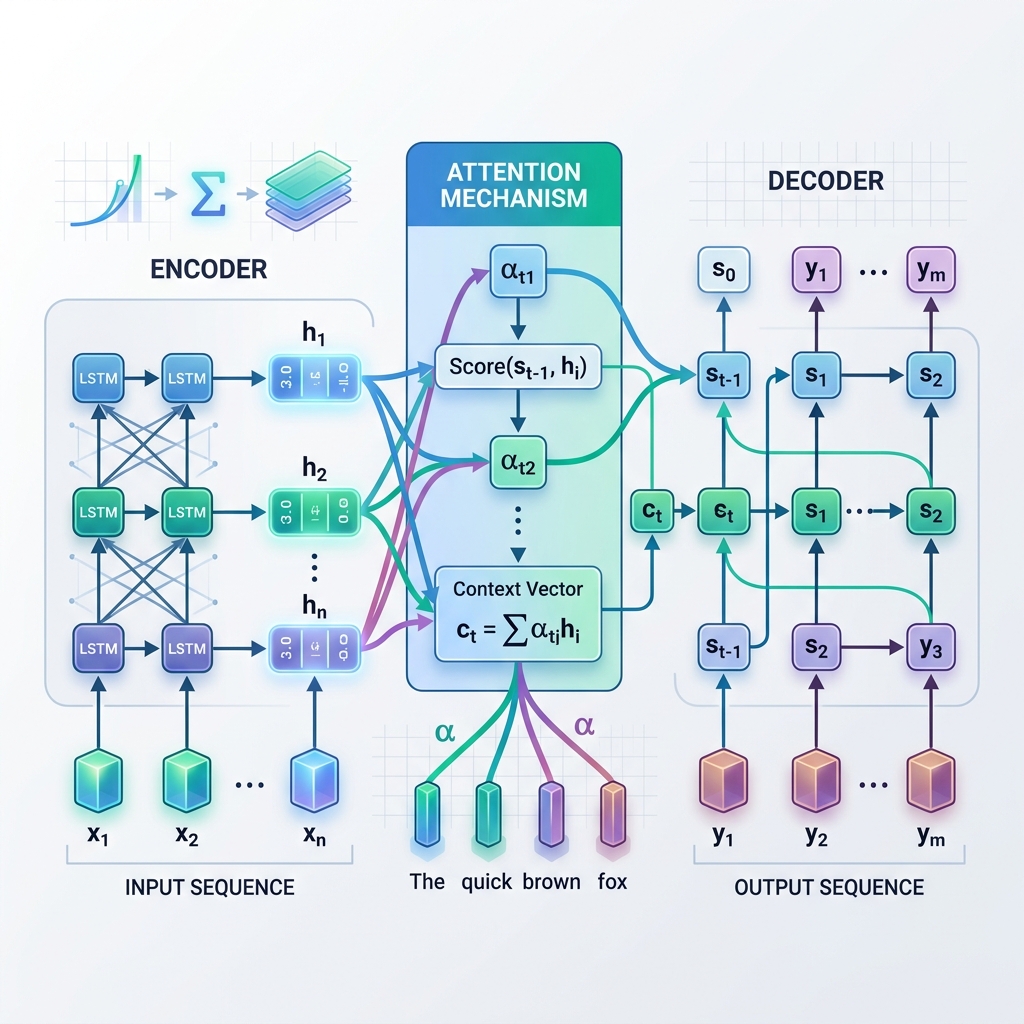
In der Landschaft der natürlichen Sprachverarbeitung (NLP) und der künstlichen Intelligenz hat die Fähigkeit, Sprachen zu übersetzen, Artikel zusammenzufassen und Konversationsantworten zu generieren, eine Revolution erfahren. Im Herzen dieser Transformation liegt die Sequence-to-Sequence (Seq2Seq) Architektur und der wegweisende Attention-Mechanismus. Vor dem Aufkommen moderner Transformer lösten diese beiden Innovationen eine der größten Herausforderungen des Deep Learning: die Abbildung von Eingabesequenzen auf Ausgabesequenzen bei unterschiedlichen Längen.
Seq2Seq Attention-Mechanismus Deep Learning NLP Künstliche Intelligenz
Wie Computer Vision funktioniert: Von Pixeln zu realer Intelligenz

Wie Computer Vision funktioniert: Von Pixeln zu realer Intelligenz

Im digitalen Zeitalter von 2026 ist Computer Vision (CV) zu einem der transformativsten Zweige der Künstlichen Intelligenz geworden. Es ist die Wissenschaft, die es Computern ermöglicht, die visuelle Welt so zu “sehen” und zu interpretieren, wie Menschen es tun – wenn nicht sogar besser. Von der Gesichtserkennung auf Ihrem Smartphone bis hin zu autonomen Drohnen, die Pakete ausliefern – Computer Vision ist überall.
Computer Vision KI Maschinelles Lernen Deep Learning Bilderkennung Tech-Trends 2026