🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

ディープラーニング

なぜTransformerがRNNやLSTMに取って代わったのか

なぜTransformerがRNNやLSTMに取って代わったのか

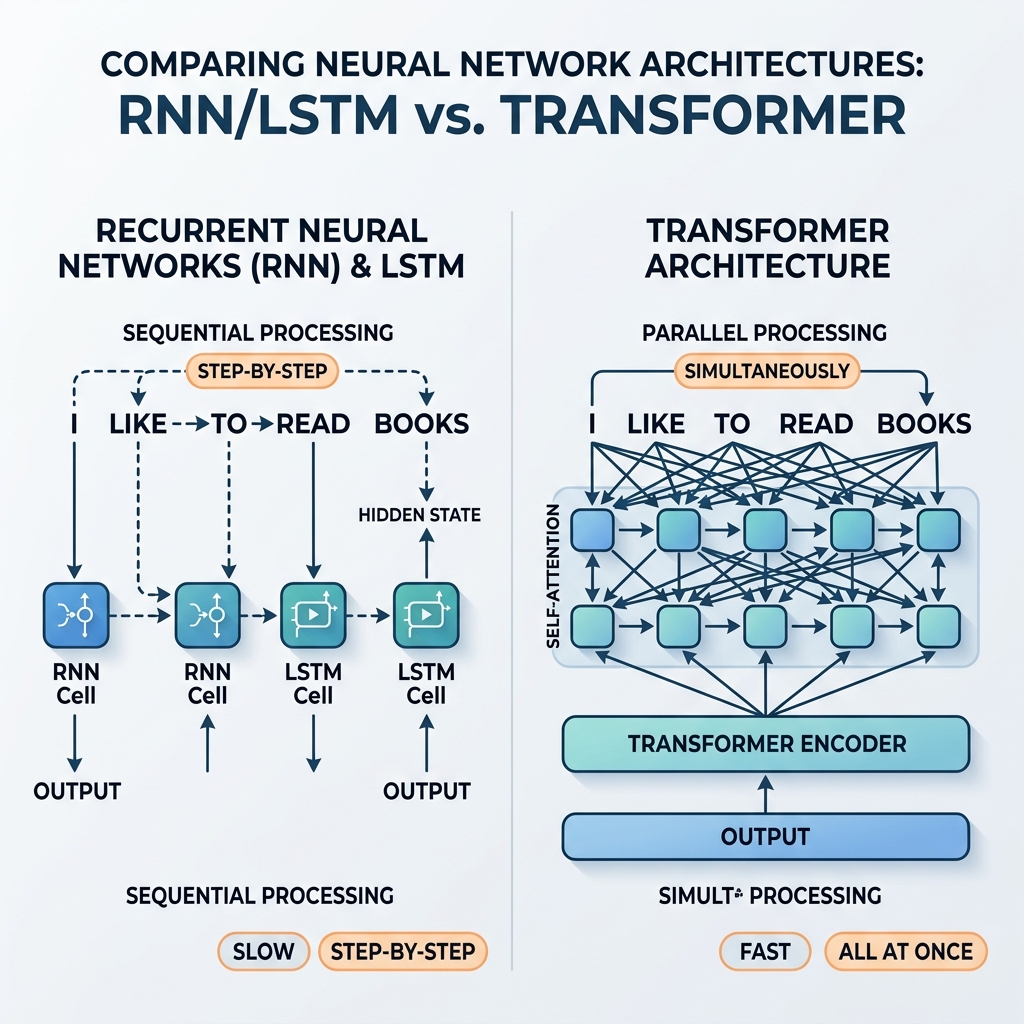
長年にわたり、リカレントニューラルネットワーク(RNN)と長短期記憶(LSTM)ネットワークは、シーケンシャルデータ処理の絶対的な王者でした。これらは、最先端の翻訳システム、音声アシスタント、およびテキスト生成モデルを支えていました。しかし、2017年に発表された画期的な論文 「Attention Is All You Need」(Vaswaniら)によって、Transformerアーキテクチャが導入されました。その後数年で、RNNやLSTMは主流のAIモデルからほぼ完全に姿を消しました。 なぜこれほど急速な移行が起こったのでしょうか?Transformerがリカレント構造に対して構造的に優れている理由は何でしょうか?この記事では、RNN/LSTMの数学的およびアーキテクチャ的なボトルネックと、Transformerがそれらをどのように克服したかを探ります。 1. 核心的なボトルネック:シーケンシャル処理の限界 RNNを定義する最大の特徴は、その再帰的な状態遷移です。入力シーケンスを処理するために、ネットワークは各トークンを一度にステップずつ処理し、現在の入力 $x_t$ と直前の隠れ状態 $h_{t-1}$ に基づいて、内部の隠れ状態 $h_t$ を更新します。 数学的な再帰関係は次のように表されます。 $$h_t = \tanh(W_{hh} h_{t-1} + W_{xh} x_t + b)$$ 並列化の問題 $h_t$ は直接 $h_{t-1}$ に依存するため、処理を並列化することができません。文の中の100番目の単語の状態を計算するには、ネットワークは最初の99個の状態を順番に計算しなければなりません。 GPUやTPUが大規模な並列行列計算をサポートするように進化するにつれて、このシーケンシャルな依存関係は重大なボトルネックになりました。大規模なWebデータセットで深いRNNモデルをトレーニングするのには何週間もかかりましたが、計算が独立していれば、ハードウェアはより高速に動作する能力を持っていました。 2. 情報のボトルネック:勾配消失問題 シーケンス長 $N$ が増加するにつれて、時間を介した誤差逆伝播法(BPTT)では、再帰重み $W_{hh}$ との行列積を繰り返す必要があります。$W_{hh}$ の最大固有値が1未満の場合、勾配は指数関数的に縮小します(勾配消失)。1より大きい場合、それらは指数関数的に増加します(勾配爆発)。 $$\frac{\partial E_t}{\partial h_1} = \frac{\partial E_t}{\partial h_t} \prod_{k=2}^{t} \frac{\partial h_k}{\partial h_{k-1}}$$ LSTMとメモリ制限 LSTMはセル状態とゲート機構(忘却ゲート、入力ゲート、出力ゲート)を導入し、勾配が線形に流れるようにすることで勾配消失を緩和しました。しかし、LSTMであっても数百トークンを超える長さのシーケンスでは苦戦します。隠れベクトルは、過去のすべてのトークンの履歴を固定サイズの表現に圧縮することを強制されるため、「忘却」効果が生じます。 3. Transformerがどのように再帰問題を解決したか Transformerは再帰を完全に取り除き、自己アテンション(Self-Attention)メカニズムに置き換えました。ステップバイステップの状態伝播の代わりに、自己アテンションはシーケンス内のすべてのトークンが同時に他のすべてのトークンと直接相互作用することを可能にします。 アテンション行列は以下のように計算されます。 $$\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{Q K^T}{\sqrt{d_k}}\right) V$$
Transformers RNN LSTM NLP ディープラーニング
BERTの理解:Transformersによる双方向エンコーダ表現

BERTの理解:Transformersによる双方向エンコーダ表現

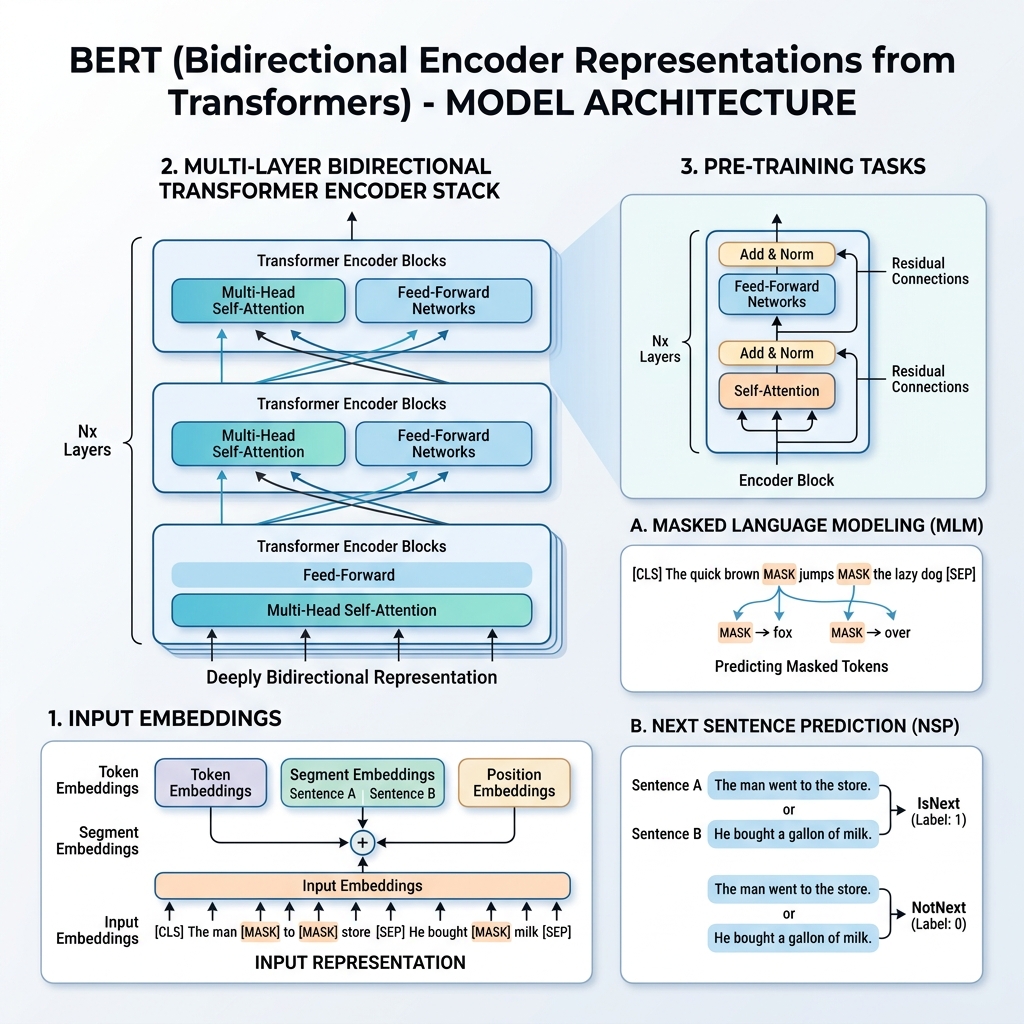
2018年、Googleの研究者らは、「BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding」(Devlinら)という画期的な論文を発表しました。この研究は、自然言語処理(NLP)の分野を根本から変えました。BERT以前のモデルは、テキストを左から右、または右から左へと順次処理していました。BERTは、両方向からの文脈を同時に考慮する言語表現を学習する手法を導入しました。 現在でも、BERTとその派生モデル(RoBERTa、DistilBERT、ALBERTなど)は、検索エンジン、感情分析、質問応答システム、情報抽出の基盤であり続けています。この記事では、BERTのアーキテクチャ、仕組み、および学習方法について詳しく解説します。 1. BERTとは何か? BERTは Bidirectional Encoder Representations from Transformers(Transformersによる双方向のエンコーダ表現)の略です。この名前を分解してみましょう。 双方向(Bidirectional): テキストを左から右(GPTなど)または右から左に読み込む従来の言語モデルとは異なり、BERTは単語のシーケンス全体を一度に読み込みます。これにより、単語の左右両方の周囲すべての環境に基づいて、その単語の文脈を学習できます。 エンコーダ表現(Encoder Representations): BERTは、オリジナルのTransformerアーキテクチャの**エンコーダ(Encoder)**部分を使用します。入力シーケンスを受け取り、各トークンに対して密なベクトル表現(埋め込み/embedding)を出力します。 Transformers: 基盤となるエンジンはTransformerのアテンション(注意)ネットワークであり、長距離の依存関係のモデリングと並列計算を可能にします。 双方向性の力 単方向モデルでは、トークンはそれ以前のトークンにしかアテンションを向けることができません。例えば、次の文を考えてみましょう。 「彼は銀行(bank)にお金を預けることに決めた。」 単方向モデルが「bank」を処理する場合、それより前にある単語しか見ません。しかし、文脈を完全に理解するには、左右両方の文脈を見ることが極めて重要です。双方向LSTMは、左から右と右から左のモデルを個別に学習して出力を結合することでこれを試みましたが、BERTはすべてのレイヤーで最初から単一の深い双方向モデルを共同で学習します。 2. BERTの入力表現 様々な下流タスクでの学習を可能にするため、BERTの入力表現は、単一のトークンシーケンス内で、単一の文と文のペア(例:<質問, 回答>)の両方を表現できます。 任意のトークンについて、その入力表現は次の3つの埋め込みを合算して構築されます。 トークン埋め込み(Token Embeddings): テキストは WordPiece ボキャブラリ(約30,000トークン)を使用してトークン化されます。特殊トークンが追加されます。 [CLS]:すべてのシーケンスの先頭に挿入されます。その最終隠れ状態は分類タスクに使用されます。 [SEP]:文を区切るため、またはシーケンスの末尾に使用されます。 セグメント埋め込み(Segment Embeddings): トークンが文Aと文Bのどちらに属しているかを示す、学習された埋め込み。 位置埋め込み(Position Embeddings): シーケンス内のトークンの位置をモデルに認識させるために追加される、学習された位置ベクトル(最大512トークン)。 $$\text{入力表現} = \text{トークン埋め込み} + \text{セグメント埋め込み} + \text{位置埋め込み}$$ 3. 事前学習プロセス BERTは、**マスク化言語モデル(MLM)と隣接文予測(NSP)**という2つの自己教師ありタスクを同時に使用して、大規模なコーパス(WikipediaおよびBooksCorpus)で事前学習されます。 タスク1:マスク化言語モデル(MLM) 標準的な言語モデリングでは、次の単語を予測する際に、ターゲット単語が自分自身を「見る」のを防ぐため、モデルを左から右のアーキテクチャに制限します。深い双方向表現を学習するために、BERTは入力トークンの一定割合をランダムにマスクし、それらを予測します。 具体的には:
BERT Transformers NLP ディープラーニング AIアーキテクチャ
Transformer ネットワークと自己アテンション(Self-Attention)メカニズムの理解

Transformer ネットワークと自己アテンション(Self-Attention)メカニズムの理解

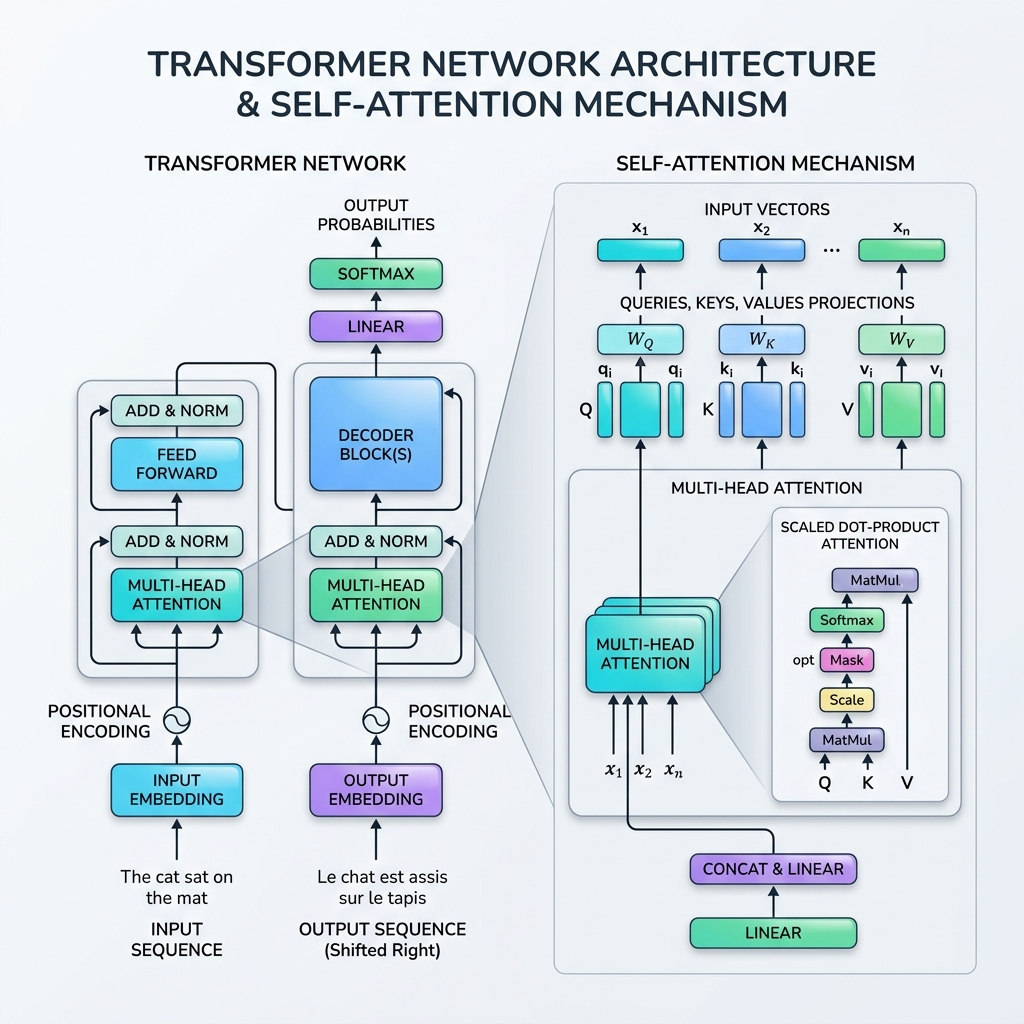
2017年、Vaswaniらによるマイルストーン的な論文 “Attention Is All You Need” の発表によって、人工知能の地平は永遠に塗り替えられました。この論文は、従来の再帰型構造(RNN、LSTM)を完全に排除し、自己アテンション(Self-Attention)メカニズムを用いてシーケンスデータを並列処理する、革命的なニューラルネットワークアーキテクチャ Transformer を提案しました。 今日、Transformer は GPT-4、Gemini、Claude、Llama をはじめとする、ほぼすべての最先端の大規模言語モデル(LLM)の原動力となっています。このブログでは、Transformer ネットワークの仕組みを紐解き、自己アテンションメカニズムが数学的および実践的にどのように実装されているかを解説します。 1. 順次処理のボトルネック(RNN と Transformer の比較) Transformer 以前は、リカレントニューラルネットワーク(RNN)や長短期記憶(LSTM)ネットワークがシーケンスモデリング의 標準でした。しかし、RNNはトークンを順次(1単語ずつ)処理します。10番目の単語の隠れ状態を計算するためには、モデルはまず1番目から9番目までの単語の隠れ状態を計算しなければなりません。 この順次処理の性質は、2つの深刻な制限をもたらします。 並列化の欠如: 計算が前のステップの完了を待つ必要があるため、現代のGPUを効率的に活用できません。 勾配消失・爆発問題: 長いシーケンスの初期の情報は、モデルが終端に達するまでに圧縮され、失われてしまいます(ボトルネック問題)。 Transformer はこれら両方の問題を解決します。再帰を Self-Attention に置き換えることで、Transformer は入力シーケンス全体を同時に処理し、大規模な並列化と、距離に関係なくシーケンス内の任意の2つのトークン間の直接的な結合経路を可能にします。 2. 自己アテンション(Self-Attention)メカニズムとは? 自己アテンションは、同じシーケンス内の異なる単語間の関係性をモデルが評価できるようにする仕組みです。単語を単独で処理するのではなく、文中の他のすべての単語からコンテキストを取り入れることで、各単語を表現します。 例えば、次の文章を考えてみましょう。 “The bank of the river was muddy."(川の土手は泥だらけだった。) “The money was deposited in the bank."(お金は銀行に預けられた。) 「bank」という単語は、文脈によって異なる意味を持ちます。自己アテンションにより、モデルは最初の文では「river(川)」を、2番目の文では「money(お金)」を見ることで、「bank」の表現を正しく調整できます。 データベースのアナロジー:クエリ(Q)、キー(K)、値(V) 自己アテンションの数学的定式化は、情報検索(データベース)のルックアップをモデルにしています。各入力トークンについて、3つのベクトル表現を投影します。 クエリ (Query, $Q$): 現在のトークンが「探している」もの。 キー (Key, $K$): シーケンス内のトークンの「ラベル」またはプロファイル。 値 (Value, $V$): トークンの実際のコンテンツまたは情報。 アテンションメカニズムは、Query とすべての Keys の間の類似度スコアを計算し、これらのスコアを重みに正規化して、Values の加重和を返します。
Transformer Self-Attention ディープラーニング NLP AIアーキテクチャ
Sequence-to-Sequence(Seq2Seq)アーキテクチャとアテンションメカニズムの仕組み

Sequence-to-Sequence(Seq2Seq)アーキテクチャとアテンションメカニズムの仕組み

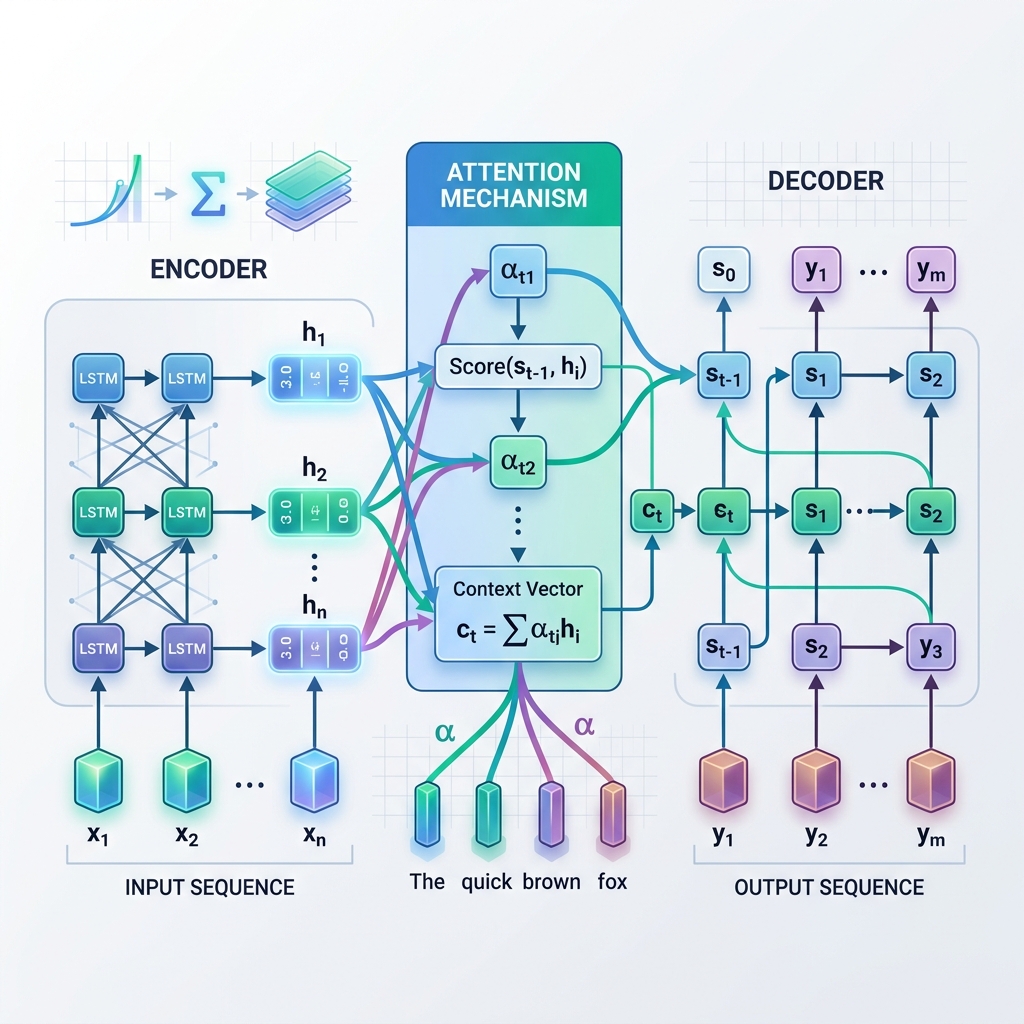
自然言語処理(NLP)および人工知能(AI)の領域において、言語の翻訳、文章の要約、対話の生成を行う能力は劇的な革命を遂げました。この変革の中心に位置するのが、**Sequence-to-Sequence(Seq2Seq)アーキテクチャと、先駆的なアテンションメカニズム(Attention Mechanism)**です。 現代の Transformer が登場する前、これら2つのイノベーションは、入力配列と出力配列の長さが異なる場合にそれらをマッピングするという、ディープラーニングにおける最大の課題の1つを解決しました。 1. 基礎:Sequence-to-Sequence(Seq2Seq)とは何か? 2014年にGoogleなどの研究者によって発表されたSequence-to-Sequence(Seq2Seq)モデルは、時系列データを処理するために設計されたエンコーダー・デコーダー(Encoder-Decoder)フレームワークです。入力配列の長さと出力配列の長さが一致しない以下のようなタスクで広く使用されています: 機械翻訳: 英語の “How are you?"(3単語)を日本語の「お元気ですか?」(6文字)やスペイン語の “¿Cómo estás?"(2単語)に翻訳する。 テキスト要約: 500単語の論文を50単語の要約に圧縮する。 質問応答: 質問の配列を回答の配列にマッピングする。 エンコーダー・デコーダーの仕組み 標準的なSeq2Seqモデルは、一般的にLSTM(Long Short-Term Memory)またはGRU(Gated Recurrent Units)と呼ばれる2つの再帰型ニューラルネットワーク(RNN)で構成されています: エンコーダー(Encoder): 入力配列をトークンごとに順次処理します。各ステップで、現在の入力トークンと前の隠れ状態に基づいて、自身の隠れ状態(hidden state)を更新します。入力全体が処理されると、エンコーダーの最後の隠れ状態が取得されます。この最終状態は文脈ベクトル(Context Vector)(またはボトルネックベクトル)と呼ばれます。 デコーダー(Decoder): 文脈ベクトルを初期の隠れ状態として受け取り、出力配列を自帰的にトークンごとに生成します。各ステップで、現在の隠れ状態と以前に生成された単語に基づいて、次の単語を予測します。 2. ボトルネック問題(Information Bottleneck) クラシックなエンコーダー・デコーダーモデルは大きなブレイクスルーであったものの、情報ボトルネックとして知られる根本的な限界を抱えていました。 標準的なSeq2Seqモデルでは、エンコーダーは入力文全体の意味を(それが5単語であれ100単語であれ)、固定サイズの単一の文脈ベクトルに圧縮することを強制されます。 その結果: 長期記憶の喪失: 長い文章では、エンコーダーが終端に達する頃には、配列の初期部分の情報が失われてしまいます。 性能の低下: 入力文の長さが長くなるにつれて、翻訳や要約の品質が著しく低下します。 複雑な段落を単一のベクトルに圧縮することは、本の一章全体を翻訳する前に、一言の文章で要約しようとするようなものです。情報は必然的に失われます。 3. アテンションメカニズム:パラダイムシフト 情報ボトルネックを解決するため、Dzmitry Bahdanau(バダナウ)ら研究グループは2015年に**アテンションメカニズム(注意機構)**を導入しました。 エンコーダーの最終ステップから得られる単一の静的な文脈ベクトルのみに依存する代わりに、アテンションはデコーダーがデコードプロセスの各ステップでエンコーダーのすべての隠れ状態を**「振り返る」**ことを可能にします。これは、モデルが現在生成している単語に応じて、入力配列の異なる部分に動的に焦点を当てる(注意を向ける)ことを意味します。 アテンションの仕組み:ステップ・バイ・ステップ 各デコードステップ $t$ において: アライメントスコアの計算 ($e_{t, j}$): デコーダーの現在の隠れ状態 $s_{t-1}$ と、エンコーダーの各隠れ状態 $h_j$ を比較し、エンコーダーの状態 $j$ がデコーダーの現在のステップにどれだけ関連しているかを測定します。 $$e_{t, j} = \text{score}(s_{t-1}, h_j)$$ アテンション重みの計算 ($\alpha_{t, j}$): アライメントスコアを softmax 関数を使用して正規化し、合計が1になる確率(重み)に変換します。 $$\alpha_{t, j} = \frac{\exp(e_{t, j})}{\sum_k \exp(e_{t, k})}$$ 動的文脈ベクトルの生成 ($c_t$): エンコーダーのすべての隠れ状態の加重平均として、文脈ベクトルを計算します。 $$c_t = \sum_j \alpha_{t, j} h_j$$ トークンの予測: デコーダーは動的文脈ベクトル $c_t$ と現在の状態 $s_t$ を組み合わせて、次の出力トークンを予測します。 4. Seq2Seqとアテンションメカニズムの詳細な解説 これらのメカニズムの背後にある技術を真に理解するために、まず古典的な Sequence-to-Sequence アーキテクチャの数学的および操作的なステップを辿り、続いて Bahdanau(加算)と Luong(乗算)の両方のアテンション手法について解説します。
Seq2Seq アテンションメカニズム ディープラーニング 自然言語処理 人工知能
コンピュータビジョンの仕組み:ピクセルから現実世界の知能へ

コンピュータビジョンの仕組み:ピクセルから現実世界の知能へ

急速に進化する 2026 年のデジタル時代において、コンピュータビジョン (CV) は人工知能の中で最も変革的な分野の一つとなりました。それは、コンピュータが人間と同じように、あるいはそれ以上に、視覚的な世界を「見て」解釈することを可能にする科学です。スマートフォンの顔認証から、荷物を配送する自律型ドローンに至るまで、コンピュータビジョンはあらゆるところに存在しています。 しかし、マシンは実際にどのようにして数値のグリッドを、認識された物体へと変換しているのでしょうか? 1. 基礎:デジタル画像とは何か? コンピュータにとって、画像は写真ではなく、ピクセル (Pixels) と呼ばれる数値の巨大なグリッドです。各ピクセルは色の値を表します。標準的な RGB 画像では、すべての点が 3 つの数値(赤、緑、青)によって定義されます。 コンピュータビジョンとは、複雑なアルゴリズムを使用して、これらの数値の中からパターンを見つけ出すプロセスのことです。 2. コンピュータビジョンのパイプライン マシンが猫や一時停止の標識を特定できるようになる前に、データはいくつかの重要な段階を経ます。 画像取得: カメラ、LiDAR(レーザーレーダー)、または熱センサーを介して視覚データをキャプチャします。 前処理: データのクリーニング。一貫性を確保するために、明るさの調整、ノイズの除去(デノイジング)、または画像サイズの正規化などを行います。 特徴抽出: 重要な部分の特定。アルゴリズムは、形状を定義するエッジ、コーナー、テクスチャなどを探します。2026 年には、これは主に深い神経層(ニューラルレイヤー)によって自動的に処理されます。 分類・検出: AI が抽出された特徴に基づいて、何を見ているのかを判断する最終ステップです。 3. 畳み込みニューラルネットワーク (CNN) の魔法 コンピュータビジョンにおける真の突破口は、ディープラーニング、特に畳み込みニューラルネットワーク (CNN) によってもたらされました。 CNN は人間の視覚皮質を模倣しています。CNN は画像を複数の層を通してスキャンします。ここでは、畳み込み (Convolution) と呼ばれるプロセスが使用され、小さなフィルターがピクセル上を移動して空間的な特徴を抽出します。 下位層: 水平線や垂直線などの単純なパターンを検出します。 中間層: 線を組み合わせて、円や長方形などの形状を作成します。 上位層: 目、車輪、葉などの複雑な構造を認識します。 4. 検出 vs セグメンテーション:「どこに」と「何を」を知る 現代のコンピュータビジョンは、単に物体の名前を挙げるだけではありません。それをマッピングします。 物体検出 (Object Detection): 物体の周囲に「バウンディングボックス(境界枠)」を描画します(例:「この座標に車があります」)。 セマンティックセグメンテーション: 画像内のすべてのピクセルにラベルを付けます(例:「この 5,000 ピクセルは道路の一部であり、この 200 ピクセルは歩行者の一部です」)。 インスタンスセグメンテーション: 同じタイプの複数の物体を区別します(例:「これは車 A で、あれは車 B です」)。 5. 現実世界におけるコンピュータビジョン (2026) 2026 年現在、コンピュータビジョンはもはや実験的なものではなく、不可欠なものとなっています。
コンピュータビジョン AI 機械学習 ディープラーニング 画像認識 2026年の技術トレンド