🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

AI

企业如何结合人工智能和区块链实现更智能的自动化

企业如何结合人工智能和区块链实现更智能的自动化

在现代企业架构中,两种技术范式正在迅速融合,重新定义业务流程的自动化方式:人工智能 (AI) 和 区块链。 人工智能带来了先进的认知能力、模式识别和非结构化数据处理——代表了企业应用程序的**“大脑”。区块链带来了绝对的透明度、加密验证和去中心化共识——代表“信任的支柱”**。 通过将人工智能推理与区块链安全相结合,企业可以构建自主工作流程,这些工作流程不仅高度智能,而且完全可审计、安全,并且能够在没有中央中介的情况下执行财务和物流复杂的交易。 1. 协同作用:推理与加密信任的结合 当单独部署时,人工智能和区块链在企业环境中都有明显的局限性: 人工智能信任赤字:大型语言模型和神经网络是概率性的。它们会产生幻觉,产生不一致的输出,并充当“黑匣子”,很难追踪精确的逐步推理。 区块链刚性:智能合约是确定性的、二元的和刚性的。他们无法在没有外部输入的情况下处理非结构化数据(例如电子邮件、PDF 或图像)或在不确定的情况下做出决策。 将它们结合起来创建一个强大的、自我纠正的反馈循环: 技术 核心力量 解决对方的弱点 人工智能 认知推理、非结构化数据解析、灵活决策。 为智能合约提供经过处理的智能现实数据和结构化输出。 区块链 不可变状态记录、加密证明、去信任执行。 将人工智能决策、提示和操作记录在不可更改的分类账上,以供审核和验证。 2. 关键企业用例 A. 智能合约 传统的智能合约基于简单的参数输入自动执行(例如,“如果当前日期 > 交货日期,则支付罚款”)。然而,现实世界的合同很少那么简单。他们需要定性评估(例如,“根据照片检验报告验证货物是否完好无损地到达”)。 通过将人工智能代理封装在区块链预言机中,合约可以评估复杂的输入。人工智能审查照片证据或物流提单,生成结构化分类(例如Passed Quality Control),并将验证状态直接写入智能合约,触发付款。 B. 可审计且合规的人工智能(审计追踪) 在金融、保险和医疗保健等监管严格的行业,部署自主人工智能代理受到合规性要求的限制。如果人工智能代理决定拒绝保险索赔,企业必须能够准确证明“为什么”以及“如何”做出该决定。 通过将 LLM 的系统提示、用户输入、工具执行输出和最终代理决策直接散列并写入不可变的区块链分类账上,公司可以创建防篡改的审计跟踪。这使得审计人员能够验证人工智能是否在定义的政策范围内运行。 C. 安全的去中心化数据市场 训练企业级人工智能模型需要大量高质量数据。然而,由于隐私问题,公司对于共享专有数据犹豫不决。 使用基于区块链的令牌门控访问与联合学习和**零知识证明(ZKP)**相结合,企业可以贡献数据来训练共享行业模型,而无需暴露其原始专有数据。区块链充当协调层,根据模型性能指标向数据贡献者奖励代币或版税份额。 3. 链上人工智能代理架构 为了将人工智能工作流程与区块链系统集成,我们将架构分为三个主要层:认知层(LLM代理)、中间件/Oracle层(将人工智能输出转换为区块链调用)和账本层(智能合约执行)。 认知层:人工智能代理处理传入的非结构化数据(例如电子邮件或文档)并根据规则对其进行评估。 Oracle 层:代理将其推理重新格式化为结构化交易有效负载,并使用安全保存在硬件安全模块 (HSM) 中的加密密钥对其进行签名。 账本层:智能合约验证签名、执行状态检查并执行链上操作(例如资产分配)。 4. 实现:AI代理触发链上支付 这是一个 Python 实现,演示了自主 AI 代理如何解析运输遥测数据、确定是否满足合同条件(例如冷链药品物流的温度阈值)并使用 Web3.py 触发智能合同交易。
AI Blockchain Smart Contracts Enterprise Automation Web3 Oracles
与法学硕士构建自主人工智能工作流程

与法学硕士构建自主人工智能工作流程

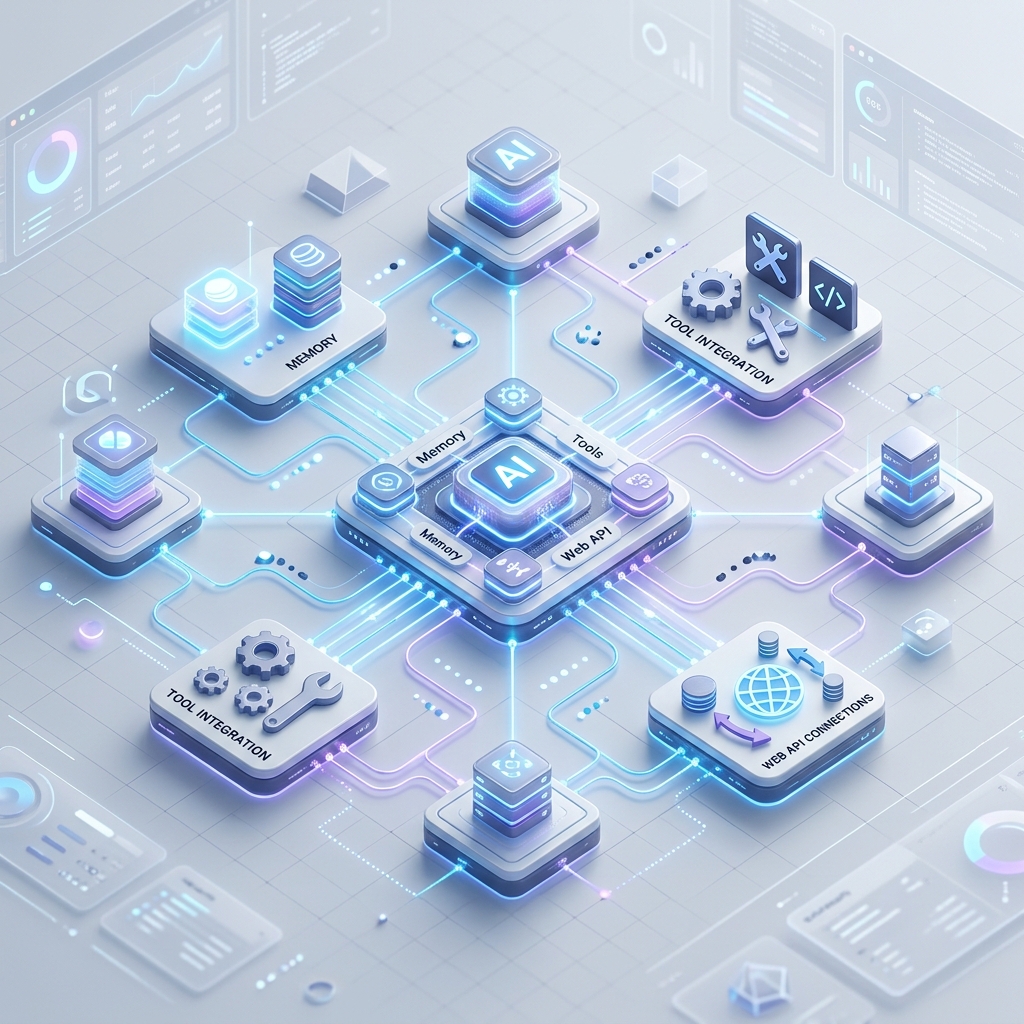
大型语言模型 (LLM) 改变了我们与技术交互的方式,从简单的会话聊天机器人迅速转变为能够驱动复杂、多步骤操作的推理引擎。虽然单个提示响应交互可能很强大,但生成式人工智能在企业环境中的真正价值在于自主人工智能工作流程。 自主工作流程不是依靠人类操作员来协调每一步,而是使用法学硕士作为中央决策者,长期规划、执行、评估和自我纠正任务。 本次深入探讨了如何使用现代设计模式、状态机和强大的护栏来架构、构建和部署可靠的自主人工智能工作流程。 1. 代理转变:聊天机器人与工作流程 LLM申请的演变可以分为四个不同的自主级别: 水平 范式 人类角色 核心机制 1 级 对话式聊天 高(每回合提示) 无状态单轮完成 2 级 工具调用/函数调用 中等(提供上下文) 模型选择API调用;返回结果 3级 定向工作流程 低(定义目标和图表) 带有 LLM 路由的硬编码状态机 4级 完全自主的代理 最小(定义目标/预算) LLM驱动的规划、执行和反思循环 虽然 4 级代理非常灵活,但众所周知,它们在生产环境中很难预测。因此,大多数企业架构都建立在第三级:定向工作流之上,将软件状态机的确定性可靠性与法学硕士的动态推理相结合。 2. 自主工作流程的核心支柱 要构建自主工作流程,您需要结合四个基本组件: A. 推理与规划 工作流程的核心是规划范例。幼稚的 LLM 调用会尝试立即输出最终答案,这通常会导致推理失败。自主工作流程使用专门的规划循环: ReAct (Reason + Act):模型迭代地思考、行动(调用工具)、观察结果,重复这个循环,直到达到目标。 思想链 (CoT):强制模型在得出结论之前*输出其逐步推理。 思想树 (ToT):生成和评估多个替代路径,跟踪不同的分支,并在路径失败时回溯。 B. 短期和长期记忆 自治系统必须在多个执行周期中维护状态: 短期内存:跟踪工作流当前正在执行的操作的线程上下文、状态变量和执行日志。 长期记忆:矢量数据库和语义检索系统,允许工作流程调用历史运行、用户首选项和企业文档。 C. 工具和 Web 集成 为了在物理或数字世界中采取行动,法学硕士必须与外部服务交互。该模型需要访问数据库驱动程序、文件系统、Web 浏览器和第三方 API。现代工作流程越来越多地采用模型上下文协议 (MCP),标准化法学硕士如何发现并安全连接到上下文数据源和执行沙箱。
AI Agents LLMs Orchestration Software Architecture Machine Learning
高性能 RAG 的高级检索技术:优化 LLM 支持的系统

高性能 RAG 的高级检索技术:优化 LLM 支持的系统

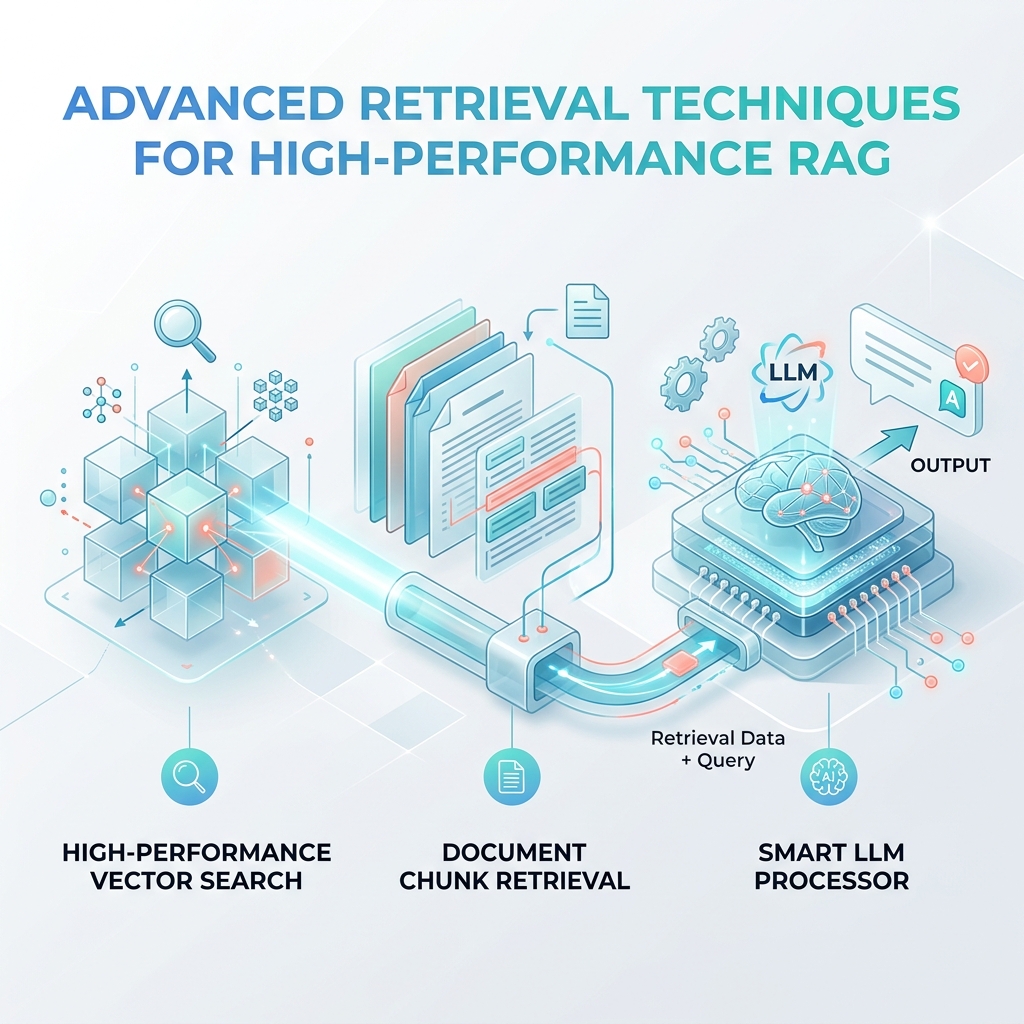
检索增强生成(RAG)已成为企业人工智能应用的支柱,但随着系统规模和查询变得更加复杂,基本的检索方法已经不够用了。缓慢且不准确的 RAG 系统与高性能系统之间的区别通常取决于检索策略。 本综合指南探讨了先进的检索技术,可显着提高 RAG 性能、准确性和可扩展性。无论您是构建客户支持机器人、知识助理还是企业搜索系统,这些策略都将改变您的 RAG 管道。 1. 了解检索瓶颈 在优化之前,我们先确定 RAG 系统通常会出现故障的位置: 低召回率:由于矢量搜索未找到相关文档而丢失。 排名不佳:找到文档,但将不相关的文档排在第一位。 延迟问题:大型数据集上的向量相似性搜索速度缓慢。 上下文不匹配:检索到的块缺乏足够的上下文,无法让 LLM 生成准确的响应。 查询-文档语义差距:用户的查询与文档嵌入不一致。 这些问题大规模地复杂化。检索准确度为 90% 的系统检索 5 个文档可能会错过关键信息,从而完全改变 LLM 的响应。 2. 混合搜索:向量检索和关键词检索相结合 对生产 RAG 最有影响力的改进是混合搜索,它结合了: 矢量搜索:语义相似性(查询意味着什么) 关键字搜索 (BM25):精确术语匹配(查询说什么) 为什么混合搜索有效 想象一下搜索“Python 机器学习库”。如果文档不强调术语“Python”,纯向量搜索可能会错过有关“scikit-learn”或“TensorFlow”的文档。相反,BM25 将找到精确匹配,但在同义查询(例如“Python 中的 ML 框架”)上失败。 实施策略 [User Query] │ ├──> [Vector Search] ──> [Top K results] │ │ │ ▼ └──> [BM25 Search] ──> [Top K results] ──> [Merge & Rerank] │ ▼ [Final Ranked Results] 步骤: 1.在嵌入空间中执行向量搜索→检索前K个结果 2. 使用倒排索引执行BM25(关键字)搜索→检索前K个结果 3. 合并两个结果集,删除重复项 4. 应用排名算法(例如,倒数排名融合)来生成最终的排名列表
AI RAG LLMs Vector Search Information Retrieval Machine Learning Performance Optimization
生成式人工智能解释:机器如何学习创造

生成式人工智能解释:机器如何学习创造

生成式人工智能是 21 世纪最具变革性的技术变革之一。与分类、预测或检测的传统人工智能系统不同,生成式人工智能创建——文本、图像、音频、视频、代码,甚至三维结构。它是 ChatGPT 撰写文章、Midjourney 绘画真实感艺术以及 GitHub Copilot 通过评论完成整个功能背后的技术。 本指南解释了什么是生成式人工智能、它的工作原理、支持它的主要模型架构以及它的发展方向。 1.什么是生成式人工智能? 生成式人工智能是指一类人工智能模型,它学习训练数据的统计分布,然后生成遵循相同分布的新内容。 简单地说:如果你用数百万张人脸照片训练一个模型,它就会学习脸部的模式——眼睛的位置、鼻子的形状、皮肤的纹理——然后可以生成一张以前从未存在过的全新脸部。 判别式和生成式模型之间的主要区别: 歧视性人工智能 生成式人工智能 了解班级之间的界限 了解完整的数据分布 输入→标签/类别 输入提示→新增内容(文字、图片、音频) 示例:图像分类器、垃圾邮件过滤器 示例:GPT-4,稳定扩散,Gemini 回答:“这是猫吗?” → 是/否 答案:“生成一幅穿着宇航服的猫的画” 2. 生成式人工智能背后的核心架构 现代生成式人工智能并不是一项单一的技术——它是一系列不同的架构,每种架构都适合不同的领域。 2.1 基于 Transformer 的语言模型 (LLM) Vaswani 等人在 2017 年具有里程碑意义的论文“Attention is All You Need”中介绍的 Transformer 架构是当今所有主要语言模型的基础,包括 GPT-4、Gemini、Claude 和 Llama。 它是如何工作的: 标记化:输入文本被分解为标记(子词单元)。 “生成式人工智能”可能会变成 ["Genera", "tive", " AI"]。 嵌入:每个标记都被转换为捕获其含义的高维数值向量。 自我注意力机制:每个令牌计算与序列中每个其他令牌的关系(注意力分数)。这使得模型能够理解“河岸”中的“银行”与“银行账户”中的“银行”不同。 前馈层:每个位置都经过非线性前馈网络来提取复杂的特征。 下一个标记预测:像 GPT 这样的自回归模型经过训练来预测下一个最可能的标记,重复此过程直到输出完成。 现代法学硕士的规模令人震惊:
AI Generative AI LLMs Deep Learning Machine Learning GPT Diffusion Models
LLM 推理:AI 如何思考、解决问题与进化

LLM 推理:AI 如何思考、解决问题与进化

大型语言模型 (LLM) 席卷全球,不仅因为它们能生成类似人类的文本,还因为它们似乎能通过复杂的“推理”来解决问题。但是,一个基于词元 (token) 预测的统计模型究竟是如何执行逻辑任务 forest? 在这篇文章中,我们将探索 LLM 推理的机制,从简单的模式匹配到思维链 (Chain of Thought - CoT) 等高级策略。 1. 是真正的推理还是仅仅是预测? 从本质上讲,LLM 被训练用于预测序列中的下一个词元。然而,随着这些模型规模(参数量)的增长,开始出现涌现属性。研究人员发现,模型可以解决数学问题、编写代码并遵循复杂的指令——这些任务需要的不仅仅是记忆。 这通常被称为**“涌现推理”**。虽然模型不像人类那样“思考”,但其内部的语言表示包含足够的逻辑结构来模拟推理步骤。 2. 突破:思维链 (CoT) LLM 推理中最显著的进展之一是思维链 (CoT) 提示。CoT 不直接询问最终答案,而是鼓励模型生成中间步骤。 CoT 的工作原理: 分步逻辑: 模型将复杂问题分解为更小、更易于管理的片段。 记忆缓冲: 中间步骤充当工作记忆,允许模型“回溯”到其先前的逻辑。 验证: 通过展示其工作过程,模型不太可能犯下“逻辑跳跃”错误。 3. 系统 1 与系统 2 思维 心理学家丹尼尔·卡尼曼曾著名地描述了人类思维的两个系统: 系统 1: 快速、本能且情绪化(例如识别面部)。 系统 2: 较慢、更深思熟虑且合乎逻辑(例如解数学方程)。 大多数 LLM 主要以“系统 1”模式运行——它们根据概率快速生成文本。目前的研究重点是将 AI 推向系统 2 思维,即模型在输出最终答案之前会暂停、反思并验证其逻辑。 4. 当前局限性 尽管其能力令人印象深刻,但 LLM 在推理方面仍面临重大障碍:
AI LLM 推理 机器学习 思维链 技术
软件开发的未来:AI、自动化与 Ghaznix

软件开发的未来:AI、自动化与 Ghaznix

软件开发的格局正在我们脚下发生翻天覆地的变化。我们已经从编写机器代码演进到了高级抽象,而现在,我们正步入智能自动化时代。 作为开发者,我们的价值不再取决于能编写多少行样板代码(boilerplate),而在于我们如何有效地架构系统,并利用手头最好的工具解决复杂问题。 1. 样板代码的终结 几十年来,开发者每天都要花费大量时间编写“胶水代码”——手动将 JSON 映射到结构体、创建 SQL 模式以及设置重复的验证逻辑。 在 Ghaznix,我们认为花在样板代码上的每一分钟都是对创新的损耗。我们的工具(如 JSON Explorer)旨在消除这些平庸的任务。通过将 JSON 负载立即转换为适用于 Go、Python、Java 等语言的生产就绪模型,我们帮助开发者保持在“心流状态”。 2. AI 是副驾驶,而非替代品 关于 AI 将取代开发者的讨论很多。在 Ghaznix,我们看到了一个不同的未来:增强型开发者 (The Augmented Developer)。 AI 不会取代对逻辑或创造力的需求;相反,它将充当高速助手。无论是使用大语言模型(LLM)调试复杂的边界情况,还是使用像 Ghaznix 这样的专业工具实现数据转换自动化,未来能够脱颖而出的开发者将是那些精通这些数字协同效应的人。 3. 迈向“低劳作”工程 未来属于 Low-Toil Engineering(低劳作工程)。这意味着: 即时脚手架: 使用预生成的类型化模型启动项目。 无缝数据集成: 在不同格式(JSON、SQL、CSV)之间移动数据,无需手动映射。 自动化文档: 让工具来描述你的 API 结构,无需亲自动手。 Ghaznix 处于这一运动的前沿。我们的工具套件秉承一个使命:让你的开发周期更快速、更安全、更愉快。 4. Ghaznix 的下一步是什么? 我们正在不断扩展生态系统,以支持更多语言、更多格式和更深层次的集成。无论你是独立开发者还是大型企业团队的一员,Ghaznix 都在进化,成为你处理数据和生成代码的核心枢纽。 未来是自动化的。你准备好了吗? 探索 Ghaznix 全套工具 →
软件开发 AI 自动化 开发工具 json 技术未来