🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

自然言語処理

固有表現抽出 (NER): 従来の自然言語処理からAI駆動のデータ抽出への進化

固有表現抽出 (NER): 従来の自然言語処理からAI駆動のデータ抽出への進化

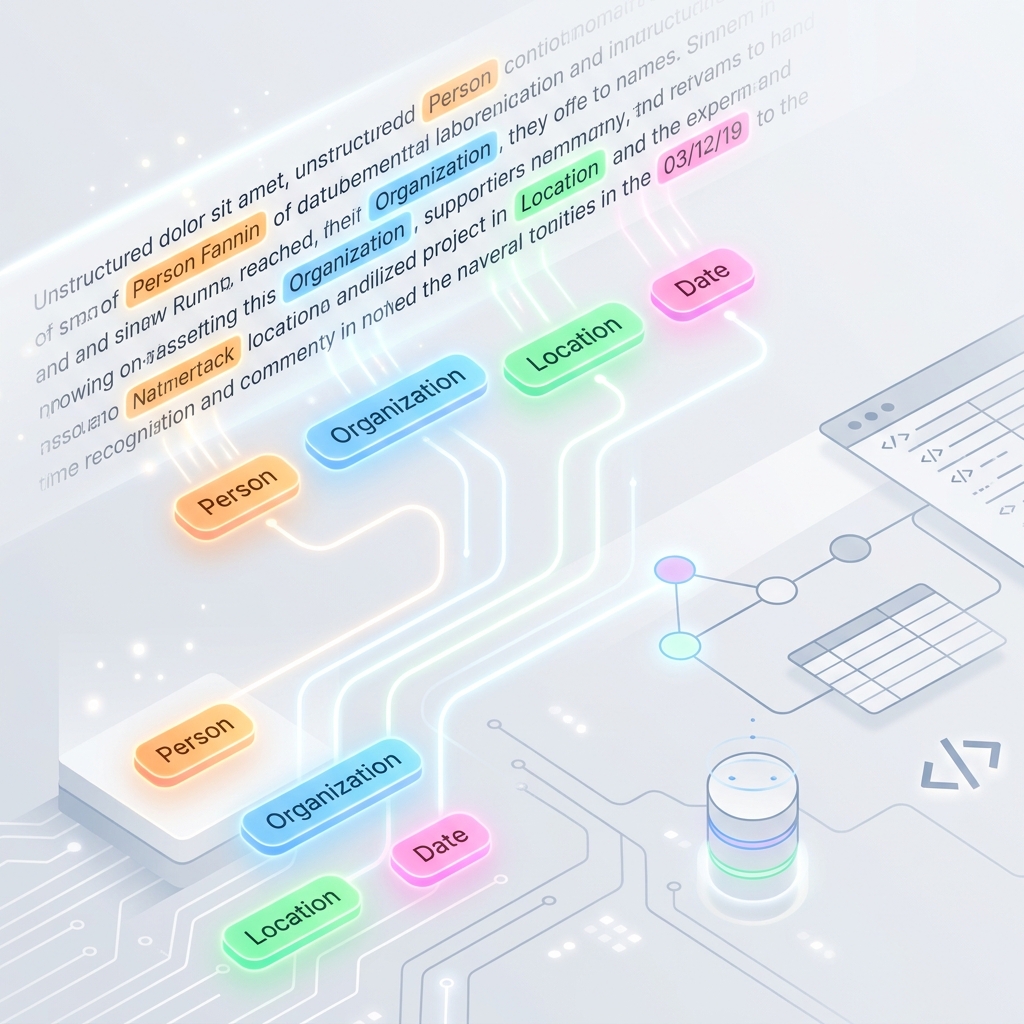
固有表現抽出(Named Entity Recognition: NER)は、自然言語処理(NLP)の基盤技術の一つです。これは、テキストデータなどの非構造化データから、人名、組織名、地名、日付、金銭表現、製品名といった特定のカテゴリに該当する重要な要素を自動的に特定し、分類するプロセスです。 NERがなければ、検索エンジン、レコメンデーションシステム、自動ドキュメント分析システムなどは、テキスト内の「誰が」「何を」「どこで」「いつ」行ったのかを正確に理解することが困難になります。 本記事では、NERの基本概念、技術の進化プロセス、そしてなぜ現代の生成AIがエンティティ抽出を完全に変革したのかについて詳しく解説します。 1. NER技術の進化プロセス AIベースのNERがなぜこれほど革新的なのかを理解するために、過去数十年間におけるエンティティ抽出技術の歩みを振り返りましょう。 第1世代:ルールベースおよび辞書ベースのシステム 初期のNERは、正規表現(regex)や人手で管理された辞書(gazetteer)に依存していました。 仕組み: 抽出対象の単語が地名データベースに存在する場合や、電話番号のようなパターン(例:[3桁]-[3桁]-[4桁])に一致する場合に抽出されます。 限界: 非常に脆弱です。スペルミスや新しいエンティティ、文脈による意味の違いに対応できません。例えば、「Apple」が果物の「リンゴ」を指しているのか、IT企業の「アップル」を指しているのかを区別できませんでした。 第2世代:従来の機械学習 (CRF & SVM) 2000年代に入ると、条件付き確率場(CRF)やサポートベクターマシン(SVM)などの統計的機械学習モデルが主流となりました。 仕組み: 開発者が手動で特徴量(例:接頭辞、接尾辞、大文字・小文字のパターンなど)を設計し、ラベル付けされた訓練データを用いてトークンがエンティティの一部である確率を予測します。 限界: 大量のラベル付きデータが必要であり、手動での特徴量設計には膨大な労力がかかりました。 第3世代:ディープラーニング (BiLSTM-CRF & BERT) ディープラーニングの台頭に伴い、双方向LSTM(BiLSTM)とCRFを組み合わせたモデルや、その後のBERTに代表されるTransformerモデルがNLPに革命をもたらしました。 仕組み: 単語埋め込み(Word Embeddings)がセマンティックな意味を捉え、深層ニューラルネットワークが文脈を理解します。BERTベースのモデルは、前後の文脈から「Apple launched a new iPhone」の中の「Apple」を組織として識別できるようになりました。 限界: 依然としてドメイン固有のデータセットに対する教師ありのファインチューニングが必要であり、事前に定義されていない新しいカテゴリのエンティティを再学習なしで抽出することは困難でした。 第4世代:生成AIとLLMベースのNER 現在、Gemini、GPT-4、Llama 3などの大規模言語モデル(LLMs)は、セマンティックな理解と指示追従能力によってNERを処理します。 仕組み: Zero-shotまたはFew-shotのプロンプトエンジニアリングを使用して、ユーザーは任意のエンティティタイプを指定し、それをJSONなどの構造化データとして返却するようにLLMへ指示できます。 選ばれる理由: 複雑な構文を理解し、スペルミスに対応でき、曖昧な文脈を推論し、開始にあたっての訓練データを一切必要としません。 2. AIベースのNERと従来のNERの比較 特徴 従来のNER (BERT / CRF) AIベースのNER (LLMs) 必要な学習データ 大量(数千以上のラベル付きデータ) 不要〜極少量(Zero-shot / Few-shot) 柔軟性 低い(学習済みのカテゴリのみ抽出) 極めて高い(プロンプト内で任意のカテゴリを定義可能) 文脈理解 中程度(局所的なコンテキストウィンドウ) 深い(ドキュメント全体のコンテキストや意図を理解) 未知語(OOV)への対応 苦手(未学習の単語に苦戦) 得意(セマンティックな推論を利用) 処理速度とコスト 高速・安価(小型のCPU/GPUでローカル実行可能) 低速・比較的高コスト(大規模モデルの推論が必要) 3. AIベースのNERの主な応用分野 AIベースの固有表現抽出は、単なるテキストのハイライトにとどまりません。非構造化テキストを構造化されたアクション可能なJSONデータに変換することで、強力な自動化を実現します。
AI 固有表現抽出 自然言語処理 機械学習 大規模言語モデル
GPT トランスフォーマーの仕組み:因果自己注意機構(Causal Self-Attention)の解説

GPT トランスフォーマーの仕組み:因果自己注意機構(Causal Self-Attention)の解説

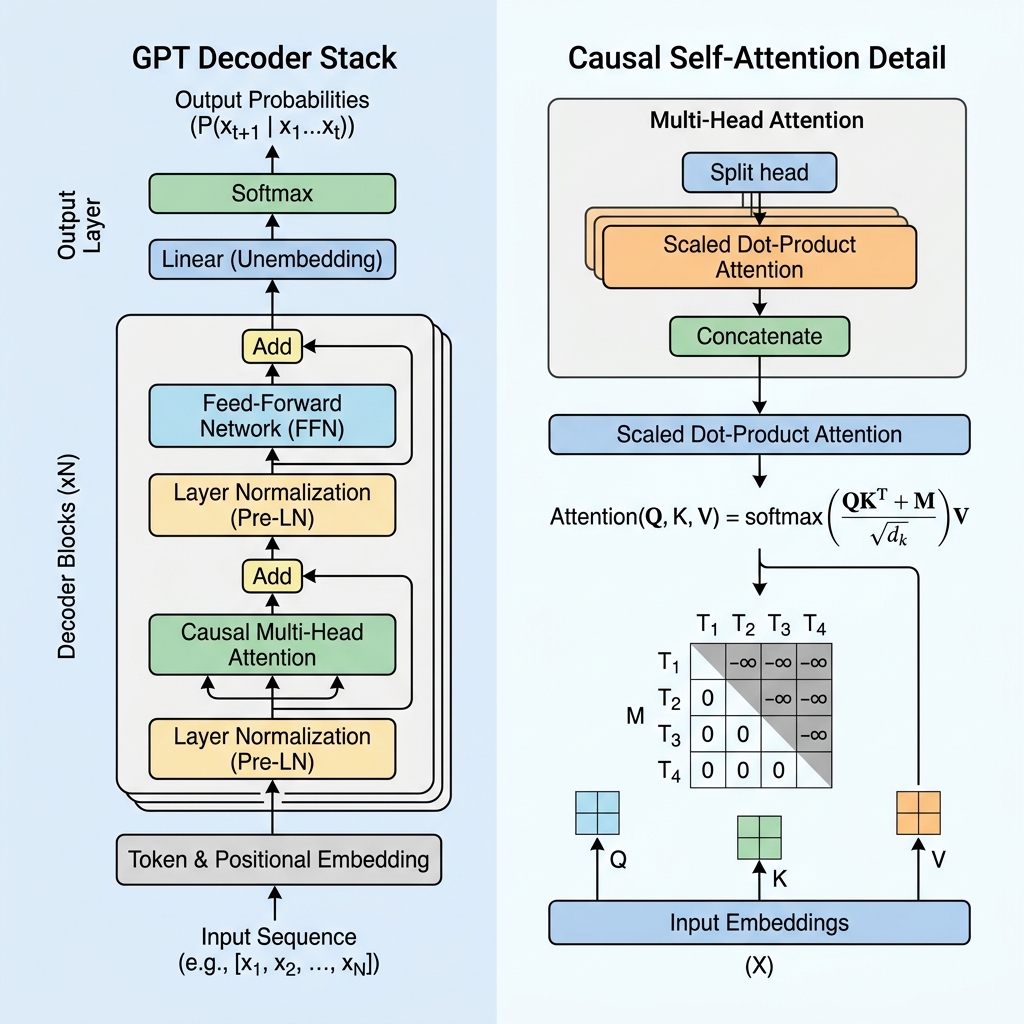
GPT トランスフォーマーの仕組み:因果自己注意機構(Causal Self-Attention)の解説 近年、Generative Pre-trained Transformers(GPT)は人工知能に革命をもたらしました。コーディングアシスタントから対話型エージェントに至るまで、GPTベースのモデルは今日の最も先進的な生成アプリケーションを支えています。しかし、このテクノロジーは実際にどのように機能しているのでしょうか? 双方向に理解するのに対し、GPTは自己回帰的(autoregressive)な次のトークン予測のために設計された**デコーダー専用(Decoder-only)**のアーキテクチャです。このブログでは、GPTトランスフォーマーの仕組みを解き明かし、因果自己注意機構(causal self-attention)を深く掘り下げ、コードで実装します。 1. 自己回帰的な生成ループ 本質的に、GPTは自己回帰モデルです。これは、テキストのシーケンスを生成するために、すでに生成されたトークンを次の予測のコンテキストとして使用しながら、次のトークンを1つずつ予測することを意味します。 ワークフローは以下の手順に従います。 入力 (Input): モデルはプロンプトを受け取ります。例:"Deep learning is"。 予測 (Prediction): モデルはこのプロンプトを処理し、語彙全体に対する確率分布を出力します。次のトークンをサンプリングします。例:"awesome"。 ループ (Loop): 新しいトークンが入力に追加され、"Deep learning is awesome"になります。このシーケンスが次のステップの入力になります。 終了 (Termination): モデルが特殊なシーケンス終了([EOS])トークンを出力するか、定義された長さ制限に達するまで、プロセスが繰り返されます。 2. 因果マスキング:デコーダーの核心 BERTのようなエンコーダー専用モデルでは、すべてのトークンが過去と未来の両方を見渡して、他のすべてのトークンに注意を向けることができます。しかし、次のトークンを予測する生成モデルにとって、トレーニング中に未来を見ることは「カンニング」になります。 モデルが未来のトークンを見るのを防ぐために、GPTは因果自己注意(Causal Self-Attention)(またはマスクされた自己注意)を使用します。 因果マスク行列 自己注意の計算中、クエリ(Queries, $Q$)とキー(Keys, $K$)の点積を取ることで、トークン間の類似度スコアを計算します。 $$\text{Scores} = QK^T$$ 因果性を強制するために、対角線より上のすべての値が $-\infty$(負の無限大)に設定され、対角線上およびそれ以下の値が 0 であるマスク行列 $M$ を適用します。softmax関数を適用する前に、このマスクをスコアに加算します。 $$\text{Masked Scores} = \frac{QK^T}{\sqrt{d_k}} + M$$ $$M = \begin{pmatrix} 0 & -\infty & -\infty & \dots & -\infty \\ 0 & 0 & -\infty & \dots & -\infty \\ 0 & 0 & 0 & \dots & -\infty \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & 0 & \dots & 0 \end{pmatrix}$$
GPT トランスフォーマー 生成AI 因果自己注意 自然言語処理
Sequence-to-Sequence(Seq2Seq)アーキテクチャとアテンションメカニズムの仕組み

Sequence-to-Sequence(Seq2Seq)アーキテクチャとアテンションメカニズムの仕組み

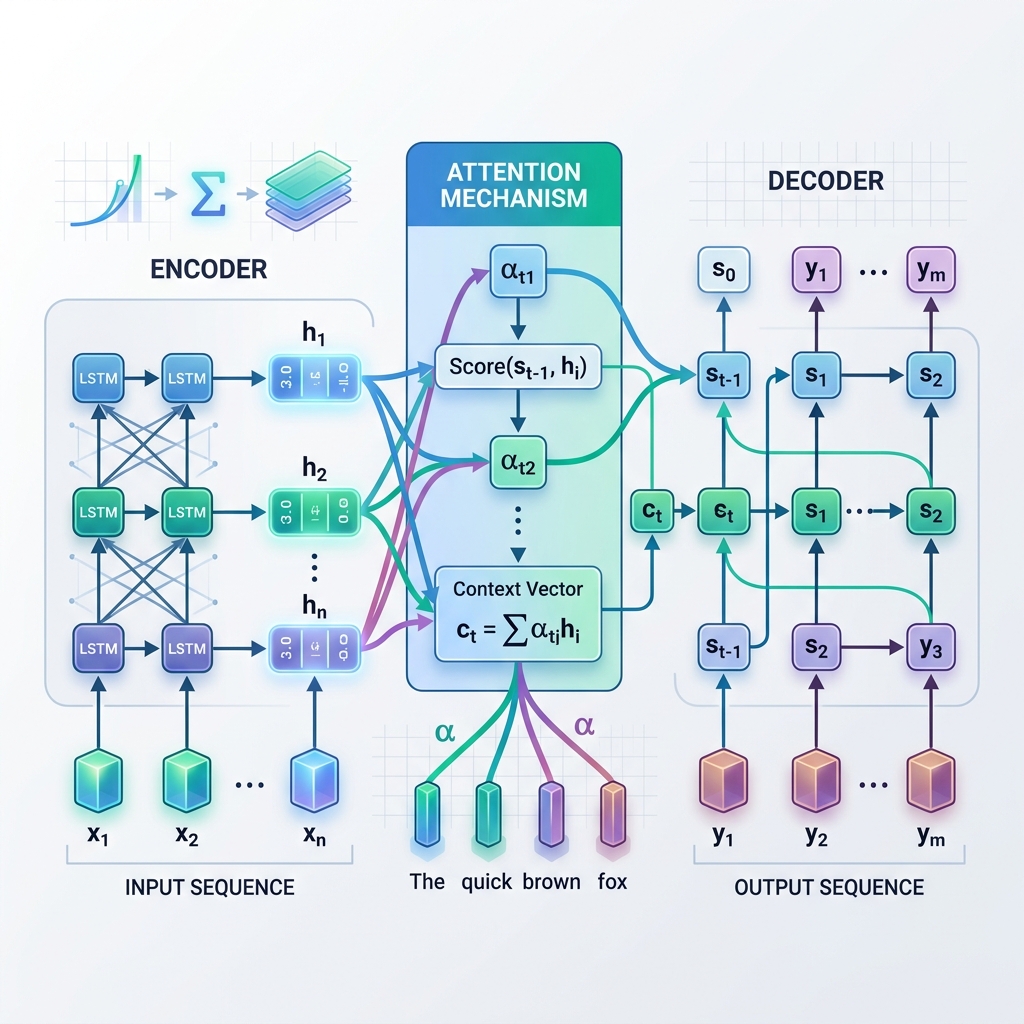
自然言語処理(NLP)および人工知能(AI)の領域において、言語の翻訳、文章の要約、対話の生成を行う能力は劇的な革命を遂げました。この変革の中心に位置するのが、**Sequence-to-Sequence(Seq2Seq)アーキテクチャと、先駆的なアテンションメカニズム(Attention Mechanism)**です。 現代の Transformer が登場する前、これら2つのイノベーションは、入力配列と出力配列の長さが異なる場合にそれらをマッピングするという、ディープラーニングにおける最大の課題の1つを解決しました。 1. 基礎:Sequence-to-Sequence(Seq2Seq)とは何か? 2014年にGoogleなどの研究者によって発表されたSequence-to-Sequence(Seq2Seq)モデルは、時系列データを処理するために設計されたエンコーダー・デコーダー(Encoder-Decoder)フレームワークです。入力配列の長さと出力配列の長さが一致しない以下のようなタスクで広く使用されています: 機械翻訳: 英語の “How are you?"(3単語)を日本語の「お元気ですか?」(6文字)やスペイン語の “¿Cómo estás?"(2単語)に翻訳する。 テキスト要約: 500単語の論文を50単語の要約に圧縮する。 質問応答: 質問の配列を回答の配列にマッピングする。 エンコーダー・デコーダーの仕組み 標準的なSeq2Seqモデルは、一般的にLSTM(Long Short-Term Memory)またはGRU(Gated Recurrent Units)と呼ばれる2つの再帰型ニューラルネットワーク(RNN)で構成されています: エンコーダー(Encoder): 入力配列をトークンごとに順次処理します。各ステップで、現在の入力トークンと前の隠れ状態に基づいて、自身の隠れ状態(hidden state)を更新します。入力全体が処理されると、エンコーダーの最後の隠れ状態が取得されます。この最終状態は文脈ベクトル(Context Vector)(またはボトルネックベクトル)と呼ばれます。 デコーダー(Decoder): 文脈ベクトルを初期の隠れ状態として受け取り、出力配列を自帰的にトークンごとに生成します。各ステップで、現在の隠れ状態と以前に生成された単語に基づいて、次の単語を予測します。 2. ボトルネック問題(Information Bottleneck) クラシックなエンコーダー・デコーダーモデルは大きなブレイクスルーであったものの、情報ボトルネックとして知られる根本的な限界を抱えていました。 標準的なSeq2Seqモデルでは、エンコーダーは入力文全体の意味を(それが5単語であれ100単語であれ)、固定サイズの単一の文脈ベクトルに圧縮することを強制されます。 その結果: 長期記憶の喪失: 長い文章では、エンコーダーが終端に達する頃には、配列の初期部分の情報が失われてしまいます。 性能の低下: 入力文の長さが長くなるにつれて、翻訳や要約の品質が著しく低下します。 複雑な段落を単一のベクトルに圧縮することは、本の一章全体を翻訳する前に、一言の文章で要約しようとするようなものです。情報は必然的に失われます。 3. アテンションメカニズム:パラダイムシフト 情報ボトルネックを解決するため、Dzmitry Bahdanau(バダナウ)ら研究グループは2015年に**アテンションメカニズム(注意機構)**を導入しました。 エンコーダーの最終ステップから得られる単一の静的な文脈ベクトルのみに依存する代わりに、アテンションはデコーダーがデコードプロセスの各ステップでエンコーダーのすべての隠れ状態を**「振り返る」**ことを可能にします。これは、モデルが現在生成している単語に応じて、入力配列の異なる部分に動的に焦点を当てる(注意を向ける)ことを意味します。 アテンションの仕組み:ステップ・バイ・ステップ 各デコードステップ $t$ において: アライメントスコアの計算 ($e_{t, j}$): デコーダーの現在の隠れ状態 $s_{t-1}$ と、エンコーダーの各隠れ状態 $h_j$ を比較し、エンコーダーの状態 $j$ がデコーダーの現在のステップにどれだけ関連しているかを測定します。 $$e_{t, j} = \text{score}(s_{t-1}, h_j)$$ アテンション重みの計算 ($\alpha_{t, j}$): アライメントスコアを softmax 関数を使用して正規化し、合計が1になる確率(重み)に変換します。 $$\alpha_{t, j} = \frac{\exp(e_{t, j})}{\sum_k \exp(e_{t, k})}$$ 動的文脈ベクトルの生成 ($c_t$): エンコーダーのすべての隠れ状態の加重平均として、文脈ベクトルを計算します。 $$c_t = \sum_j \alpha_{t, j} h_j$$ トークンの予測: デコーダーは動的文脈ベクトル $c_t$ と現在の状態 $s_t$ を組み合わせて、次の出力トークンを予測します。 4. Seq2Seqとアテンションメカニズムの詳細な解説 これらのメカニズムの背後にある技術を真に理解するために、まず古典的な Sequence-to-Sequence アーキテクチャの数学的および操作的なステップを辿り、続いて Bahdanau(加算)と Luong(乗算)の両方のアテンション手法について解説します。
Seq2Seq アテンションメカニズム ディープラーニング 自然言語処理 人工知能
アラビア語の感情分析:実践的なNLP前処理とモデルのウォークスルー

アラビア語の感情分析:実践的なNLP前処理とモデルのウォークスルー

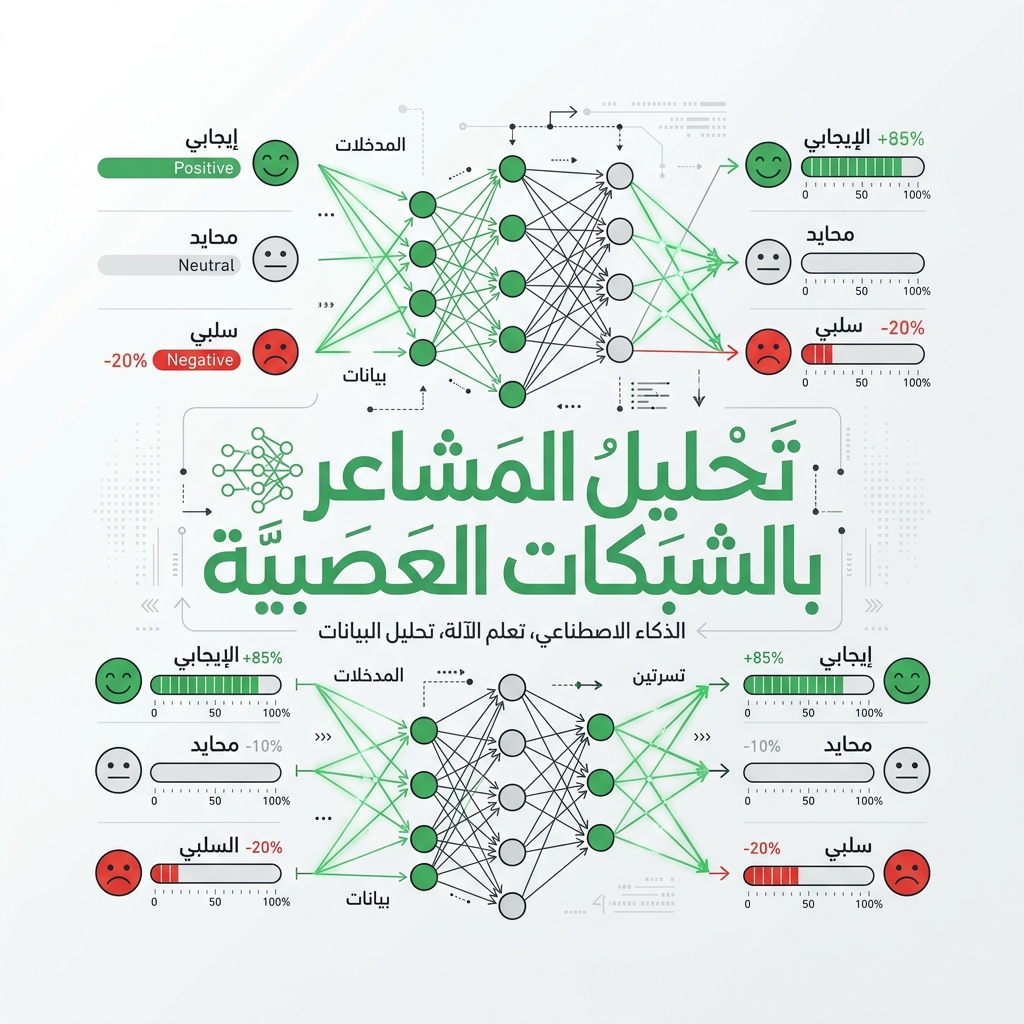
グローバル化したデジタルコミュニケーションの時代において、テキストの背後にある感情的なトーンを特定するタスクである「感情分析」は、企業、政府、研究者にとって不可欠なものとなっています。英語などの言語では感情分析は非常に成熟していますが、これをアラビア語に適用するには、言語的および技術的な独自の課題が存在します。 4億人以上の話者を抱えるアラビア語は、世界で最も広く話されている言語の一つです。しかし、その豊かな形態構造、ダイグロッシア(標準語と口語の共存)、そして複雑な文字システムには、専門的な前処理とモデリング戦略が必要です。 このガイドでは、アラビア語の感情分析の包括的なウォークスルーを提供し、課題、前処理パイプライン、古典的な機械学習の実装(TF-IDF + ロジスティック回帰)、およびHugging FaceのTransformersを使用した現代的なディープラーニングアプローチについて詳しく説明します。 1. アラビア語NLPの言語的課題 コードを書く前に、開発者はなぜアラビア語を標準的な西洋のNLPパイプラインで処理できないのかを理解する必要があります。 ダイグロッシア(二重言語状態): アラビア語は、書き言葉やニュース、公式文書で使用される**現代標準アラビア語(MSA)と、SNSや日常会話で使用される口語方言(ダリジャ/アンミーヤ)**に分かれています。方言(例:エジプト、レバント、湾岸方言)は、語彙、文法、感情表現において大きく異なります。 豊かな形態論: アラビア語は語根ベースの言語であり、パターンを適用することにより、3文字または4文字の語根から単語が派生します。単一の単語に、代名詞、前置詞、時制を表す接頭辞、接尾辞、接中辞が含まれることがあります(例:وسيكتبونها - 「そして彼らはそれを書くでしょう」)。 表記の揺れ: アラビア語の文字は位置によって形が変わることが多く、ユーザーは特定の文字を互換的に使用することがよくあります(例:أ、إ、آ、اなどのアリフの形状や、ىに対するيなどのヤーの形状)。 シャクル(記号): 短母音は、文字の上または下に付く補助記号(ファトハ、ダンマ、カスラなど)として書かれます。これらは意味を明確にしますが、デジタルテキストでは省略されることが多く、曖昧さの原因となったり、不整合に追加されてデータの希薄化を招いたりします。 2. アラビア語NLPパイプライン アラビア語テキストを処理するには、正規化、記号の除去、トークン化、ステミング(語幹抽出)、モデル推論を処理する専用のパイプラインを構築する必要があります。 graph TD A[生のアラビア語テキスト] --> B[正規化とクリーニング] B --> C[記号と句読点の削除] C --> D[トークン化] D --> E[ステミング / レマタイゼーション] E --> F[特徴量のベクトル化 / 埋め込み] F --> G[感情分類器] G --> H[出力:ポジティブ / ネガティブ / ニュートラル] 3. ウォークスルー:古典的な前処理と機械学習(Python) Python、NLTK、およびscikit-learnを使用して完全なパイプラインを実装してみましょう。カスタムの正規化ルールを記述し、NLTKのISRIStemmer(アラビア語専用に設計された情報検索用ステマー)を使用します。
自然言語処理 NLP 感情分析 アラビア語AI Transformers Python 機械学習