🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

Transformer

Come funciona il modello Transformer di Gemini: GQA, SwiGLU e multimodalità nativa

Come funciona il modello Transformer di Gemini: GQA, SwiGLU e multimodalità nativa

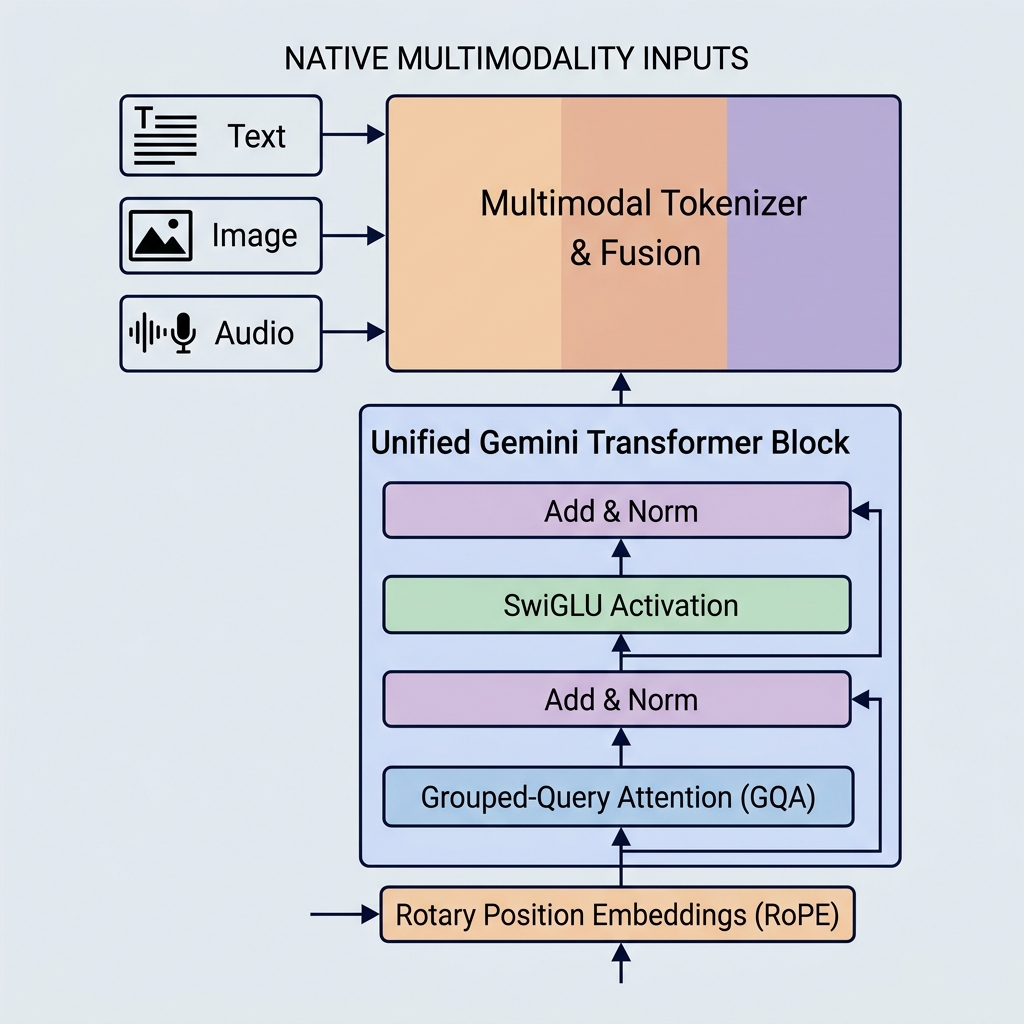
I modelli Gemini di Google hanno stabilito nuovi standard di riferimento nelle capacità dell’IA introducendo multimodalità nativa, enormi finestre di contesto e ottimizzazioni architetturali chiave. A differenza dei modelli più vecchi como GPT-3 o BERT, Gemini è costruito per gestire diversi tipi di dati fin dal primo giorno e utiliza meccanismi di attenzione altamente efficienti.
Gemini Transformer GQA SwiGLU Multimodalità Deep Learning
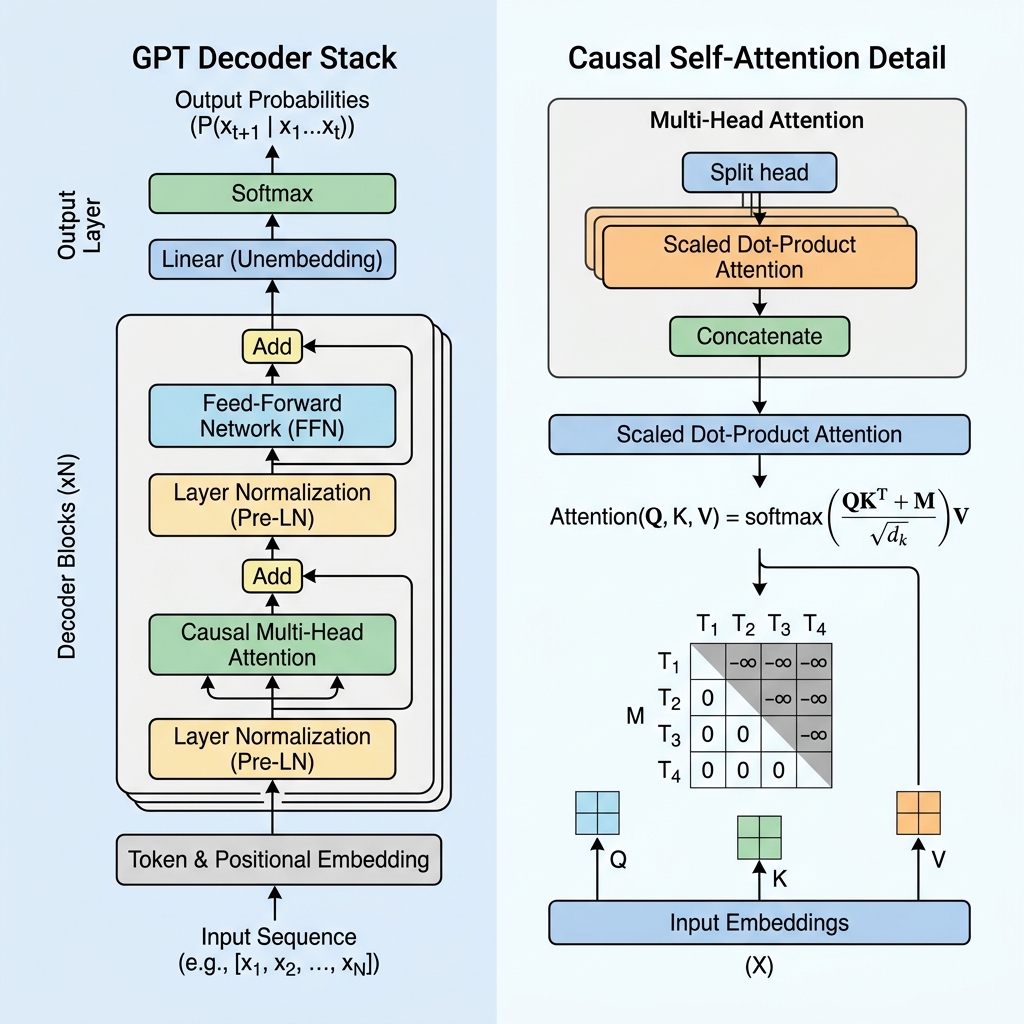
Come funziona il GPT Transformer: Spiegazione della Causal Self-Attention

Come funziona il GPT Transformer: Spiegazione della Causal Self-Attention

Negli ultimi anni, i Generative Pre-trained Transformers (GPT) hanno rivoluzionato l’intelligenza artificiale. Dagli assistenti di programmazione agli agenti conversazionali, i modelli basati su GPT alimentano oggi le applicazioni generative più avanzate. Ma come funziona effettivamente questa tecnologia? Mentre modelli come BERT utilizzano la parte Encoder del Transformer per comprendere il testo in modo bidirezionale, GPT è un’architettura Decoder-only progettata per la previsione autoregressiva del token successivo. In questo blog demistificheremo il funzionamento del GPT Transformer, approfondiremo il meccanismo di causal self-attention e lo implementeremo nel codice.
GPT Transformer IA Generativa Attenzione Causale NLP
Perché i Transformer hanno sostituito le reti RNN e LSTM

Perché i Transformer hanno sostituito le reti RNN e LSTM

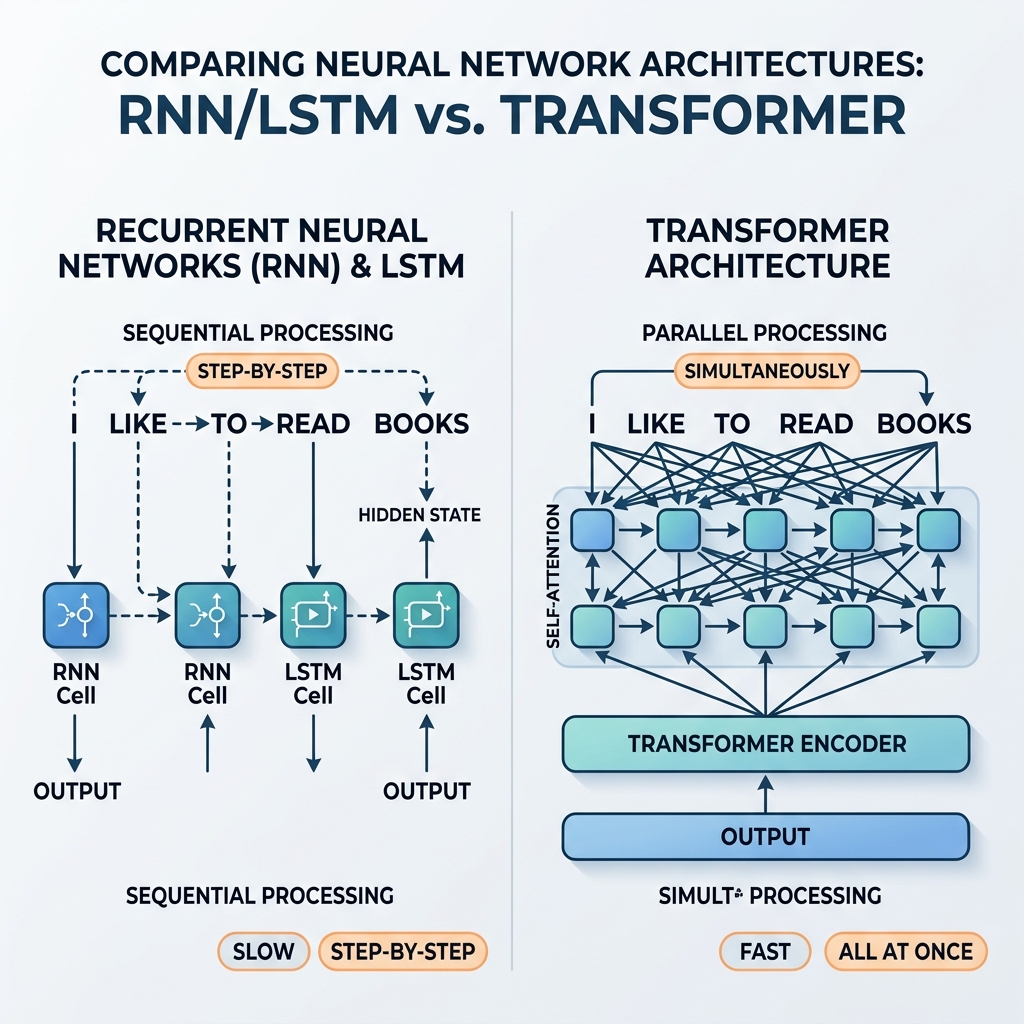
Per anni, le reti neurali ricorrenti (RNN) e le reti Long Short-Term Memory (LSTM) sono state le campionesse indiscusse dell’elaborazione di dati sequenziali. Hanno alimentato sistemi di traduzione all’avanguardia, assistenti vocali e modelli di generazione del testo. Tuttavia, nel 2017, l’articolo seminale “Attention Is All You Need” (Vaswani et al.) ha introdotto l’architettura Transformer. Nel giro di pochi anni, RNN e LSTM sono state quasi interamente eliminate dai modelli di intelligenza artificiale tradizionali.
Transformer RNN LSTM NLP Deep Learning
Comprendere BERT: Rappresentazioni dell'Encoder Bidirezionale dai Transformer

Comprendere BERT: Rappresentazioni dell'Encoder Bidirezionale dai Transformer

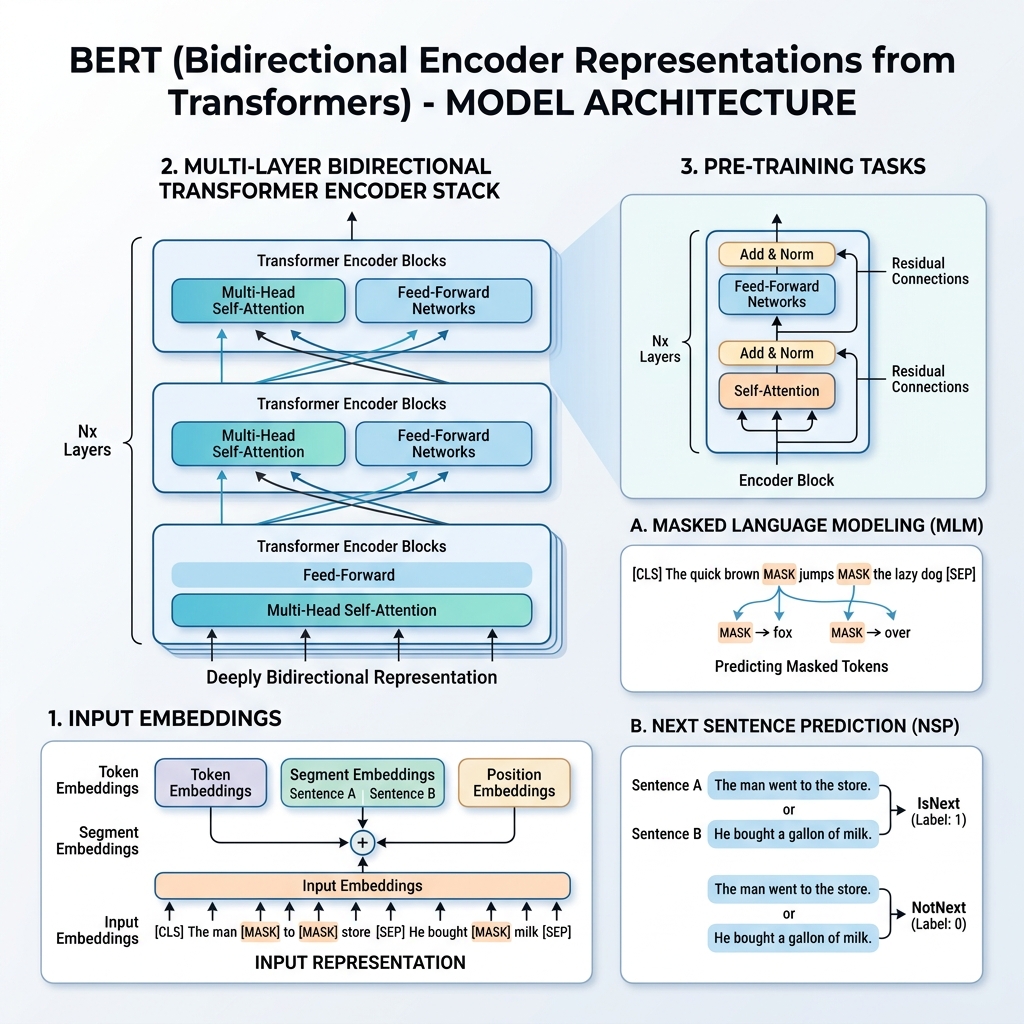
Nel 2018, i ricercatori di Google hanno pubblicato un articolo fondamentale intitolato “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding” (Devlin et al.). Questa ricerca ha cambiato radicalmente il campo del Natural Language Processing (NLP). Prima di BERT, i modelli elaboravano il testo sequenzialmente da sinistra a destra o da destra a sinistra. BERT ha introdotto un metodo per addestrare rappresentazioni linguistiche che guardano contemporaneamente al contesto da entrambe le direzioni.
BERT Transformer NLP Deep Learning Architettura IA
Comprendere le reti Transformer e il meccanismo di Self-Attention

Comprendere le reti Transformer e il meccanismo di Self-Attention

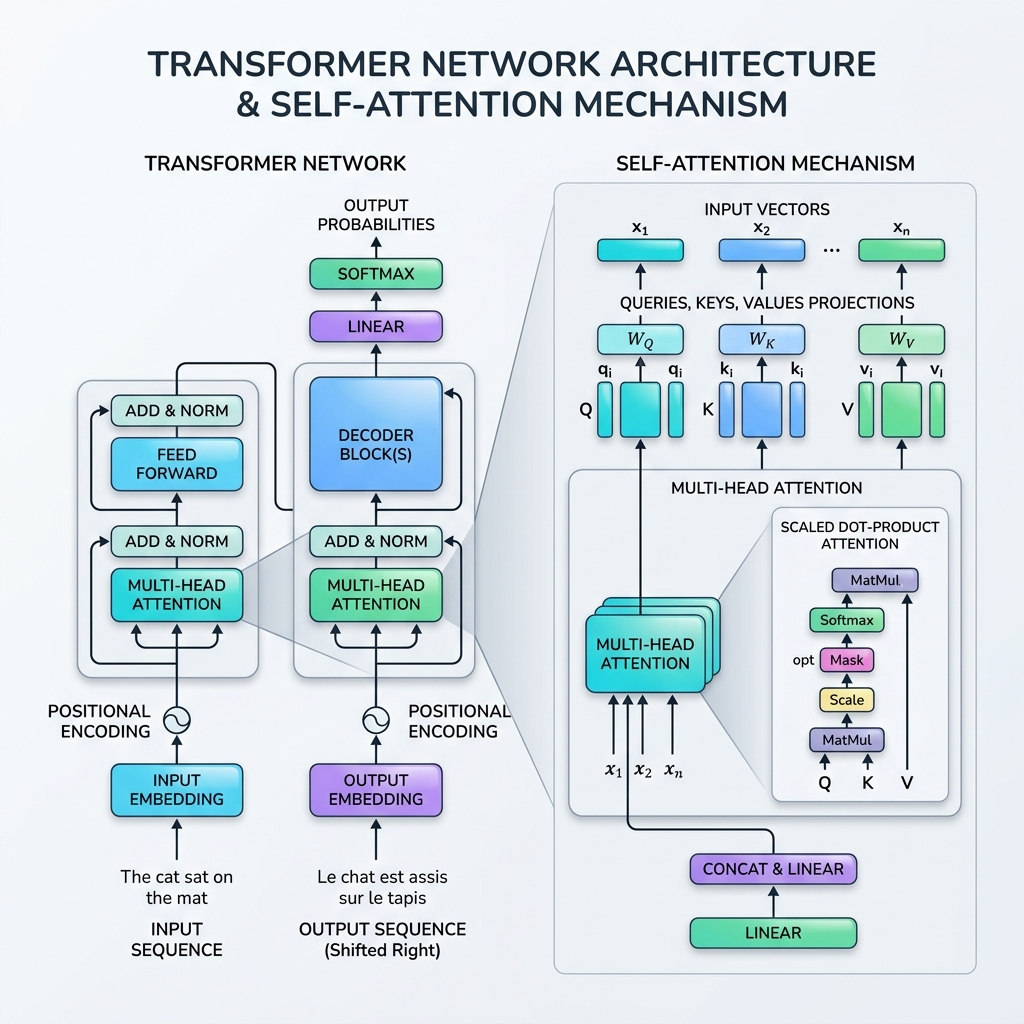
Nel 2017, il panorama dell’intelligenza artificiale è cambiato per sempre con la pubblicazione del seminale articolo “Attention Is All You Need” di Vaswani et al. L’articolo ha introdotto il Transformer, una rivoluzionaria architettura di rete neurale che ha abbandonato completamente la ricorrenza (RNN, LSTM), optando invece per l’elaborazione in parallelo di dati sequenziali tramite il Meccanismo di Self-Attention.
Transformer Self-Attention Deep Learning NLP Architettura IA