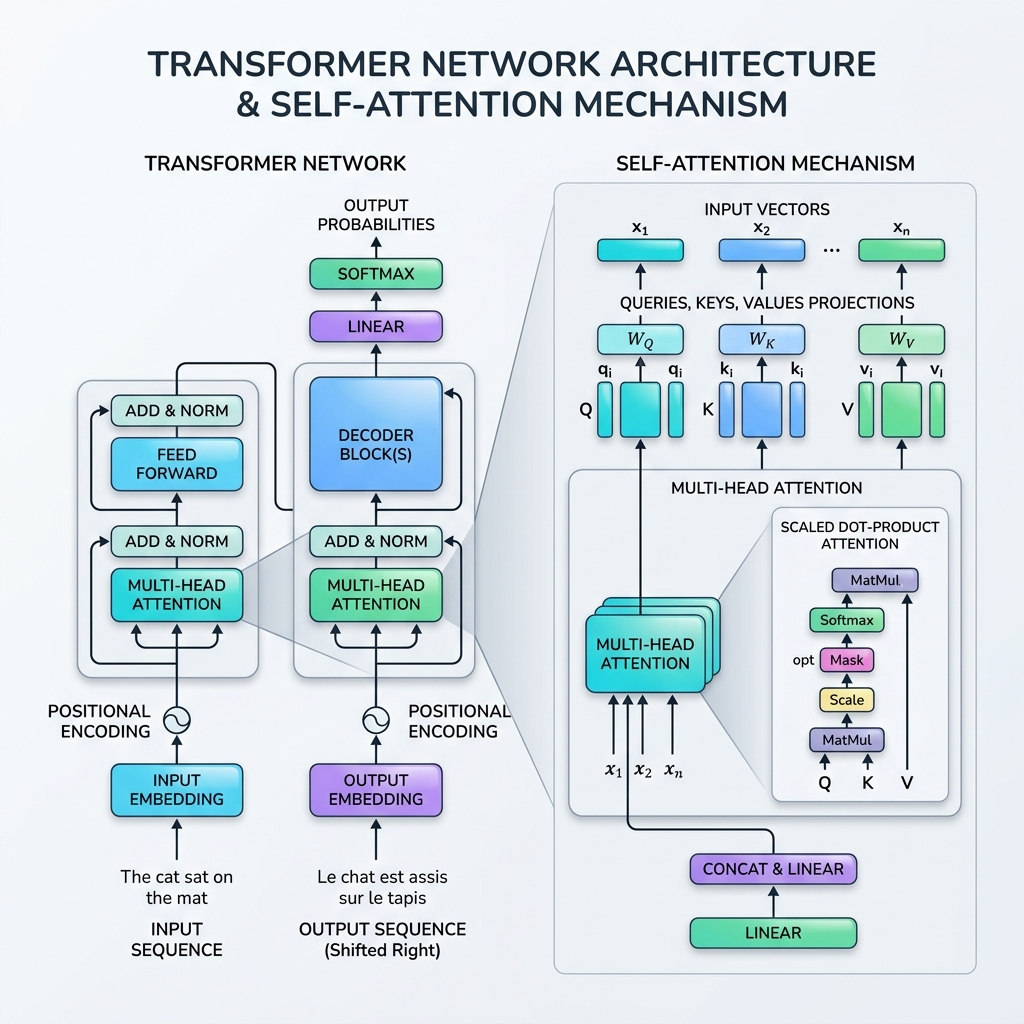
Transformer ネットワークと自己アテンション(Self-Attention)メカニズムの理解
2017年、Vaswaniらによるマイルストーン的な論文 “Attention Is All You Need” の発表によって、人工知能の地平は永遠に塗り替えられました。この論文は、従来の再帰型構造(RNN、LSTM)を完全に排除し、自己アテンション(Self-Attention)メカニズムを用いてシーケンスデータを並列処理する、革命的なニューラルネットワークアーキテクチャ Transformer を提案しました。
今日、Transformer は GPT-4、Gemini、Claude、Llama をはじめとする、ほぼすべての最先端の大規模言語モデル(LLM)の原動力となっています。このブログでは、Transformer ネットワークの仕組みを紐解き、自己アテンションメカニズムが数学的および実践的にどのように実装されているかを解説します。
1. 順次処理のボトルネック(RNN と Transformer の比較) Transformer 以前は、リカレントニューラルネットワーク(RNN)や長短期記憶(LSTM)ネットワークがシーケンスモデリング의 標準でした。しかし、RNNはトークンを順次(1単語ずつ)処理します。10番目の単語の隠れ状態を計算するためには、モデルはまず1番目から9番目までの単語の隠れ状態を計算しなければなりません。
この順次処理の性質は、2つの深刻な制限をもたらします。
並列化の欠如: 計算が前のステップの完了を待つ必要があるため、現代のGPUを効率的に活用できません。 勾配消失・爆発問題: 長いシーケンスの初期の情報は、モデルが終端に達するまでに圧縮され、失われてしまいます(ボトルネック問題)。 Transformer はこれら両方の問題を解決します。再帰を Self-Attention に置き換えることで、Transformer は入力シーケンス全体を同時に処理し、大規模な並列化と、距離に関係なくシーケンス内の任意の2つのトークン間の直接的な結合経路を可能にします。
2. 自己アテンション(Self-Attention)メカニズムとは? 自己アテンションは、同じシーケンス内の異なる単語間の関係性をモデルが評価できるようにする仕組みです。単語を単独で処理するのではなく、文中の他のすべての単語からコンテキストを取り入れることで、各単語を表現します。
例えば、次の文章を考えてみましょう。
“The bank of the river was muddy."(川の土手は泥だらけだった。) “The money was deposited in the bank."(お金は銀行に預けられた。) 「bank」という単語は、文脈によって異なる意味を持ちます。自己アテンションにより、モデルは最初の文では「river(川)」を、2番目の文では「money(お金)」を見ることで、「bank」の表現を正しく調整できます。
データベースのアナロジー:クエリ(Q)、キー(K)、値(V) 自己アテンションの数学的定式化は、情報検索(データベース)のルックアップをモデルにしています。各入力トークンについて、3つのベクトル表現を投影します。
クエリ (Query, $Q$): 現在のトークンが「探している」もの。 キー (Key, $K$): シーケンス内のトークンの「ラベル」またはプロファイル。 値 (Value, $V$): トークンの実際のコンテンツまたは情報。 アテンションメカニズムは、Query とすべての Keys の間の類似度スコアを計算し、これらのスコアを重みに正規化して、Values の加重和を返します。
Transformer
Self-Attention
ディープラーニング
NLP
AIアーキテクチャ