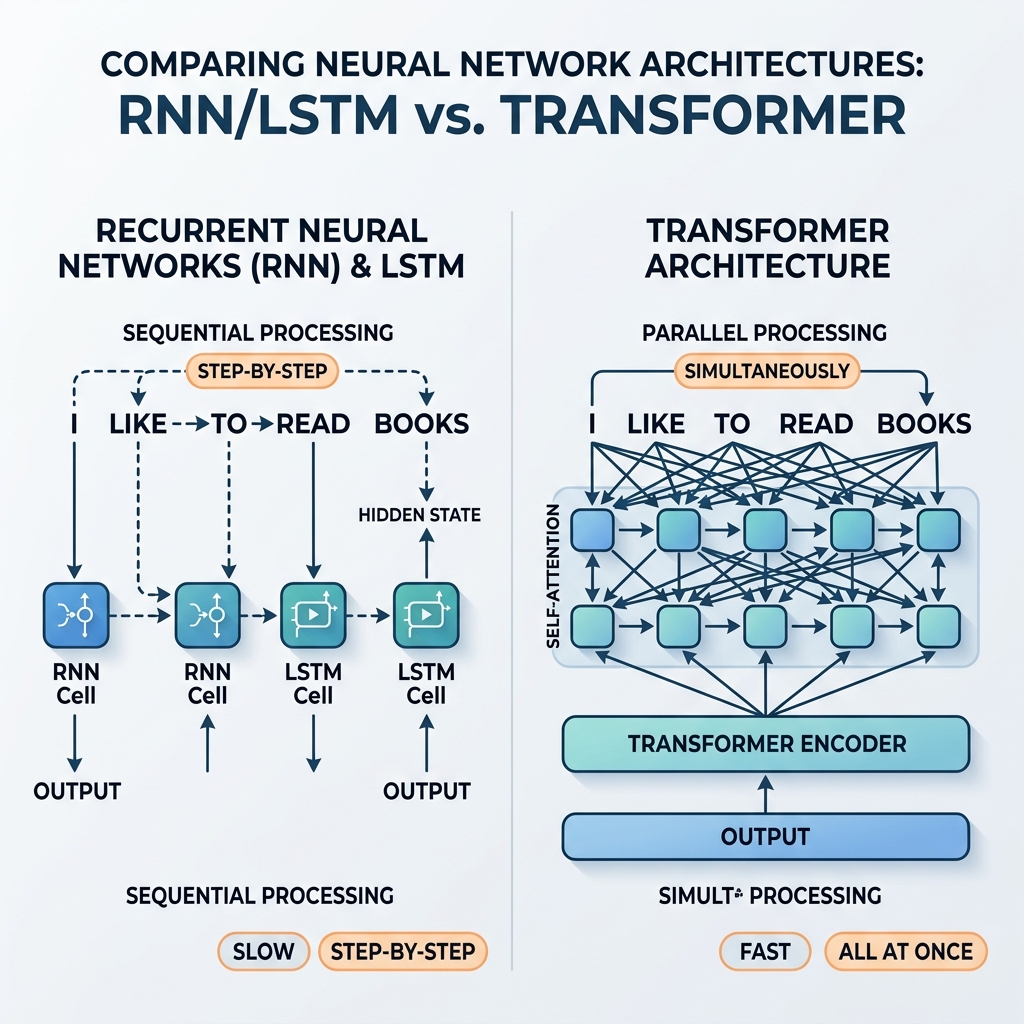
なぜTransformerがRNNやLSTMに取って代わったのか
長年にわたり、リカレントニューラルネットワーク(RNN)と長短期記憶(LSTM)ネットワークは、シーケンシャルデータ処理の絶対的な王者でした。これらは、最先端の翻訳システム、音声アシスタント、およびテキスト生成モデルを支えていました。しかし、2017年に発表された画期的な論文 「Attention Is All You Need」(Vaswaniら)によって、Transformerアーキテクチャが導入されました。その後数年で、RNNやLSTMは主流のAIモデルからほぼ完全に姿を消しました。
なぜこれほど急速な移行が起こったのでしょうか?Transformerがリカレント構造に対して構造的に優れている理由は何でしょうか?この記事では、RNN/LSTMの数学的およびアーキテクチャ的なボトルネックと、Transformerがそれらをどのように克服したかを探ります。
1. 核心的なボトルネック:シーケンシャル処理の限界 RNNを定義する最大の特徴は、その再帰的な状態遷移です。入力シーケンスを処理するために、ネットワークは各トークンを一度にステップずつ処理し、現在の入力 $x_t$ と直前の隠れ状態 $h_{t-1}$ に基づいて、内部の隠れ状態 $h_t$ を更新します。
数学的な再帰関係は次のように表されます。
$$h_t = \tanh(W_{hh} h_{t-1} + W_{xh} x_t + b)$$
並列化の問題 $h_t$ は直接 $h_{t-1}$ に依存するため、処理を並列化することができません。文の中の100番目の単語の状態を計算するには、ネットワークは最初の99個の状態を順番に計算しなければなりません。
GPUやTPUが大規模な並列行列計算をサポートするように進化するにつれて、このシーケンシャルな依存関係は重大なボトルネックになりました。大規模なWebデータセットで深いRNNモデルをトレーニングするのには何週間もかかりましたが、計算が独立していれば、ハードウェアはより高速に動作する能力を持っていました。
2. 情報のボトルネック:勾配消失問題 シーケンス長 $N$ が増加するにつれて、時間を介した誤差逆伝播法(BPTT)では、再帰重み $W_{hh}$ との行列積を繰り返す必要があります。$W_{hh}$ の最大固有値が1未満の場合、勾配は指数関数的に縮小します(勾配消失)。1より大きい場合、それらは指数関数的に増加します(勾配爆発)。
$$\frac{\partial E_t}{\partial h_1} = \frac{\partial E_t}{\partial h_t} \prod_{k=2}^{t} \frac{\partial h_k}{\partial h_{k-1}}$$
LSTMとメモリ制限 LSTMはセル状態とゲート機構(忘却ゲート、入力ゲート、出力ゲート)を導入し、勾配が線形に流れるようにすることで勾配消失を緩和しました。しかし、LSTMであっても数百トークンを超える長さのシーケンスでは苦戦します。隠れベクトルは、過去のすべてのトークンの履歴を固定サイズの表現に圧縮することを強制されるため、「忘却」効果が生じます。
3. Transformerがどのように再帰問題を解決したか Transformerは再帰を完全に取り除き、自己アテンション(Self-Attention)メカニズムに置き換えました。ステップバイステップの状態伝播の代わりに、自己アテンションはシーケンス内のすべてのトークンが同時に他のすべてのトークンと直接相互作用することを可能にします。
アテンション行列は以下のように計算されます。
$$\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{Q K^T}{\sqrt{d_k}}\right) V$$
Transformers
RNN
LSTM
NLP
ディープラーニング