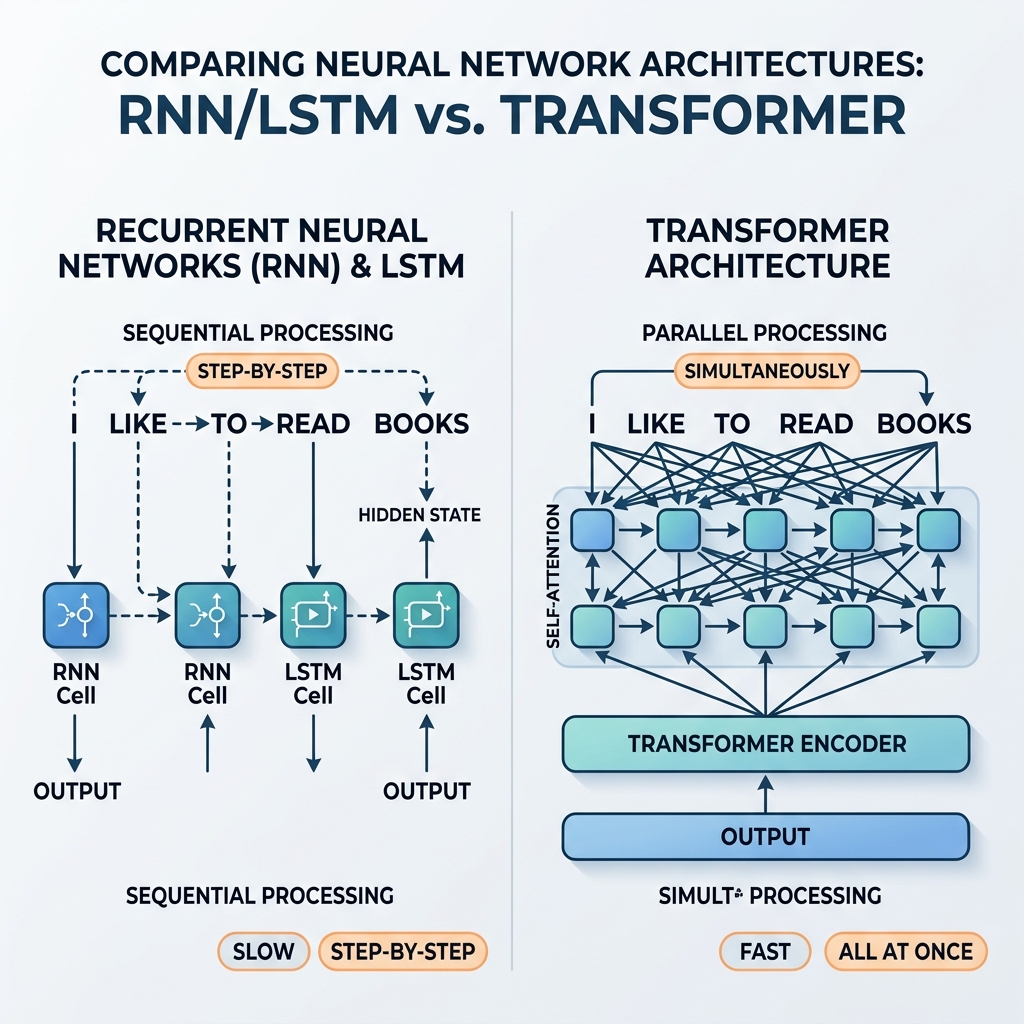
为什么 Transformer 取代了 RNN 和 LSTM
多年来,循环神经网络(RNN)和长短期记忆网络(LSTM)一直是序列数据处理领域无可争议的霸主。它们为最先进的翻译系统、语音助手和文本生成模型提供了强大的技术支持。然而,在 2017 年,一篇名为 “Attention Is All You Need”(Vaswani 等人)的里程碑式论文引入了 Transformer 架构。在短短几年内,RNN 和 LSTM 几乎完全退出了主流 AI 模型的舞台。
为什么会发生如此快速的转变?是什么让 Transformer 在结构上比循环网络更具优势?本文将探讨 RNN/LSTM 的数学和架构瓶颈,以及 Transformer 是如何克服它们的。
1. 核心瓶颈:串行限制 RNN 的决定性特征是其递归状态转换。为了处理输入序列,网络一步一步地处理每个 token,根据当前输入 $x_t$ 和前一个隐状态 $h_{t-1}$ 来更新其内部隐状态 $h_t$。
数学上的递推关系表示为:
$$h_t = \tanh(W_{hh} h_{t-1} + W_{xh} x_t + b)$$
并行化问题 由于 $h_t$ 直接依赖于 $h_{t-1}$,处理过程无法并行化。要计算一个句子中第 100 个单词的状态,网络必须顺序计算前 99 个状态。
随着 GPU 和 TPU 的发展以支持海量的并行矩阵计算,这种串行依赖性成为了致命的瓶颈。在大型网络数据集上训练深度 RNN 模型需要数周时间,而如果计算相互独立,硬件本可以运行得快得多。
Transformers
RNN
LSTM
自然语言处理
深度学习