🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

LLMs

LLM を使用した自律型 AI ワークフローの構築

LLM を使用した自律型 AI ワークフローの構築

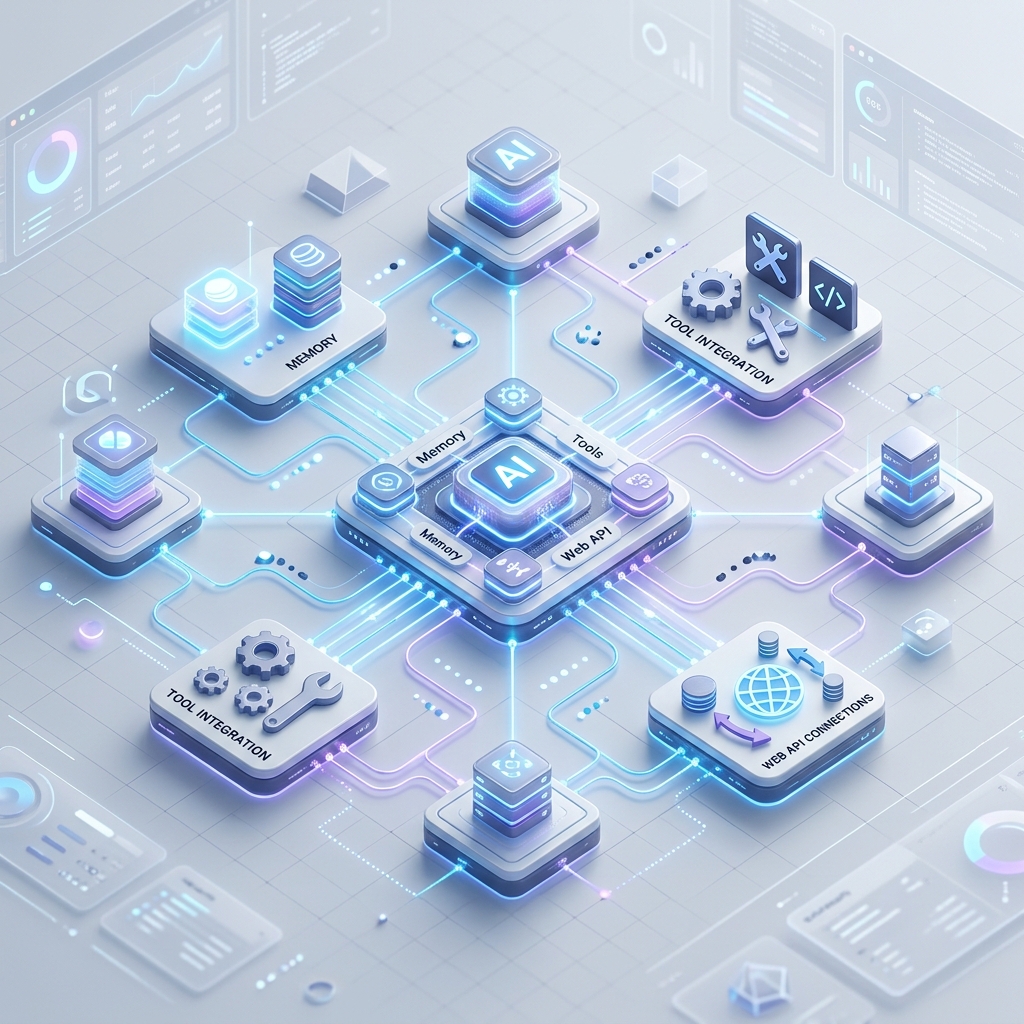
大規模言語モデル (LLM) は、私たちがテクノロジーと対話する方法を変革し、単純な会話型チャットボットから、複雑な複数ステップのアクションを実行できる推論エンジンへと急速に移行しました。単一のプロンプト応答インタラクションは強力ですが、企業環境における生成 AI の真の価値は 自律 AI ワークフローにあります。 人間のオペレーターに依存してすべてのステップを調整するのではなく、自律型ワークフローは、長期間にわたってタスクを計画、実行、評価、自己修正する中心的な意思決定者として LLM を使用します。 この詳細な説明では、最新の設計パターン、ステート マシン、堅牢なガードレールを使用して、信頼性の高い自律型 AI ワークフローを設計、構築、展開する方法を探ります。 1. エージェントの変化: チャットボットとワークフロー LLM アプリケーションの進化は、自律性の 4 つの異なるレベルに分類できます。 レベル パラダイム 人間の役割 コアメカニズム レベル 1 会話型チャット 高 (毎ターンプロンプトが表示されます) ステートレスな 1 ターンの完了 レベル 2 ツール呼び出し / 関数呼び出し 中 (コンテキストを提供) モデルは呼び出す API を選択します。結果を返します レベル 3 指示されたワークフロー 低 (目標とグラフを定義) LLM ルーティングを備えたハードコーディングされたステート マシン レベル 4 完全自律型エージェント 最小限 (目的/予算を定義) LLM 主導の計画、実行、およびリフレクション ループ レベル 4 エージェントは柔軟性に優れていますが、運用環境での予測が難しいことで知られています。したがって、ほとんどのエンタープライズ アーキテクチャは、ソフトウェア ステート マシンの決定論的な信頼性と LLM の動的な推論を組み合わせた レベル 3: 指示されたワークフロー に基づいて構築されています。
AI Agents LLMs Orchestration Software Architecture Machine Learning
高性能 RAG のための高度な取得技術: LLM を利用したシステムの最適化

高性能 RAG のための高度な取得技術: LLM を利用したシステムの最適化

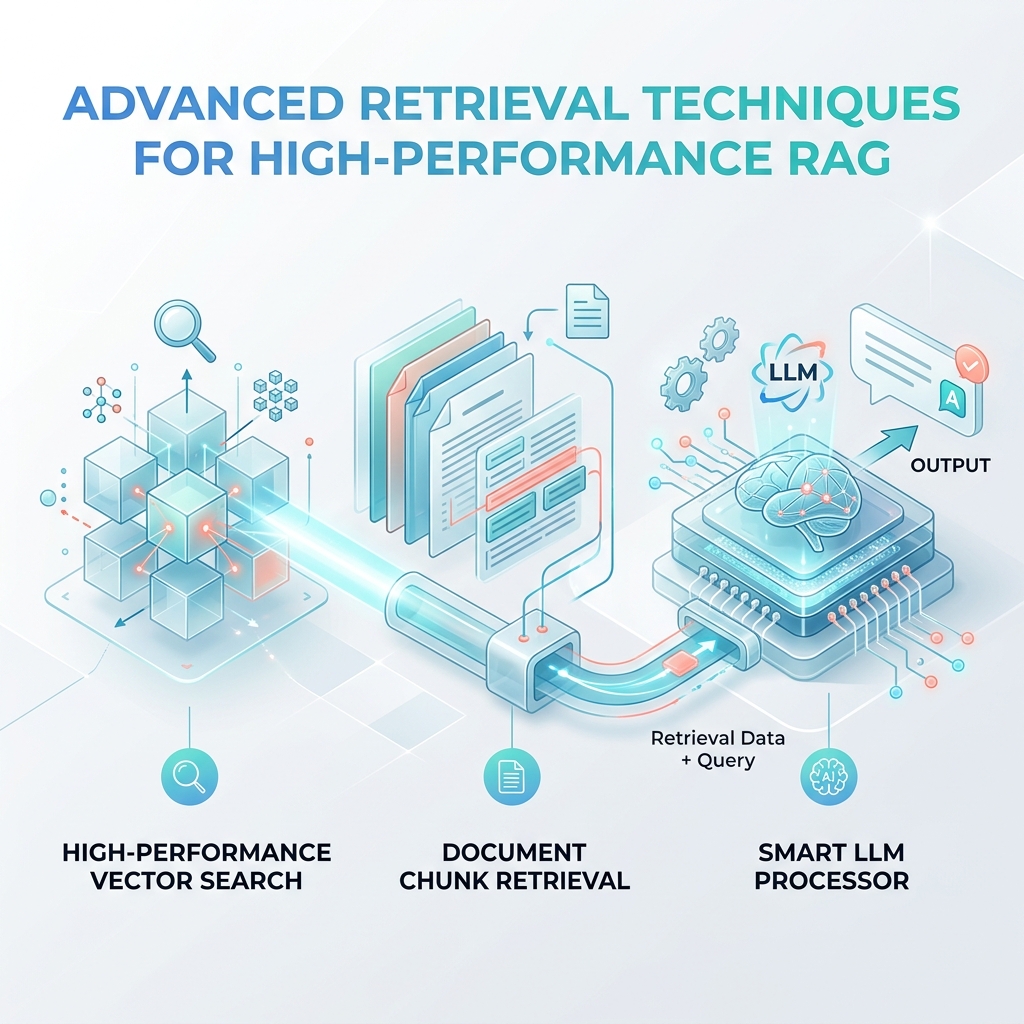
検索拡張生成 (RAG) はエンタープライズ AI アプリケーションのバックボーンとなっていますが、システムが拡大し、クエリがより複雑になるにつれて、基本的な検索方法では不十分になってきています。遅くて不正確な RAG システムと高パフォーマンスの RAG システムの違いは、多くの場合、取得戦略にあります。 この包括的なガイドでは、RAG のパフォーマンス、精度、およびスケーラビリティを大幅に向上させる高度な取得テクニックについて説明します。カスタマー サポート ボット、ナレッジ アシスタント、エンタープライズ検索システムのいずれを構築している場合でも、これらの戦略は RAG パイプラインを変革します。 1. 取得のボトルネックを理解する 最適化する前に、RAG システムが通常どこで失敗するかを特定しましょう。 低再現率: ベクトル検索で見つからなかったため、関連するドキュメントがありません。 不適切なランキング: ドキュメントは検索されていますが、無関係なものが最初にランク付けされています。 遅延の問題: 大規模なデータセットに対するベクトル類似性検索が遅い。 コンテキストの不一致: 取得されたチャンクには、LLM が正確な応答を生成するのに十分なコンテキストがありません。 クエリとドキュメントのセマンティック ギャップ: ユーザーのクエリはドキュメントの埋め込みと適切に一致していません。 これらの問題は規模が大きくなるとさらに悪化します。 5 つのドキュメントを取得する 90% の取得精度を持つシステムは、LLM の応答を完全に変える重要な情報を見逃す可能性があります。 2. ハイブリッド検索: ベクトル検索とキーワード検索の組み合わせ 実稼働 RAG にとって最も影響力のある改善は、以下を組み合わせた ハイブリッド検索 です。 ベクトル検索: 意味的類似性 (クエリの 意味) キーワード検索 (BM25): 用語の完全一致 (クエリの内容*) ハイブリッド検索が機能する理由 「Python 機械学習ライブラリ」を検索することを想像してください。純粋なベクトル検索では、ドキュメントで「Python」という用語が強調されていない場合、「scikit-learn」または「TensorFlow」に関するドキュメントが見つからない可能性があります。逆に、BM25 は完全一致を見つけますが、「Python の ML フレームワーク」などの同義クエリでは失敗します。
AI RAG LLMs Vector Search Information Retrieval Machine Learning Performance Optimization
生成 AI の説明: 機械はどのように創造することを学ぶのか

生成 AI の説明: 機械はどのように創造することを学ぶのか

生成 AI は、21 世紀で最も革新的な技術変化の 1 つです。分類、予測、検出を行う従来の AI システムとは異なり、Generative AI はテキスト、画像、オーディオ、ビデオ、コード、さらには 3 次元構造を作成します。これは、ChatGPT による記事の作成、Midjourney によるフォトリアリスティックなアートの描画、およびコメントからすべての機能を完了する GitHub Copilot の背後にあるテクノロジーです。 このガイドでは、Generative AI とは何か、Generative AI が内部でどのように機能するか、Generative AI を支える主要なモデル アーキテクチャ、および Generative AI がどこに向かっているのかについて説明します。 1. ジェネレーティブ AI とは何ですか? 生成 AI は、トレーニング データの統計的分布を学習し、その同じ分布に従う新しいコンテンツを生成する人工知能モデルのクラスを指します。 より簡単に言うと、人間の顔の何百万枚もの写真でモデルをトレーニングすると、モデルは顔の見た目のパターン (目の位置、鼻の形、肌の質感) を学習し、これまでに存在したことのないまったく新しい顔を生成できます。 識別モデルと生成モデルの主な違い: 識別AI 生成AI クラス間の境界を学習します 完全なデータ分布を学習します 入力 → ラベル / カテゴリ 入力プロンプト → 新しいコンテンツ (テキスト、画像、音声) 例: 画像分類器、スパムフィルター 例: GPT-4、安定拡散、ジェミニ 答え:「これは猫ですか?」 → はい/いいえ 答え: 「宇宙服を着た猫の絵を生成する」 2. 生成 AI の背後にあるコア アーキテクチャ 最新の生成 AI は単一のテクノロジーではなく、それぞれが異なるドメインに適した異なるアーキテクチャのファミリーです。
AI Generative AI LLMs Deep Learning Machine Learning GPT Diffusion Models