🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

LLMs

与法学硕士构建自主人工智能工作流程

与法学硕士构建自主人工智能工作流程

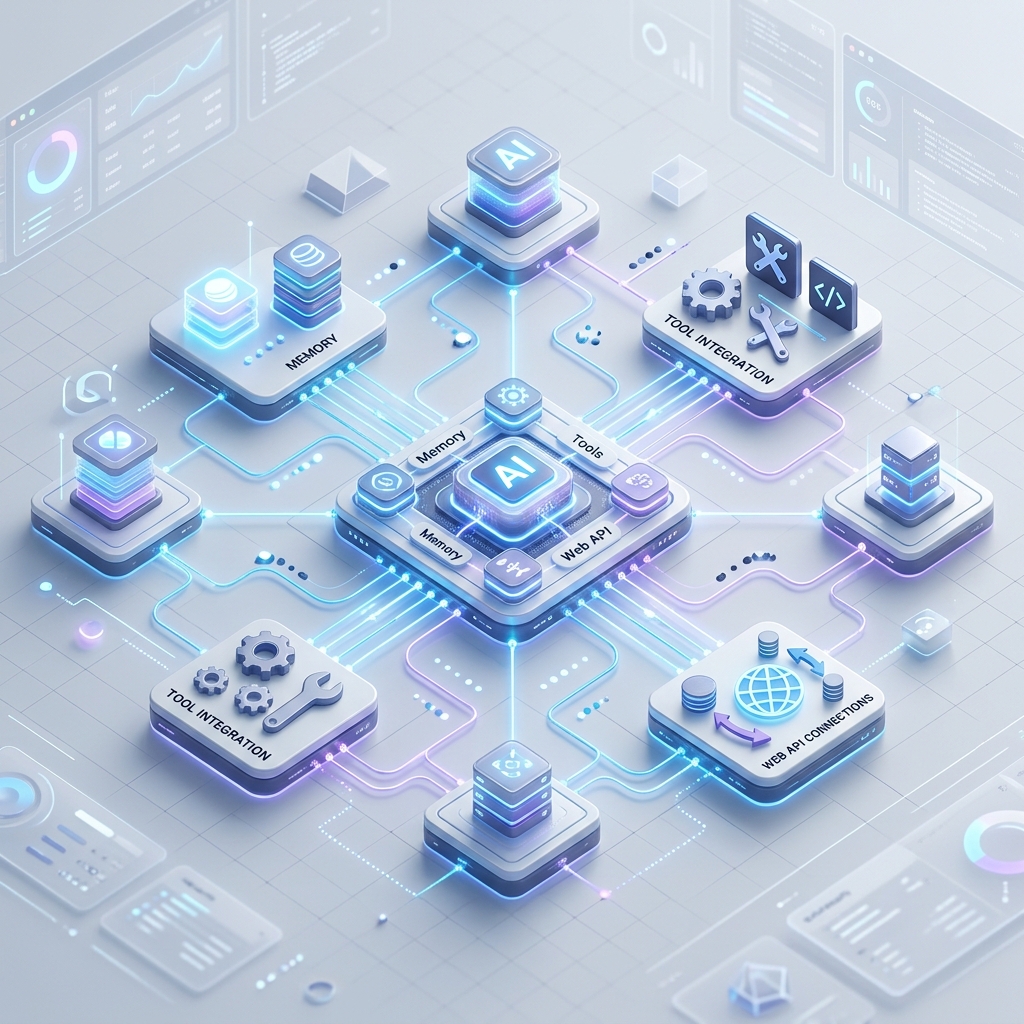
大型语言模型 (LLM) 改变了我们与技术交互的方式,从简单的会话聊天机器人迅速转变为能够驱动复杂、多步骤操作的推理引擎。虽然单个提示响应交互可能很强大,但生成式人工智能在企业环境中的真正价值在于自主人工智能工作流程。 自主工作流程不是依靠人类操作员来协调每一步,而是使用法学硕士作为中央决策者,长期规划、执行、评估和自我纠正任务。 本次深入探讨了如何使用现代设计模式、状态机和强大的护栏来架构、构建和部署可靠的自主人工智能工作流程。 1. 代理转变:聊天机器人与工作流程 LLM申请的演变可以分为四个不同的自主级别: 水平 范式 人类角色 核心机制 1 级 对话式聊天 高(每回合提示) 无状态单轮完成 2 级 工具调用/函数调用 中等(提供上下文) 模型选择API调用;返回结果 3级 定向工作流程 低(定义目标和图表) 带有 LLM 路由的硬编码状态机 4级 完全自主的代理 最小(定义目标/预算) LLM驱动的规划、执行和反思循环 虽然 4 级代理非常灵活,但众所周知,它们在生产环境中很难预测。因此,大多数企业架构都建立在第三级:定向工作流之上,将软件状态机的确定性可靠性与法学硕士的动态推理相结合。 2. 自主工作流程的核心支柱 要构建自主工作流程,您需要结合四个基本组件: A. 推理与规划 工作流程的核心是规划范例。幼稚的 LLM 调用会尝试立即输出最终答案,这通常会导致推理失败。自主工作流程使用专门的规划循环: ReAct (Reason + Act):模型迭代地思考、行动(调用工具)、观察结果,重复这个循环,直到达到目标。 思想链 (CoT):强制模型在得出结论之前*输出其逐步推理。 思想树 (ToT):生成和评估多个替代路径,跟踪不同的分支,并在路径失败时回溯。 B. 短期和长期记忆 自治系统必须在多个执行周期中维护状态: 短期内存:跟踪工作流当前正在执行的操作的线程上下文、状态变量和执行日志。 长期记忆:矢量数据库和语义检索系统,允许工作流程调用历史运行、用户首选项和企业文档。 C. 工具和 Web 集成 为了在物理或数字世界中采取行动,法学硕士必须与外部服务交互。该模型需要访问数据库驱动程序、文件系统、Web 浏览器和第三方 API。现代工作流程越来越多地采用模型上下文协议 (MCP),标准化法学硕士如何发现并安全连接到上下文数据源和执行沙箱。
AI Agents LLMs Orchestration Software Architecture Machine Learning
高性能 RAG 的高级检索技术:优化 LLM 支持的系统

高性能 RAG 的高级检索技术:优化 LLM 支持的系统

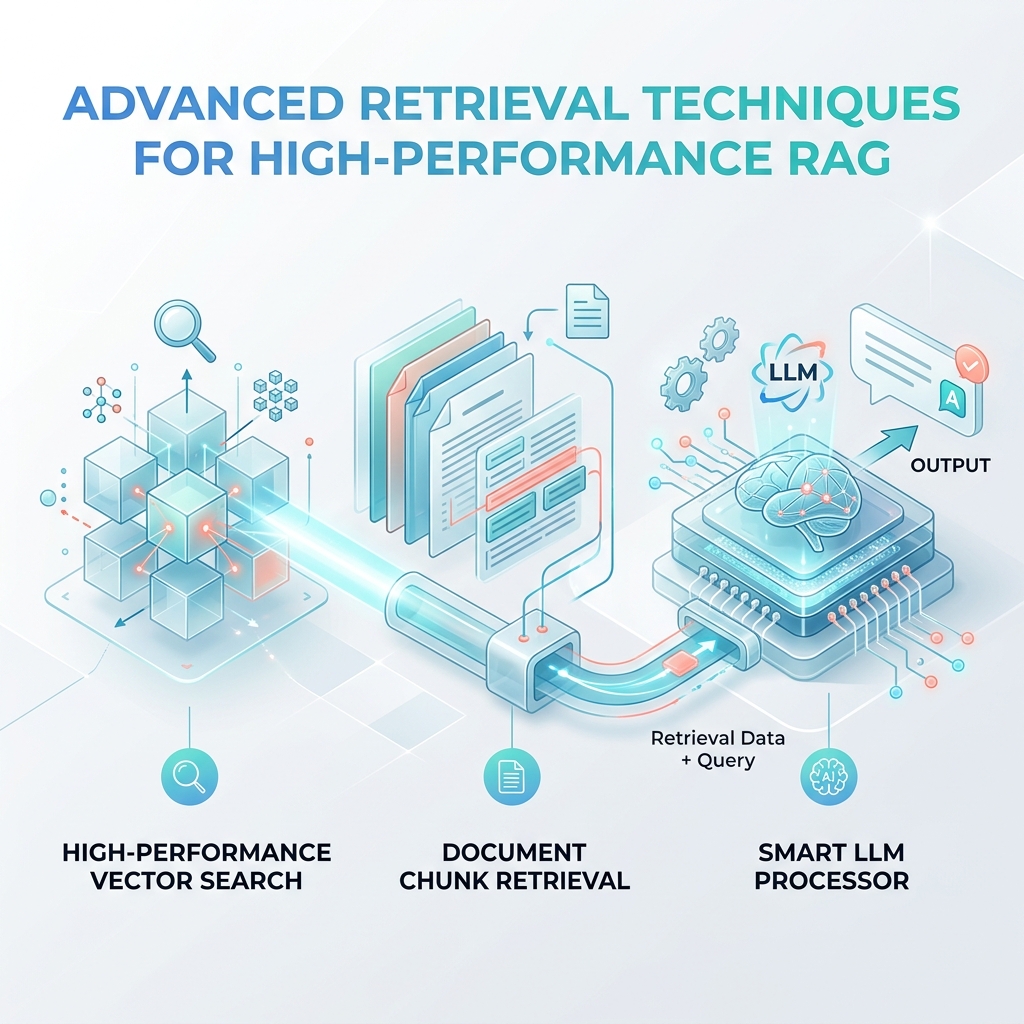
检索增强生成(RAG)已成为企业人工智能应用的支柱,但随着系统规模和查询变得更加复杂,基本的检索方法已经不够用了。缓慢且不准确的 RAG 系统与高性能系统之间的区别通常取决于检索策略。 本综合指南探讨了先进的检索技术,可显着提高 RAG 性能、准确性和可扩展性。无论您是构建客户支持机器人、知识助理还是企业搜索系统,这些策略都将改变您的 RAG 管道。 1. 了解检索瓶颈 在优化之前,我们先确定 RAG 系统通常会出现故障的位置: 低召回率:由于矢量搜索未找到相关文档而丢失。 排名不佳:找到文档,但将不相关的文档排在第一位。 延迟问题:大型数据集上的向量相似性搜索速度缓慢。 上下文不匹配:检索到的块缺乏足够的上下文,无法让 LLM 生成准确的响应。 查询-文档语义差距:用户的查询与文档嵌入不一致。 这些问题大规模地复杂化。检索准确度为 90% 的系统检索 5 个文档可能会错过关键信息,从而完全改变 LLM 的响应。 2. 混合搜索:向量检索和关键词检索相结合 对生产 RAG 最有影响力的改进是混合搜索,它结合了: 矢量搜索:语义相似性(查询意味着什么) 关键字搜索 (BM25):精确术语匹配(查询说什么) 为什么混合搜索有效 想象一下搜索“Python 机器学习库”。如果文档不强调术语“Python”,纯向量搜索可能会错过有关“scikit-learn”或“TensorFlow”的文档。相反,BM25 将找到精确匹配,但在同义查询(例如“Python 中的 ML 框架”)上失败。 实施策略 [User Query] │ ├──> [Vector Search] ──> [Top K results] │ │ │ ▼ └──> [BM25 Search] ──> [Top K results] ──> [Merge & Rerank] │ ▼ [Final Ranked Results] 步骤: 1.在嵌入空间中执行向量搜索→检索前K个结果 2. 使用倒排索引执行BM25(关键字)搜索→检索前K个结果 3. 合并两个结果集,删除重复项 4. 应用排名算法(例如,倒数排名融合)来生成最终的排名列表
AI RAG LLMs Vector Search Information Retrieval Machine Learning Performance Optimization
生成式人工智能解释:机器如何学习创造

生成式人工智能解释:机器如何学习创造

生成式人工智能是 21 世纪最具变革性的技术变革之一。与分类、预测或检测的传统人工智能系统不同,生成式人工智能创建——文本、图像、音频、视频、代码,甚至三维结构。它是 ChatGPT 撰写文章、Midjourney 绘画真实感艺术以及 GitHub Copilot 通过评论完成整个功能背后的技术。 本指南解释了什么是生成式人工智能、它的工作原理、支持它的主要模型架构以及它的发展方向。 1.什么是生成式人工智能? 生成式人工智能是指一类人工智能模型,它学习训练数据的统计分布,然后生成遵循相同分布的新内容。 简单地说:如果你用数百万张人脸照片训练一个模型,它就会学习脸部的模式——眼睛的位置、鼻子的形状、皮肤的纹理——然后可以生成一张以前从未存在过的全新脸部。 判别式和生成式模型之间的主要区别: 歧视性人工智能 生成式人工智能 了解班级之间的界限 了解完整的数据分布 输入→标签/类别 输入提示→新增内容(文字、图片、音频) 示例:图像分类器、垃圾邮件过滤器 示例:GPT-4,稳定扩散,Gemini 回答:“这是猫吗?” → 是/否 答案:“生成一幅穿着宇航服的猫的画” 2. 生成式人工智能背后的核心架构 现代生成式人工智能并不是一项单一的技术——它是一系列不同的架构,每种架构都适合不同的领域。 2.1 基于 Transformer 的语言模型 (LLM) Vaswani 等人在 2017 年具有里程碑意义的论文“Attention is All You Need”中介绍的 Transformer 架构是当今所有主要语言模型的基础,包括 GPT-4、Gemini、Claude 和 Llama。 它是如何工作的: 标记化:输入文本被分解为标记(子词单元)。 “生成式人工智能”可能会变成 ["Genera", "tive", " AI"]。 嵌入:每个标记都被转换为捕获其含义的高维数值向量。 自我注意力机制:每个令牌计算与序列中每个其他令牌的关系(注意力分数)。这使得模型能够理解“河岸”中的“银行”与“银行账户”中的“银行”不同。 前馈层:每个位置都经过非线性前馈网络来提取复杂的特征。 下一个标记预测:像 GPT 这样的自回归模型经过训练来预测下一个最可能的标记,重复此过程直到输出完成。 现代法学硕士的规模令人震惊:
AI Generative AI LLMs Deep Learning Machine Learning GPT Diffusion Models