BERTの理解:Transformersによる双方向エンコーダ表現
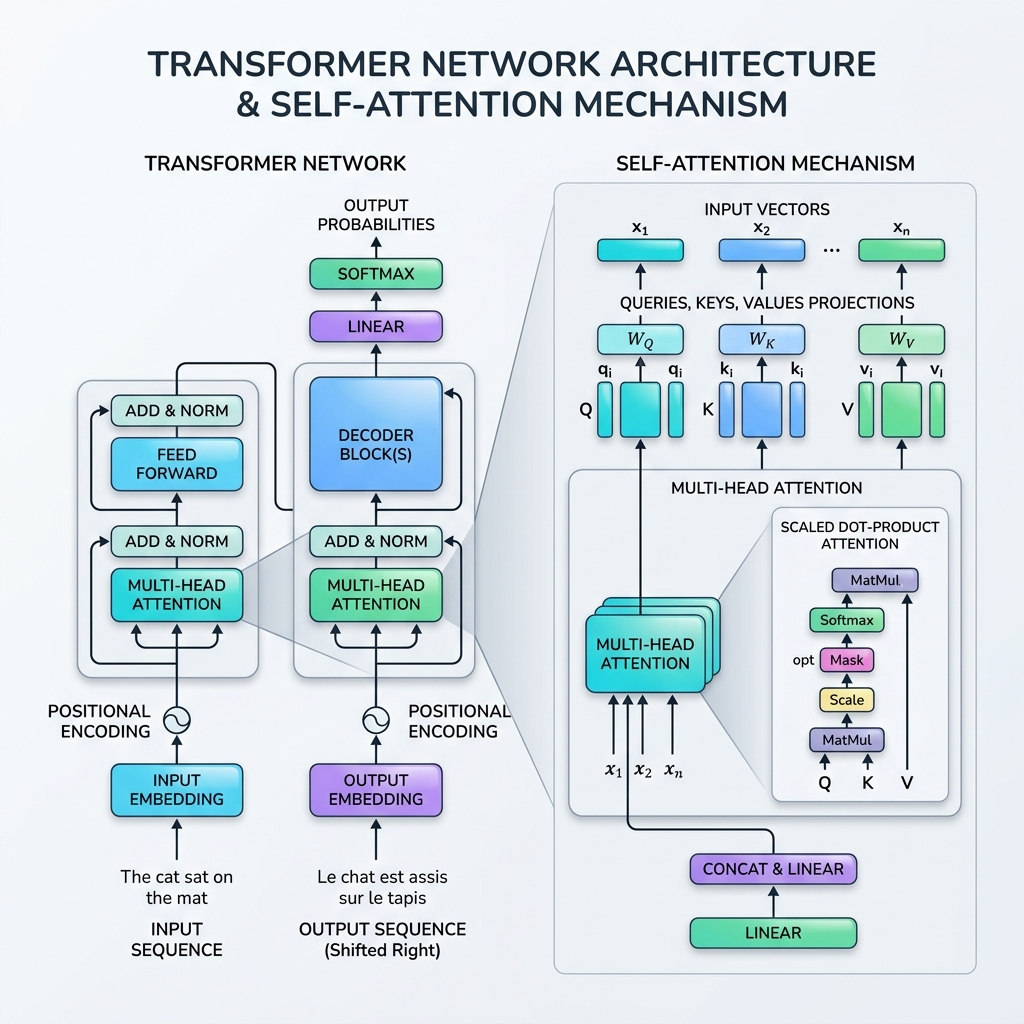
2018年、Googleの研究者らは、「BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding」(Devlinら)という画期的な論文を発表しました。この研究は、自然言語処理(NLP)の分野を根本から変えました。BERT以前のモデルは、テキストを左から右、または右から左へと順次処理していました。BERTは、両方向からの文脈を同時に考慮する言語表現を学習する手法を導入しました。
現在でも、BERTとその派生モデル(RoBERTa、DistilBERT、ALBERTなど)は、検索エンジン、感情分析、質問応答システム、情報抽出の基盤であり続けています。この記事では、BERTのアーキテクチャ、仕組み、および学習方法について詳しく解説します。
1. BERTとは何か? BERTは Bidirectional Encoder Representations from Transformers(Transformersによる双方向のエンコーダ表現)の略です。この名前を分解してみましょう。
双方向(Bidirectional): テキストを左から右(GPTなど)または右から左に読み込む従来の言語モデルとは異なり、BERTは単語のシーケンス全体を一度に読み込みます。これにより、単語の左右両方の周囲すべての環境に基づいて、その単語の文脈を学習できます。 エンコーダ表現(Encoder Representations): BERTは、オリジナルのTransformerアーキテクチャの**エンコーダ(Encoder)**部分を使用します。入力シーケンスを受け取り、各トークンに対して密なベクトル表現(埋め込み/embedding)を出力します。 Transformers: 基盤となるエンジンはTransformerのアテンション(注意)ネットワークであり、長距離の依存関係のモデリングと並列計算を可能にします。 双方向性の力 単方向モデルでは、トークンはそれ以前のトークンにしかアテンションを向けることができません。例えば、次の文を考えてみましょう。 「彼は銀行(bank)にお金を預けることに決めた。」
単方向モデルが「bank」を処理する場合、それより前にある単語しか見ません。しかし、文脈を完全に理解するには、左右両方の文脈を見ることが極めて重要です。双方向LSTMは、左から右と右から左のモデルを個別に学習して出力を結合することでこれを試みましたが、BERTはすべてのレイヤーで最初から単一の深い双方向モデルを共同で学習します。
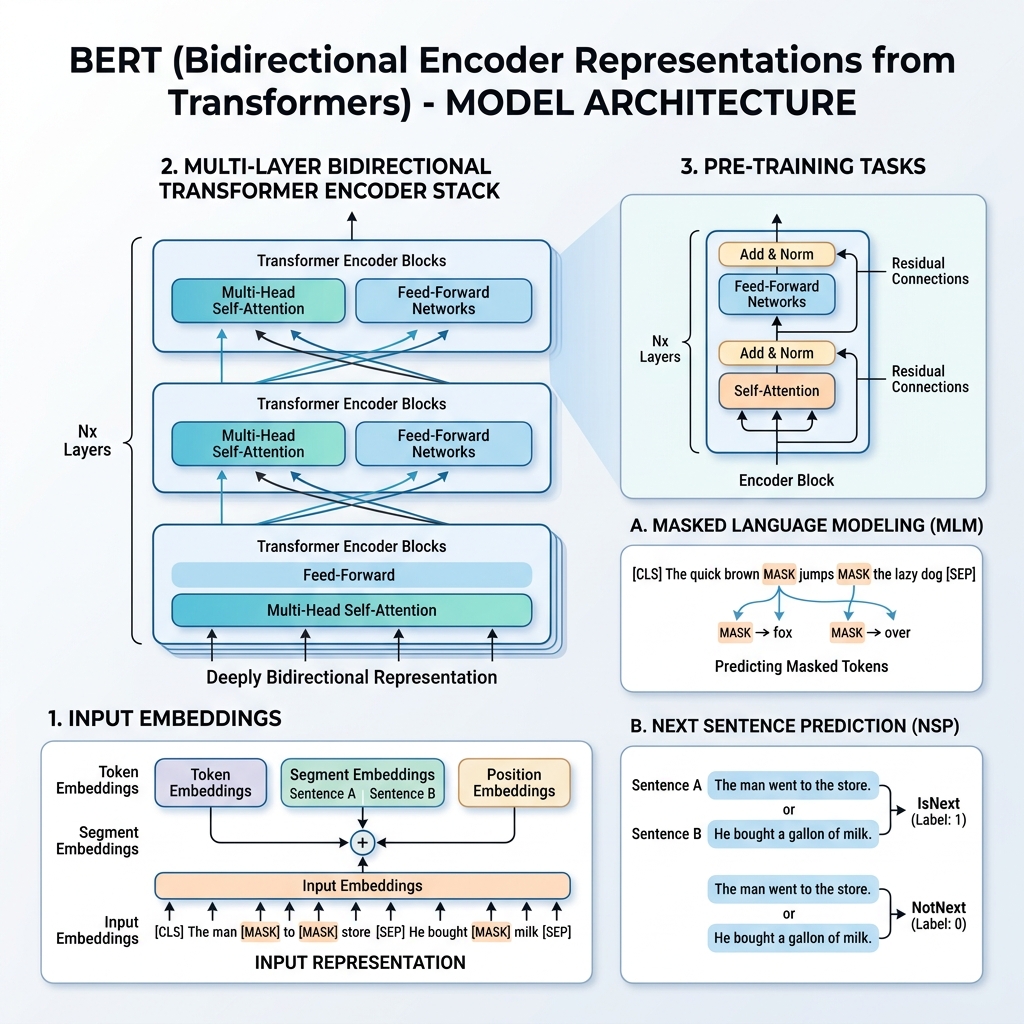
2. BERTの入力表現 様々な下流タスクでの学習を可能にするため、BERTの入力表現は、単一のトークンシーケンス内で、単一の文と文のペア(例:<質問, 回答>)の両方を表現できます。
任意のトークンについて、その入力表現は次の3つの埋め込みを合算して構築されます。
トークン埋め込み(Token Embeddings): テキストは WordPiece ボキャブラリ(約30,000トークン)を使用してトークン化されます。特殊トークンが追加されます。 [CLS]:すべてのシーケンスの先頭に挿入されます。その最終隠れ状態は分類タスクに使用されます。 [SEP]:文を区切るため、またはシーケンスの末尾に使用されます。 セグメント埋め込み(Segment Embeddings): トークンが文Aと文Bのどちらに属しているかを示す、学習された埋め込み。 位置埋め込み(Position Embeddings): シーケンス内のトークンの位置をモデルに認識させるために追加される、学習された位置ベクトル(最大512トークン)。 $$\text{入力表現} = \text{トークン埋め込み} + \text{セグメント埋め込み} + \text{位置埋め込み}$$
3. 事前学習プロセス BERTは、**マスク化言語モデル(MLM)と隣接文予測(NSP)**という2つの自己教師ありタスクを同時に使用して、大規模なコーパス(WikipediaおよびBooksCorpus)で事前学習されます。
タスク1:マスク化言語モデル(MLM) 標準的な言語モデリングでは、次の単語を予測する際に、ターゲット単語が自分自身を「見る」のを防ぐため、モデルを左から右のアーキテクチャに制限します。深い双方向表現を学習するために、BERTは入力トークンの一定割合をランダムにマスクし、それらを予測します。
具体的には:
BERT
Transformers
NLP
ディープラーニング
AIアーキテクチャ