🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

معالجة اللغة الطبيعية

تعرف الكيانات المسمى (NER): من معالجة اللغة الطبيعية الكلاسيكية إلى الاستخراج المدعوم بالذكاء الاصطناعي

تعرف الكيانات المسمى (NER): من معالجة اللغة الطبيعية الكلاسيكية إلى الاستخراج المدعوم بالذكاء الاصطناعي

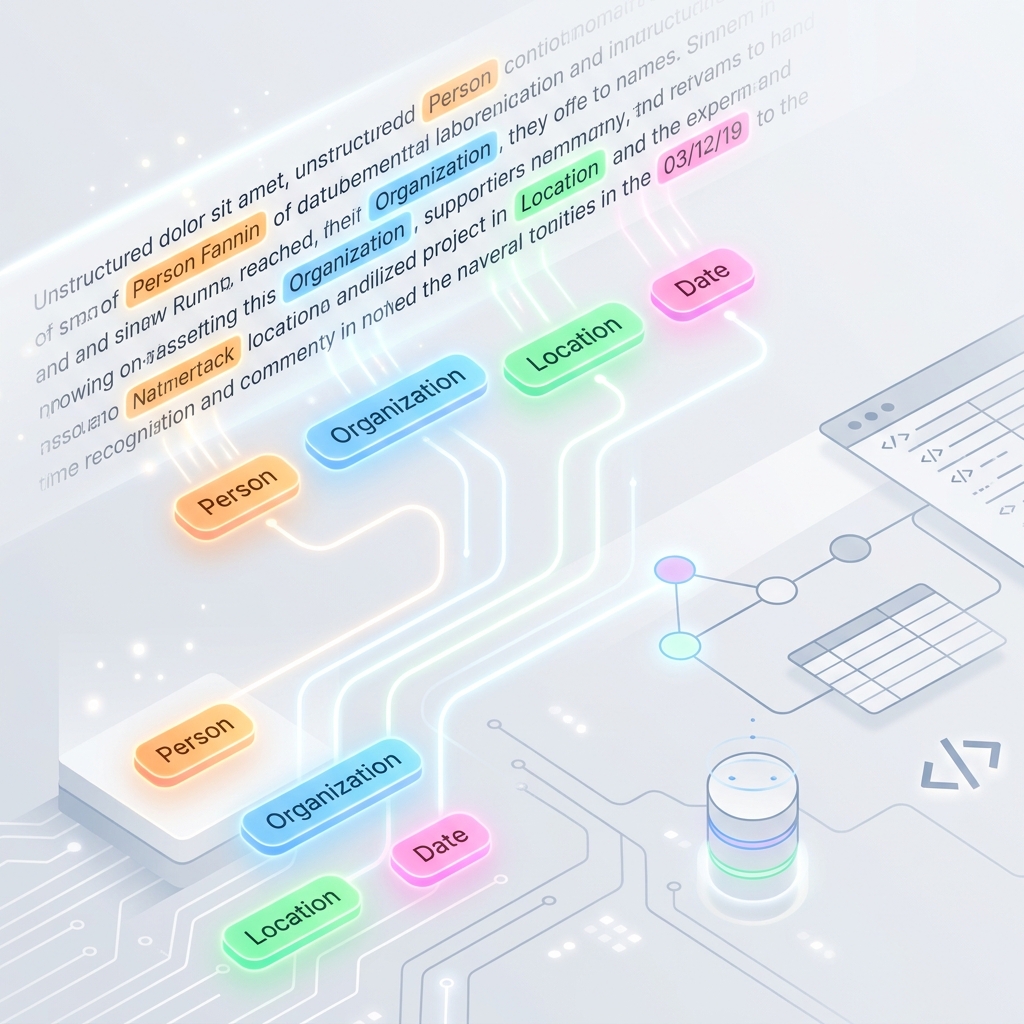
يعد تعرف الكيانات المسمى (Named Entity Recognition - NER) حجر الزاوية في معالجة اللغة الطبيعية (NLP). وهو عملية تحديد وتصنيف العناصر الرئيسية في النصوص غير المهيكلة تلقائيًا إلى فئات محددة مسبقًا - مثل أسماء الأشخاص، والمنظمات، والمواقع، والتواريخ، والقيم النقدية، وأسماء المنتجات. بدون NER، ستواجه محركات البحث، ومحركات التوصية، وأنظمة تحليل المستندات المؤتمتة صعوبة في فهم “من، وماذا، وأين، ومتى” داخل النص.
الذكاء الاصطناعي تعرف الكيانات المسمى معالجة اللغة الطبيعية تعلم الآلة النماذج اللغوية الكبيرة
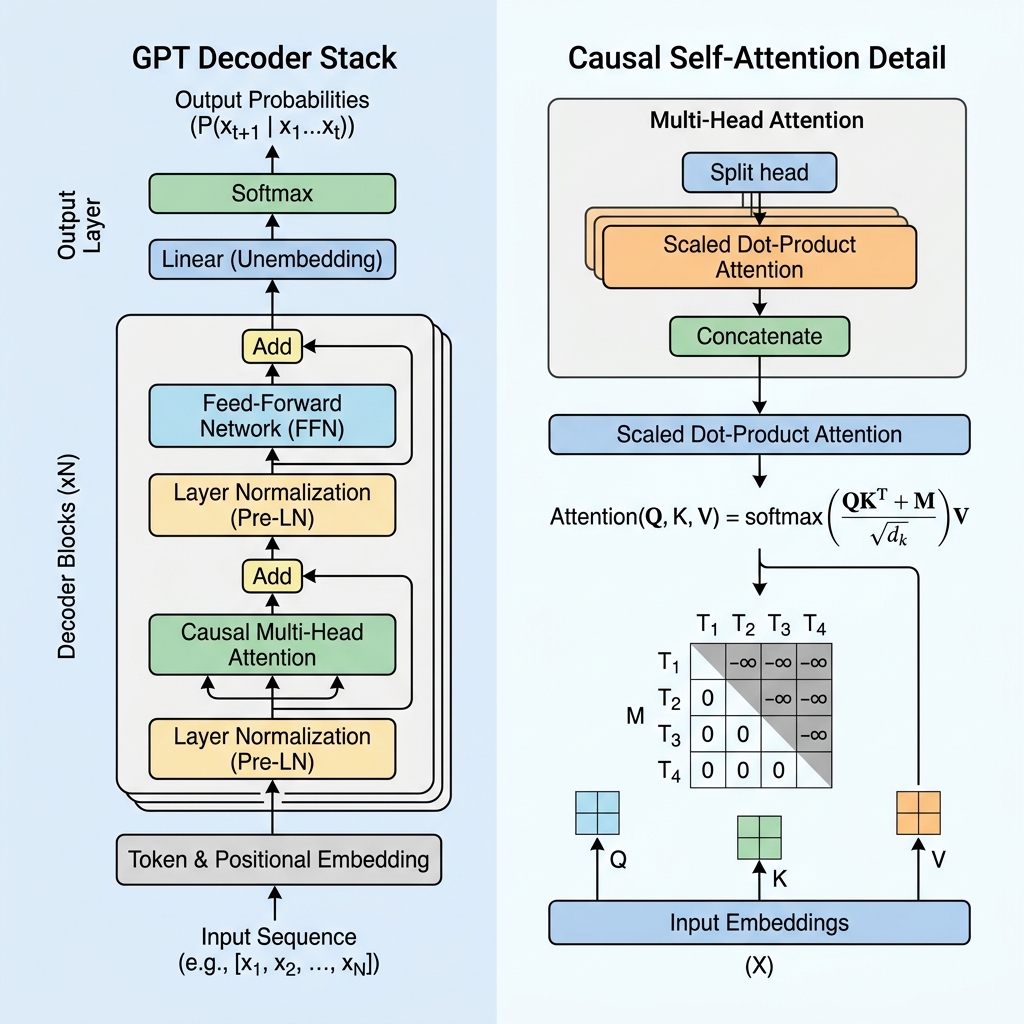
كيف يعمل نموذج GPT Transformer: شرح آلية الانتباه الذاتي السببي

كيف يعمل نموذج GPT Transformer: شرح آلية الانتباه الذاتي السببي

في السنوات الأخيرة، أحدثت النماذج التوليدية مسبقة التدريب (GPT) ثورة حقيقية في مجالات الذكاء الاصطناعي. من مساعدي البرمجة إلى برمجيات المحادثة التفاعلية، تشغل النماذج القائمة على GPT أكثر التطبيقات التوليدية تقدمًا اليوم. ولكن كيف تعمل هذه التكنولوجيا فعليًا؟ بينما تستخدم نماذج مثل BERT جزء الترميز (Encoder) من نموذج Transformer لفهم النصوص بشكل ثنائي الاتجاه، فإن GPT يعتمد على بنية فك الترميز فقط (Decoder-only) المصممة للتنبؤ بالتوكن التالي بشكل تكراري تلقائي (autoregressive). في هذه التدوينة، سنزيل الغموض عن كيفية عمل GPT Transformer، ونغوص عميقًا في آلية الانتباه الذاتي السببي (causal self-attention)، ونقوم بتنفيذها برمجياً.
GPT Transformers الذكاء الاصطناعي التوليدي الانتباه السببي معالجة اللغة الطبيعية
فهم شبكات المحولات (Transformer) وآلية الانتباه الذاتي (Self-Attention)

فهم شبكات المحولات (Transformer) وآلية الانتباه الذاتي (Self-Attention)

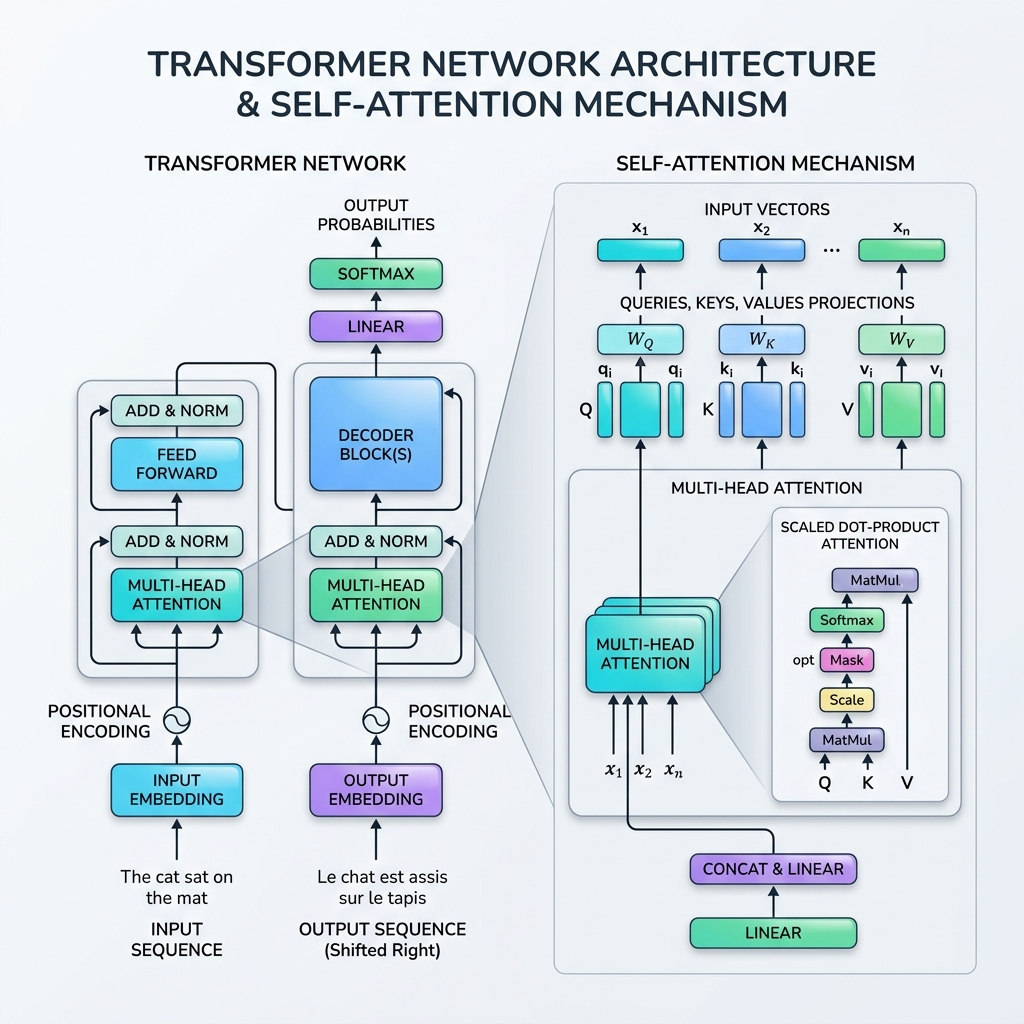
في عام 2017، تغير مشهد الذكاء الاصطناعي إلى الأبد مع نشر البحث العلمي المؤثر “Attention Is All You Need” بواسطة فريق الباحثين تحت إشراف فاسواني (Vaswani et al). قدم البحث بنية المحول (Transformer)، وهي بنية ثورية للشبكات العصبية تخلت تماماً عن التكرار (RNNs, LSTMs)، واختارت بدلاً من ذلك معالجة البيانات التسلسلية بشكل متوازٍ باستخدام آلية الانتباه الذاتي (Self-Attention Mechanism).
المحولات الانتباه الذاتي التعلم العميق معالجة اللغة الطبيعية بنية الذكاء الاصطناعي
شرح بنية Sequence-to-Sequence وآلية الانتباه (Attention Mechanism) بالتفصيل

شرح بنية Sequence-to-Sequence وآلية الانتباه (Attention Mechanism) بالتفصيل

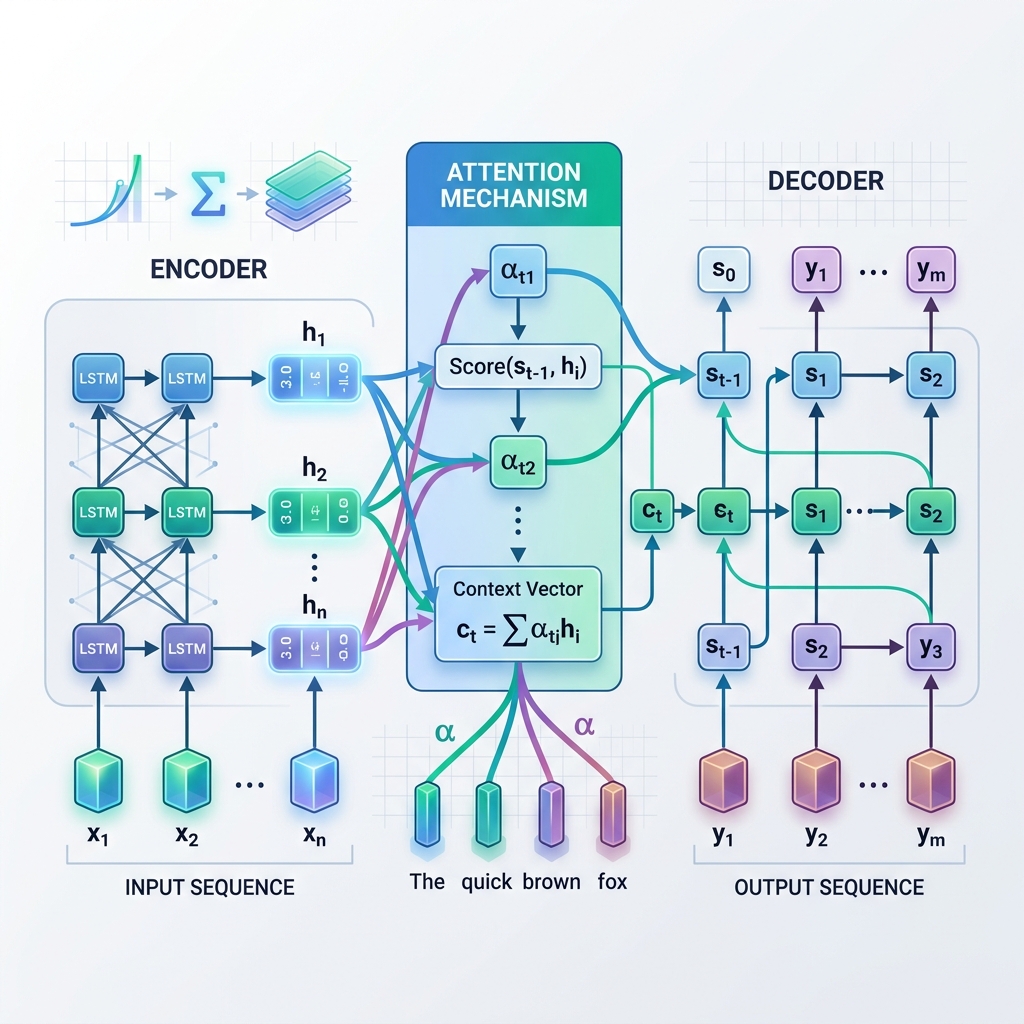
في مجال معالجة اللغة الطبيعية (NLP) والذكاء الاصطناعي، شهدت القدرة على ترجمة اللغات، وتلخيص المقالات، وتوليد الردود الحوارية ثورة حقيقية. وفي قلب هذا التحول تكمن بنية Sequence-to-Sequence (Seq2Seq) وآلية الانتباه (Attention Mechanism) الرائدة. قبل ظهور نماذج Transformer الحديثة، نجح هذان الابتكاران في حل أحد أكبر تحديات التعلم العميق: كيفية ربط تسلسلات المدخلات بتسلسلات المخرجات عندما تختلف أطوالها.
بنية Seq2Seq آلية الانتباه التعلم العميق معالجة اللغة الطبيعية الذكاء الاصطناعي
تحليل المشاعر باللغة العربية: دليل عملي لمعالجة النصوص وبناء النماذج

تحليل المشاعر باللغة العربية: دليل عملي لمعالجة النصوص وبناء النماذج

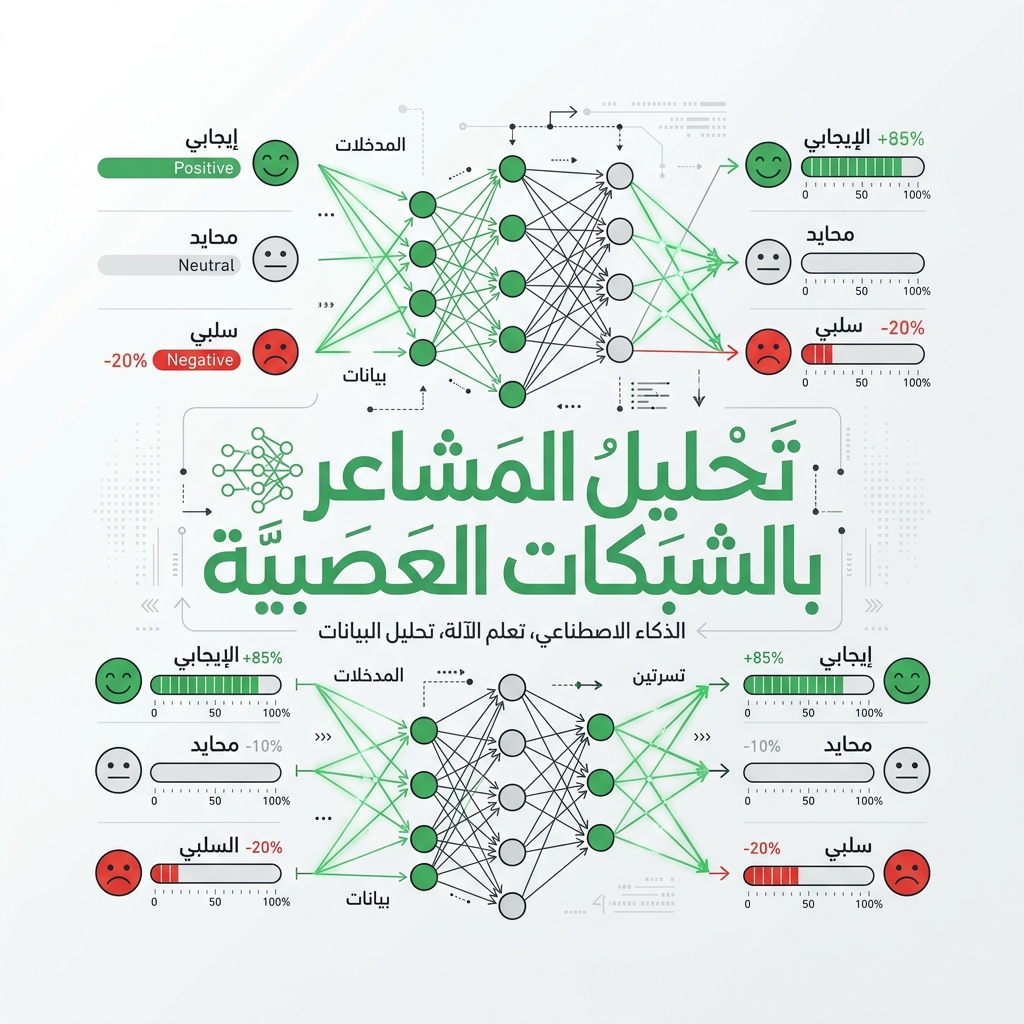
في عصر الاتصالات الرقمية المعولمة، أصبح تحليل المشاعر - وهو مهمة تحديد النبرة العاطفية وراء النص - أمرًا بالغ الأهمية للشركات والحكومات والباحثين. في حين أن تحليل المشاعر ناضج للغاية بالنسبة للغات مثل الإنجليزية، فإن تطبيقه على اللغة العربية يمثل مجموعة فريدة من التحديات اللغوية والتقنية. تعد اللغة العربية واحدة من أكثر اللغات انتشارًا في العالم حيث يتحدث بها أكثر من 400 مليون شخص. ومع ذلك، فإن بنيتها الصرفية الغنية، وازدواجية اللغة (التعايش بين الفصحى والعامية)، ونظام كتابتها المعقد يتطلب استراتيجيات معالجة مسبقة وبناء نماذج متخصصة.
معالجة اللغة الطبيعية NLP تحليل المشاعر الذكاء الاصطناعي العربي المحولات بايثون تعلم الآلة