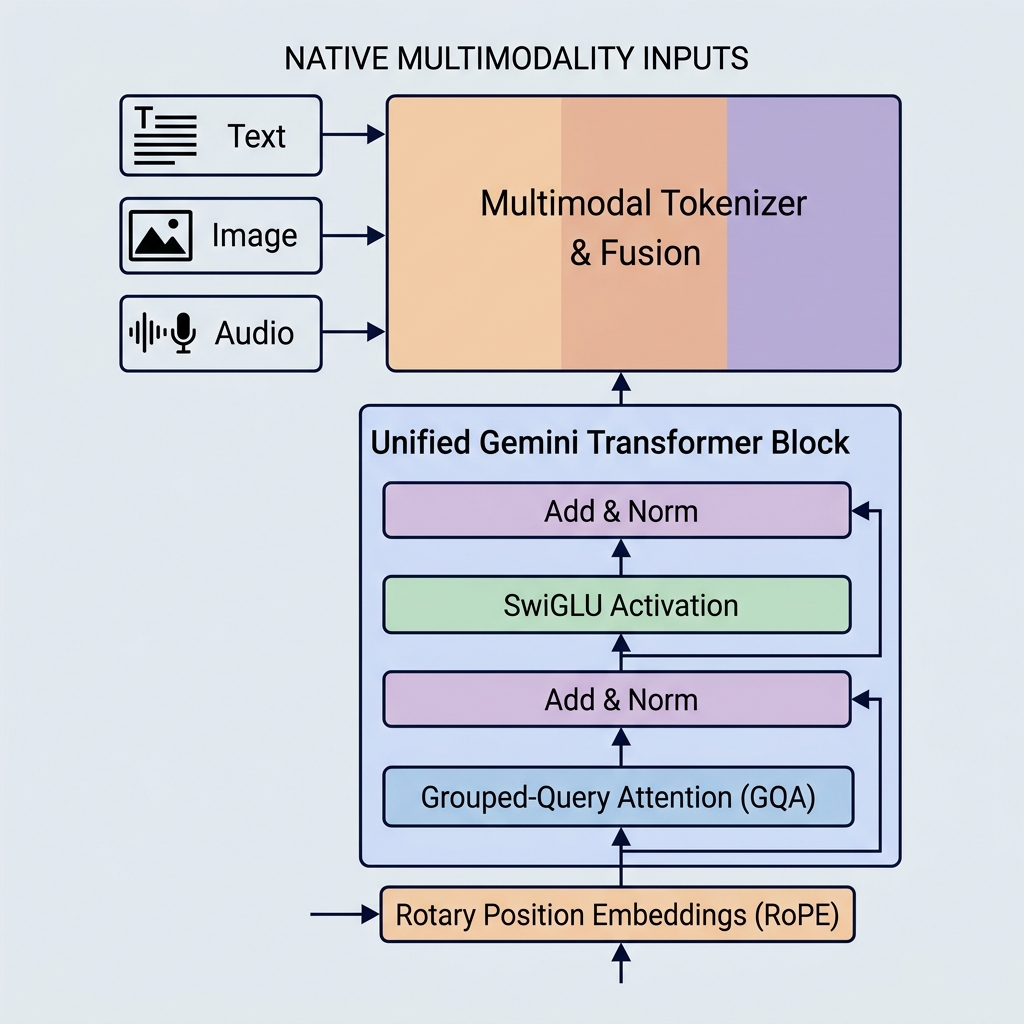
Gemini Transformer 模型如何工作:GQA、SwiGLU 和原生多模态
谷歌的 Gemini 模型通过引入原生多模态、超长上下文窗口以及关键的架构优化,树立了 AI 能力的新标杆。与 GPT-3 或 BERT 等旧模型不同,Gemini 从设计之初就是为了处理多种数据类型,并使用了极高效率的注意力机制。
在本文中,我们将深入解析 Gemini Transformer 核心的架构选择,探索它们与传统架构的不同之处,并使用 PyTorch 实现分组查询注意力(GQA)和 SwiGLU 前馈网络。
1. 原生多模态(统一嵌入空间) 传统的 AI 系统是通过拼接不同的模型来实现多模态行为的。例如,它们会使用映射层或适配器,将图像编码器(如 CLIP)或音频处理器(如 Whisper)与预训练的文本模型配对。
Gemini 则完全不同。它是原生多模态的,这意味着它在开发初期就同时在不同的模态(文本、代码、图像、音频和视频)上进行预训练。
统一的分词器(Tokenizer): 不同类型的输入不需要经过独立的预处理流水线,而是被统一转换为共享的潜在嵌入空间中的 token。 跨模态推理: 由于表示空间是共享的,单个解码器(decoder)块可以在同一个序列中同时处理视觉 token、音频 token 和文本 token。这使得 Gemini 能够直接执行复杂任务,如解释视频帧或直接将音频翻译为文本。 2. 分组查询注意力(Grouped-Query Attention, GQA) 随着上下文窗口的扩大(可达数百万个 token),键值(KV)缓存的内存占用成为了模型推理服务的主要瓶颈。
为了解决这个问题:
多头注意力(MHA): 每个查询头(Query head, $Q$)都有一个匹配的键(Key, $K$)和值(Value, $V$)头。如果有 32 个头,我们就必须存储 32 组 KV 向量。 多查询注意力(MQA): 所有查询头共享一个键和值头。虽然这节省了内存,但会降低模型的表达能力和输出质量。 分组查询注意力(GQA): 查询头被分组(例如,分为 8 组,每组包含 4 个查询头)。每组共享一个键和值头。 $$\text{Scores} = QK^T \text{ computation in GQA groups Q heads to share a single KV pair}$$
Gemini
Transformers
GQA
SwiGLU
多模态
深度学习