🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

Resilience

回退模式:在微服务中设计优雅的降级

回退模式:在微服务中设计优雅的降级

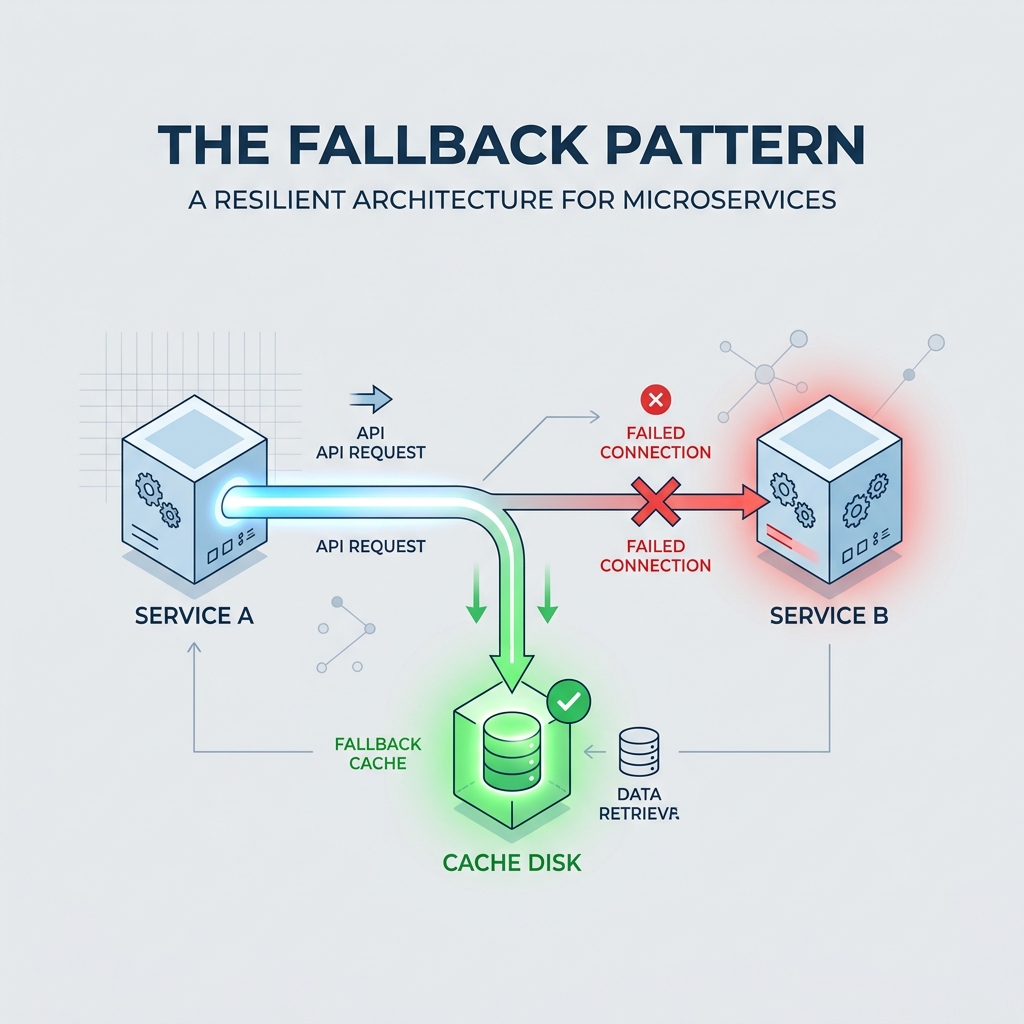
在微服务架构中,服务形成分布式网络调用的网络。虽然这允许团队独立构建和扩展服务,但这也意味着系统的整体可靠性取决于其最薄弱的环节。如果关键服务出现故障或变得无响应,则可能会触发级联故障,从而中断整个应用程序。 当单个依赖项失败时,向用户返回通用的“500 内部服务器错误”或空白页面是一种糟糕的用户体验。相反,弹性系统是为了在出现问题时优雅地降级而构建的。 这就是 后备模式 的用武之地。通过在主服务调用失败时定义安全的替代执行路径,您可以保持应用程序正常运行 - 即使在降级状态下也是如此。 在本指南中,我们将探讨回退模式、实现它的常见策略、它如何与其他弹性模式交互,以及如何用 Java (Resilience4j) 和 Go 编写回退逻辑。 现实世界的类比:咖啡店后备计划 想象一下您走进当地一家咖啡店买一杯拿铁咖啡。咖啡师输入您的订单,但当您刷卡时,支付终端会显示连接错误 - 商店的互联网提供商遇到中断。 咖啡店是否立即关灯、锁门并送所有顾客回家? 当然不是。他们实施了后备策略: 如果他们手头有现金,他们会询问您是否可以用现金支付。 如果您是常客,咖啡师可能会将您的姓名和订单记在账本上,并要求您在下次光顾时付款。 他们可能会使用离线读卡器,在本地存储卡令牌,并在互联网恢复后处理付款。 在软件设计中: 咖啡订单是客户请求。 卡终端是主要下游服务(例如支付网关 API)。 互联网中断是网络超时或服务崩溃。 Ledger / Offline Reader 是后备执行路径。 常见的后备策略 根据业务逻辑和失败服务的严重性,您可以从多种后备策略中进行选择: 1. 静态默认值 最简单的策略是返回一个安全的、预先配置的静态值。这对于可以接受显示空白或默认数据的非关键功能非常有效。 示例:如果个人资料个性化服务失败,则返回默认头像图像和通用问候语。 示例:如果推荐服务失败,则返回空列表或通用畅销书的硬编码列表,而不是抛出错误。 2. 缓存响应(Stale-While-Revalidate) 如果实时数据不可用,您可以回退到本地缓存或快速分布式内存存储(如 Redis)中的只读、陈旧数据。 示例:如果产品库存服务出现故障,则显示 5 分钟前缓存的库存数量,并显示一条微妙的 UI 消息,指示数据可能不是完全最新的。 示例:如果用户设置服务失败,请加载缓存的用户配置文件,而不是阻止其登录流程。 3.替代服务(多提供商) 当执行必须成功的关键操作时,您可以配置辅助服务提供商作为备份。
Microservices Fallback Pattern Software Architecture System Design Fault Tolerance Resilience
重试模式:构建弹性微服务

重试模式:构建弹性微服务

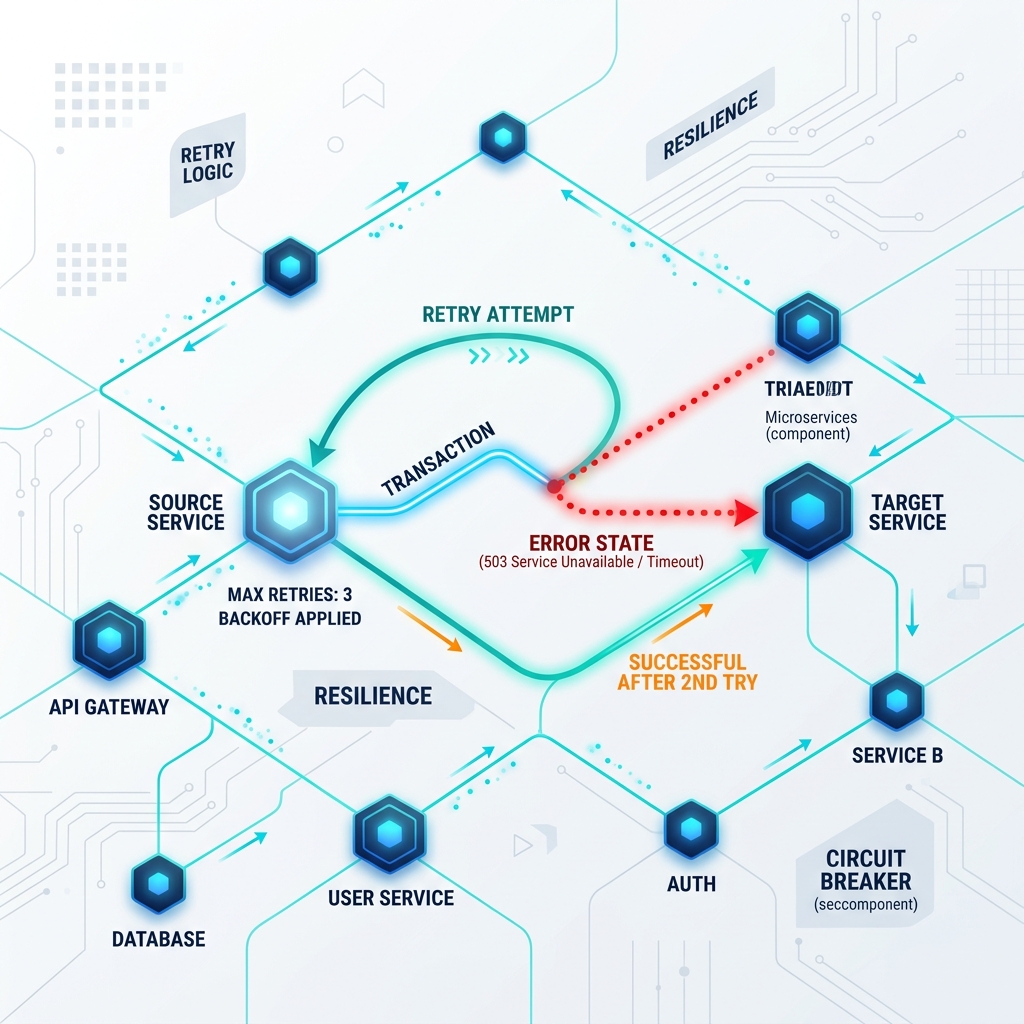
在微服务架构中,服务通过网络而不是内存中的调用进行通信。虽然这种解耦可以实现大规模水平扩展和独立部署,但它也引入了一个主要漏洞:网络不可靠。 下游服务随时可能会遇到短暂的网络故障、临时的 CPU 峰值、快速的数据库锁定争用或滚动更新重启。这些临时故障称为“暂时性故障”。 如果您的服务在下游调用失败时立即抛出错误并导致请求失败,则会造成脆弱的用户体验。相反,许多暂时性错误可以通过等待片刻并重试来自动解决。这就是 重试模式 的用武之地。 在本指南中,我们将探讨重试模式、它的幕后工作原理、简单实现的危险,以及如何在 Java (Resilience4j) 和 Go 中正确实现它。 现实世界的类比:重拨占线的线路 想象一下您正在尝试给朋友打电话。您拨打他们的号码,但收到忙音,因为他们当前正在通话。 您是否会立即放弃,删除他们的联系方式,并认为您永远无法再与他们交谈?当然不是。您挂断电话,稍等一下,然后再次拨打他们的号码。如果他们仍然很忙,您可以等待五分钟再重试。 最终,他们的通话结束,您的重试成功。 在微服务中: Call 是对下游服务的 API 请求。 忙信号是暂时性网络错误或 503 Service Unavailable 响应。 重拨 是重试尝试。 等待时间 是退避持续时间。 危险:天真的重试和“重试风暴” 乍一看,实现重试机制似乎微不足道:只需将 HTTP 调用包装在 for 循环中,然后继续尝试,直到成功为止。然而,天真的重试实现很容易将一个小问题演变成灾难性的系统范围中断。 想象一下下游服务在流量突然激增的情况下陷入困境。其数据库以 99% 的 CPU 利用率运行,并且请求开始超时。 如果 100 个客户端服务都检测到超时并立即重试 3 次而无需等待,它们将突然使已经陷入困境的下游服务的流量增加三倍。这种流量的突然放大被称为“重试风暴”(或“Thundering Herd”问题)。 您的重试不但不会帮助下游服务恢复,反而会不断将其推低,使其无法跟上。 解决方案:退避和抖动 为了防止重试风暴,弹性系统必须利用两个基本策略:退避和抖动。
Microservices Retry Pattern Software Architecture System Design Fault Tolerance Resilience
舱壁模式:设计容错微服务

舱壁模式:设计容错微服务

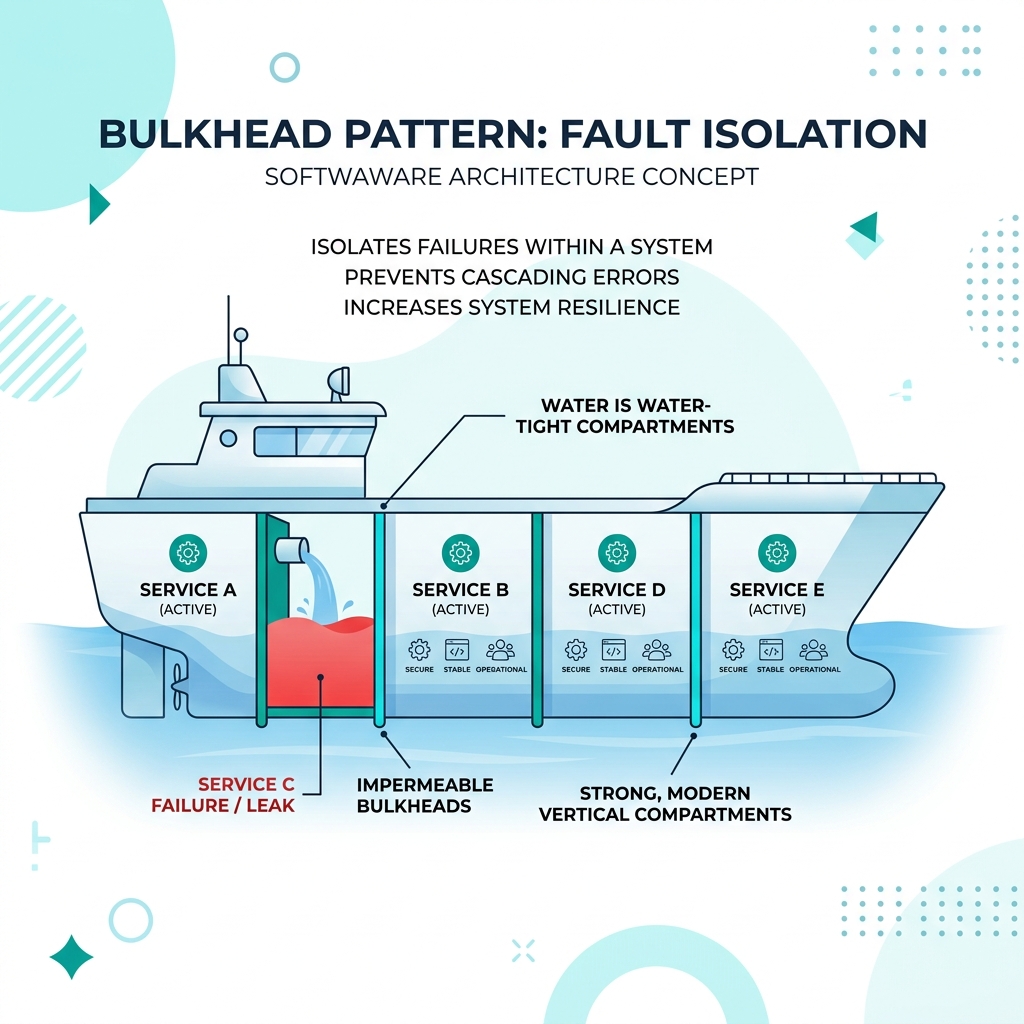
在微服务架构中,单个应用程序被分解为数十或数百个独立的协作服务。虽然这种设计提高了模块化性和可扩展性,但它也带来了一个重大风险:一项服务的故障可能会级联并导致整个系统瘫痪。 如果下游服务变得缓慢或无响应,则对上游服务的传入请求将开始堆积。如果它们都共享相同的内存、CPU 或线程池,则缓慢的依赖关系可能会快速耗尽所有可用资源,导致整个应用程序崩溃。 这种级联失败被称为多米诺骨牌效应。为了防止这种情况,系统架构师使用 Bulkhead 模式。 在本指南中,我们将探讨 Bulkhead 模式是什么、它是如何工作的,以及如何使用简单的类比、架构概念以及 Java (Resilience4j) 和 Go 中的代码示例来实现它。 现实世界的类比:水密船舶舱壁 这种图案的名字来源于造船业。 舱壁是建在船体内部的水密墙。船体内部不是一个单一的、巨大的开放空间,而是被分成几个独立的密封隔间。 如果船与障碍物相撞并且船体破裂,水就会涌入受损的舱室。然而,由于水密舱壁的存在,水被限制在单个隔间中。船的其余部分保持干燥和浮力,使其能够保持漂浮并到达安全地带。 如果没有舱壁,水会在整个船体中自由流动,最终导致船舶沉没。 在软件工程中: The Ship 是您的整个应用程序或服务。 隔间是隔离的资源池(线程、连接、CPU)。 船体破裂是下游微服务的故障或速度减慢。 洪水是资源耗尽。 问题:共享资源池和线程耗尽 为了理解为什么需要隔板,让我们看看当资源在全球范围内共享时会发生什么。 想象一下 API 网关或处理用户请求的 Web 服务器。它有一个包含 100 个线程的全局线程池来处理所有传入呼叫。服务器与三个下游服务交互: 目录服务(快速,读取产品列表) 支付服务(快速、流程结帐) 推荐服务(慢,计算个性化物品) 正常情况下,一切正常。但假设推荐服务遇到数据库死锁,并且开始需要 30 秒而不是 200 毫秒来响应。 发生的情况如下: 用户持续访问首页,触发推荐服务请求。 服务器从全局池中为每个请求分配一个线程。 由于推荐服务速度较慢,因此这些线程会等待响应。 几秒钟内,池中的所有 100 个线程都在等待推荐服务。 当新用户尝试结账或查看目录时,服务器没有剩余线程来处理他们的请求。 尽管目录和支付服务完全健康,但它们现在无法访问,因为缓慢的推荐服务耗尽了共享线程池。整个系统已经离线。
Microservices Bulkhead Pattern Software Architecture System Design Fault Tolerance Resilience