🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

Microservices

Quarkus 与 Spring Boot:您应该选择哪个 Java 框架?

Quarkus 与 Spring Boot:您应该选择哪个 Java 框架?

十多年来,Spring Boot 一直是构建企业 Java 应用程序的事实上的标准。其丰富的生态系统、约定优于配置的范例、强大的依赖注入引擎和广泛的社区支持使 Java 成为全球后端系统的基石。 然而,向云原生架构、Kubernetes 编排、Docker 容器化和无服务器执行(AWS Lambda、Knative) 的转变给后端基础设施带来了新的技术挑战:内存效率、即时扩展和冷启动延迟。 传统的 Java 框架是为长期运行的整体服务器而设计的,最初并不是为短暂的容器化环境而设计的。当微服务在 Kubernetes 上从 0 个实例水平扩展到 50 个实例或作为短期无服务器函数执行时,等待 3 到 10 秒等待 Java 虚拟机 (JVM) 进程启动(同时消耗 200MB 以上的堆内存)会带来运营和财务障碍。 输入 Quarkus:一个从头开始构建的 Kubernetes 原生 Java 框架,专为 GraalVM 和 OpenJDK HotSpot 定制 Java。 Quarkus 被称为“超音速亚原子 Java”*,从根本上重新定义了 Java 代码的编译、启动和执行方式。 在本架构比较指南中,我们将在核心架构、运行时内存、冷启动时间、开发人员体验、响应式模型、生态系统成熟度和可操作的决策框架等方面详细分析 Quarkus 与 Spring Boot,以帮助您为下一个项目选择正确的框架。 1. 核心架构理念 Spring Boot 和 Quarkus 之间的根本区别在于何时应用程序元数据、依赖关系连接和配置扫描发生:运行时与构建时。
Java Quarkus Spring Boot GraalVM Microservices Cloud Native Kubernetes JVM Software Architecture
Quarkus 简介:为什么 Java 开发人员转向 Supersonic Java

Quarkus 简介:为什么 Java 开发人员转向 Supersonic Java

近三十年来,Java 一直是企业软件开发的主导力量。其丰富的生态系统、强大的面向对象基础、通过 Java 虚拟机 (JVM) 实现的平台独立性以及像 Spring Boot 这样久经考验的框架,使其成为无可争议的后端基础设施之王。 然而,向云原生架构、Kubernetes 编排、容器化 (Docker) 和 无服务器计算(AWS Lambda、Knative) 的转变暴露了传统 Java 应用程序框架中的一个严重漏洞:内存开销高和启动时间慢。 当微服务需要从 0 到 100 个副本水平扩展以响应流量峰值时,或者当无服务器功能按需执行时,等待 3 到 10 秒等待 Java 进程启动是不可接受的。现代云基础设施需要即时启动和轻量的内存消耗——传统上为 Go、Rust 或 Node.js 等语言保留的特征。 输入 Quarkus:一个专为 GraalVM 和 OpenJDK HotSpot 设计的 Kubernetes 原生 Java 框架。 Quarkus 通常被称为“超音速亚原子 Java”*,它从根本上重新设计了 Java 应用程序的编译、启动和运行方式。 在本深入指南中,我们将探讨 Java 开发人员为何采用 Quarkus、Quarkus 如何实现亚秒级启动时间和微内存占用、构建时优化的架构机制,以及如何使用 Quarkus 在 Java 中构建可用于生产的反应式微服务。
Java Quarkus GraalVM Microservices Cloud Native Spring Boot JVM Software Architecture Serverless
Saga 模式:微服务架构中的分布式事务

Saga 模式:微服务架构中的分布式事务

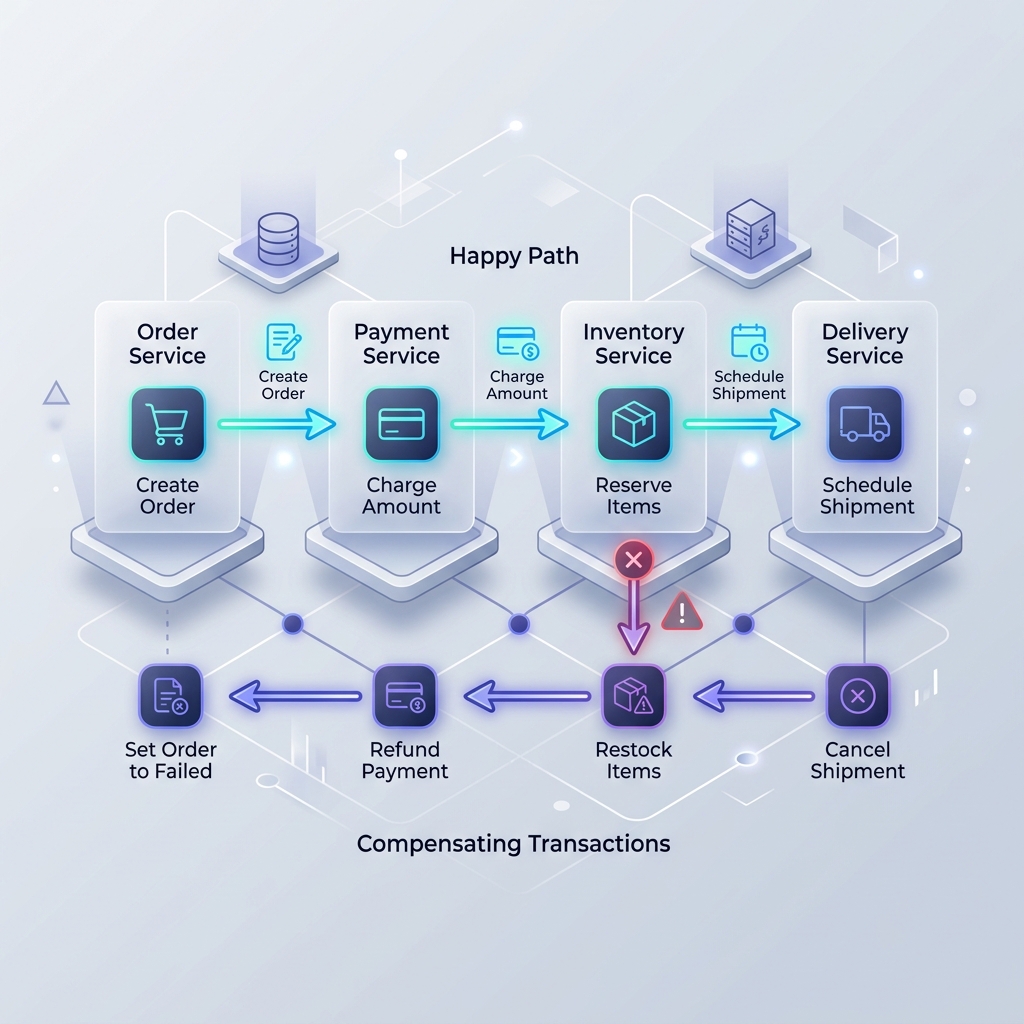
在传统的整体应用程序中,维护多个实体之间的数据一致性非常简单。关系数据库引擎提供封装在本地 SQL 事务中的 ACID(原子性、一致性、隔离性、持久性)保证。如果下单、付款扣除或库存储备中途失败,调用 ROLLBACK 会立即恢复每个数据库修改。 然而,当迁移到现代微服务架构时,数据管理发生了根本性的变化。为了保证域自治和独立的可扩展性,每个微服务都拥有自己的私有数据库。单个业务操作(例如处理电子商务结帐)现在跨越多个服务边界和数据库引擎(例如,用于订单的 PostgreSQL、用于支付的 DynamoDB、用于库存的 Redis)。 由于分布式微服务不能依赖于单个数据库事务,因此维护跨网络边界的数据一致性成为分布式系统工程中最具挑战性的问题之一。 为了在不牺牲系统可用性或性能的情况下解决这个问题,软件架构师依赖 Saga 模式。 在本次深入研究中,我们将探讨传统分布式事务失败的原因,分解 Saga 模式的核心机制,比较 C​​horeography 与 Orchestration,分析隔离对策,检查 Go 和 Java 中的生产代码实现,并学习如何安全地处理现实世界的故障回滚。 根本问题:为什么微服务中的两阶段提交 (2PC) 失败 在采用 Saga 模式之前,工程师经常会问:为什么我们不能在微服务中使用传统的两阶段提交(2PC / XA)? 2PC 的机制 两阶段提交使用中央事务管理器分两个阶段协调跨多个数据库节点的分布式事务: 准备阶段:事务管理器要求所有参与的数据库节点准备并锁定所需的行。参与者投票 YES 或 NO。 提交阶段:如果所有参与者都投票了 YES,则管理器向所有节点发出 COMMIT 命令。如果任何节点投票 NO 或超时,它会发出 ROLLBACK。 Client ----> Transaction Manager | +-------------+-------------+ | (Prepare) | (Prepare) | (Prepare) v v v Order DB Payment DB Inventory DB 为什么 2PC 是微服务的反模式 虽然 2PC 保证了强一致性,但由于几个架构缺陷,它在云原生微服务环境中崩溃了:
Microservices Saga Pattern Distributed Transactions Event-Driven Architecture Kafka Orchestration Choreography System Design
Transactional Outbox 模式:微服务中可靠事件发布指南

Transactional Outbox 模式:微服务中可靠事件发布指南

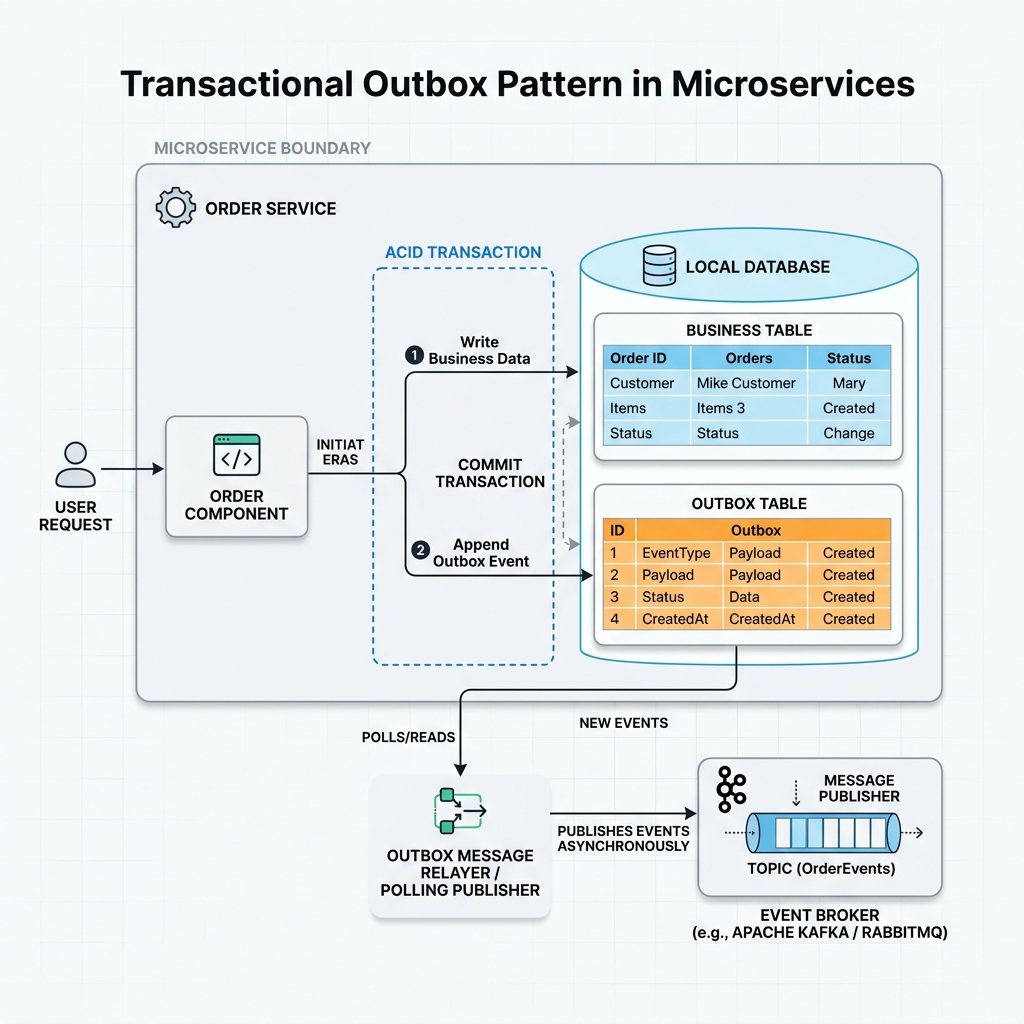
在现代分布式微服务架构中,事件驱动架构 (Event-Driven Architecture) 已经成为实现系统解耦与高扩展性的核心基石。微服务会定期触发领域事件(如 OrderCreated、PaymentProcessed)以同步状态变更。 然而,如何保证事件发布的绝对可靠性却是一个关键挑战:如何确保数据库更新与对应的事件发布要么同时成功,要么同时失败? 如果微服务先更新本地数据库(如 PostgreSQL 或 MySQL),再通过网络将消息发送至消息中间件(如 Apache Kafka 或 RabbitMQ),一旦发生网络抖动或服务崩溃,就会导致数据不一致。 为彻底解决这一难题,系统架构师普遍采用 Transactional Outbox 模式。 核心痛点:双写问题 (Dual-Write Problem) 在传统的双写实现中,微服务按顺序执行两个独立操作: 将业务数据写入本地数据库。 将事件消息发送至 Kafka 消息队列。 如果数据库事务提交成功,但随后由于网络故障导致 Kafka 发送失败,数据库中保存了订单,但下游服务却永远无法收到通知。结果:数据严重不一致。 什么是 Transactional Outbox 模式? 该模式充分利用了关系型数据库原生的 ACID 局部事务 特性。 微服务不再在 HTTP 请求生命周期内直接向网络发送消息,而是将事件 Payload 写入同一个数据库中的 Outbox 表,该写入操作与业务实体的更新处于 同一个本地事务 中。 数据库 ACID 机制保证了:业务数据与 Outbox 事件记录要么同时提交成功,要么同时回滚。
Microservices Outbox Pattern Distributed Systems Kafka Debezium Event-Driven Architecture System Design
回退模式:在微服务中设计优雅的降级

回退模式:在微服务中设计优雅的降级

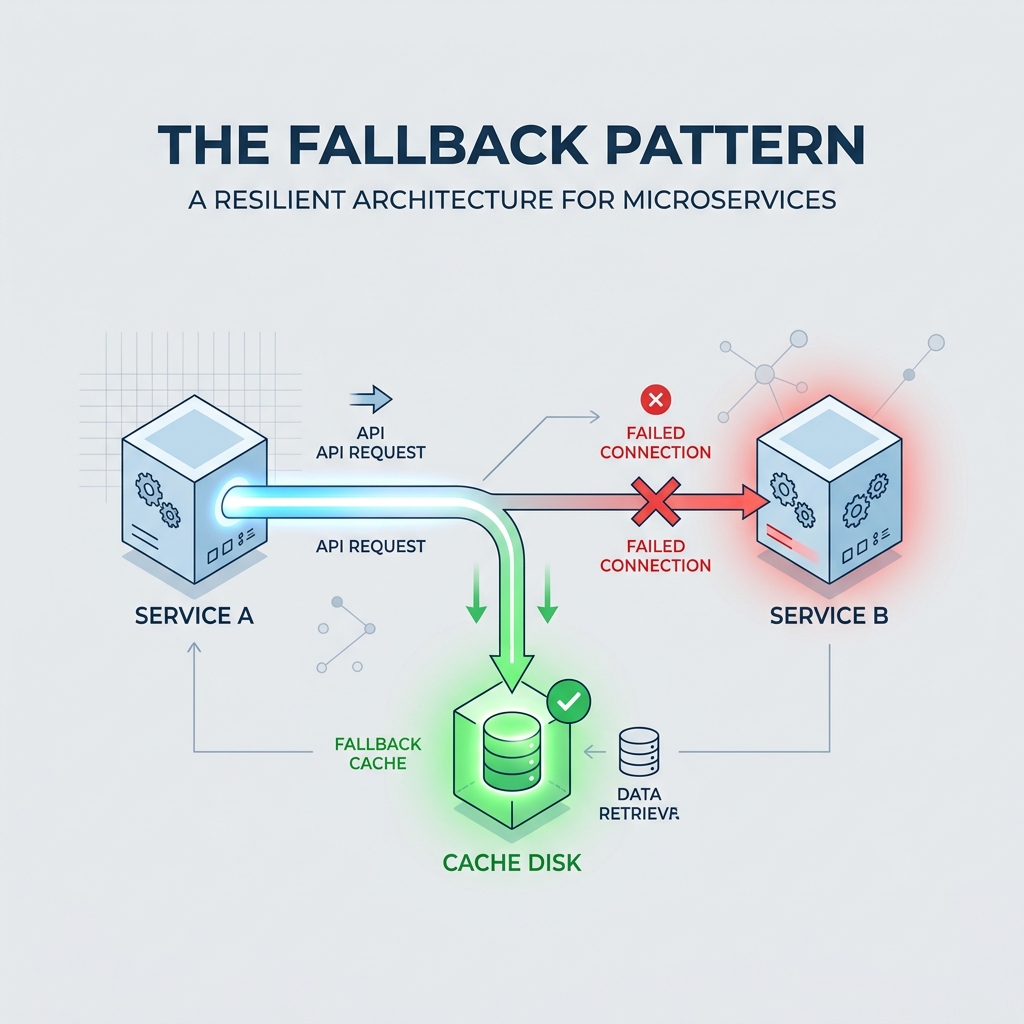
在微服务架构中,服务形成分布式网络调用的网络。虽然这允许团队独立构建和扩展服务,但这也意味着系统的整体可靠性取决于其最薄弱的环节。如果关键服务出现故障或变得无响应,则可能会触发级联故障,从而中断整个应用程序。 当单个依赖项失败时,向用户返回通用的“500 内部服务器错误”或空白页面是一种糟糕的用户体验。相反,弹性系统是为了在出现问题时优雅地降级而构建的。 这就是 后备模式 的用武之地。通过在主服务调用失败时定义安全的替代执行路径,您可以保持应用程序正常运行 - 即使在降级状态下也是如此。 在本指南中,我们将探讨回退模式、实现它的常见策略、它如何与其他弹性模式交互,以及如何用 Java (Resilience4j) 和 Go 编写回退逻辑。 现实世界的类比:咖啡店后备计划 想象一下您走进当地一家咖啡店买一杯拿铁咖啡。咖啡师输入您的订单,但当您刷卡时,支付终端会显示连接错误 - 商店的互联网提供商遇到中断。 咖啡店是否立即关灯、锁门并送所有顾客回家? 当然不是。他们实施了后备策略: 如果他们手头有现金,他们会询问您是否可以用现金支付。 如果您是常客,咖啡师可能会将您的姓名和订单记在账本上,并要求您在下次光顾时付款。 他们可能会使用离线读卡器,在本地存储卡令牌,并在互联网恢复后处理付款。 在软件设计中: 咖啡订单是客户请求。 卡终端是主要下游服务(例如支付网关 API)。 互联网中断是网络超时或服务崩溃。 Ledger / Offline Reader 是后备执行路径。 常见的后备策略 根据业务逻辑和失败服务的严重性,您可以从多种后备策略中进行选择: 1. 静态默认值 最简单的策略是返回一个安全的、预先配置的静态值。这对于可以接受显示空白或默认数据的非关键功能非常有效。 示例:如果个人资料个性化服务失败,则返回默认头像图像和通用问候语。 示例:如果推荐服务失败,则返回空列表或通用畅销书的硬编码列表,而不是抛出错误。 2. 缓存响应(Stale-While-Revalidate) 如果实时数据不可用,您可以回退到本地缓存或快速分布式内存存储(如 Redis)中的只读、陈旧数据。 示例:如果产品库存服务出现故障,则显示 5 分钟前缓存的库存数量,并显示一条微妙的 UI 消息,指示数据可能不是完全最新的。 示例:如果用户设置服务失败,请加载缓存的用户配置文件,而不是阻止其登录流程。 3.替代服务(多提供商) 当执行必须成功的关键操作时,您可以配置辅助服务提供商作为备份。
Microservices Fallback Pattern Software Architecture System Design Fault Tolerance Resilience
重试模式:构建弹性微服务

重试模式:构建弹性微服务

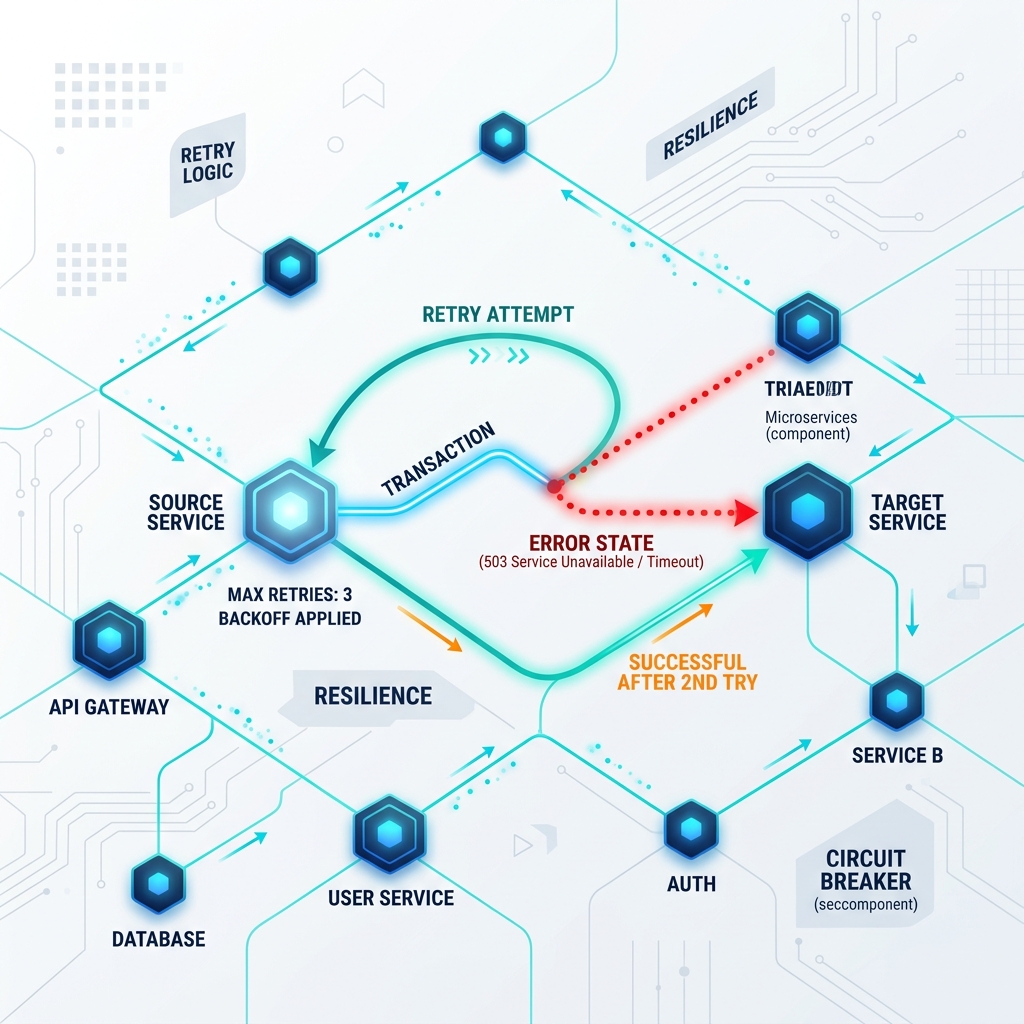
在微服务架构中,服务通过网络而不是内存中的调用进行通信。虽然这种解耦可以实现大规模水平扩展和独立部署,但它也引入了一个主要漏洞:网络不可靠。 下游服务随时可能会遇到短暂的网络故障、临时的 CPU 峰值、快速的数据库锁定争用或滚动更新重启。这些临时故障称为“暂时性故障”。 如果您的服务在下游调用失败时立即抛出错误并导致请求失败,则会造成脆弱的用户体验。相反,许多暂时性错误可以通过等待片刻并重试来自动解决。这就是 重试模式 的用武之地。 在本指南中,我们将探讨重试模式、它的幕后工作原理、简单实现的危险,以及如何在 Java (Resilience4j) 和 Go 中正确实现它。 现实世界的类比:重拨占线的线路 想象一下您正在尝试给朋友打电话。您拨打他们的号码,但收到忙音,因为他们当前正在通话。 您是否会立即放弃,删除他们的联系方式,并认为您永远无法再与他们交谈?当然不是。您挂断电话,稍等一下,然后再次拨打他们的号码。如果他们仍然很忙,您可以等待五分钟再重试。 最终,他们的通话结束,您的重试成功。 在微服务中: Call 是对下游服务的 API 请求。 忙信号是暂时性网络错误或 503 Service Unavailable 响应。 重拨 是重试尝试。 等待时间 是退避持续时间。 危险:天真的重试和“重试风暴” 乍一看,实现重试机制似乎微不足道:只需将 HTTP 调用包装在 for 循环中,然后继续尝试,直到成功为止。然而,天真的重试实现很容易将一个小问题演变成灾难性的系统范围中断。 想象一下下游服务在流量突然激增的情况下陷入困境。其数据库以 99% 的 CPU 利用率运行,并且请求开始超时。 如果 100 个客户端服务都检测到超时并立即重试 3 次而无需等待,它们将突然使已经陷入困境的下游服务的流量增加三倍。这种流量的突然放大被称为“重试风暴”(或“Thundering Herd”问题)。 您的重试不但不会帮助下游服务恢复,反而会不断将其推低,使其无法跟上。 解决方案:退避和抖动 为了防止重试风暴,弹性系统必须利用两个基本策略:退避和抖动。
Microservices Retry Pattern Software Architecture System Design Fault Tolerance Resilience
舱壁模式:设计容错微服务

舱壁模式:设计容错微服务

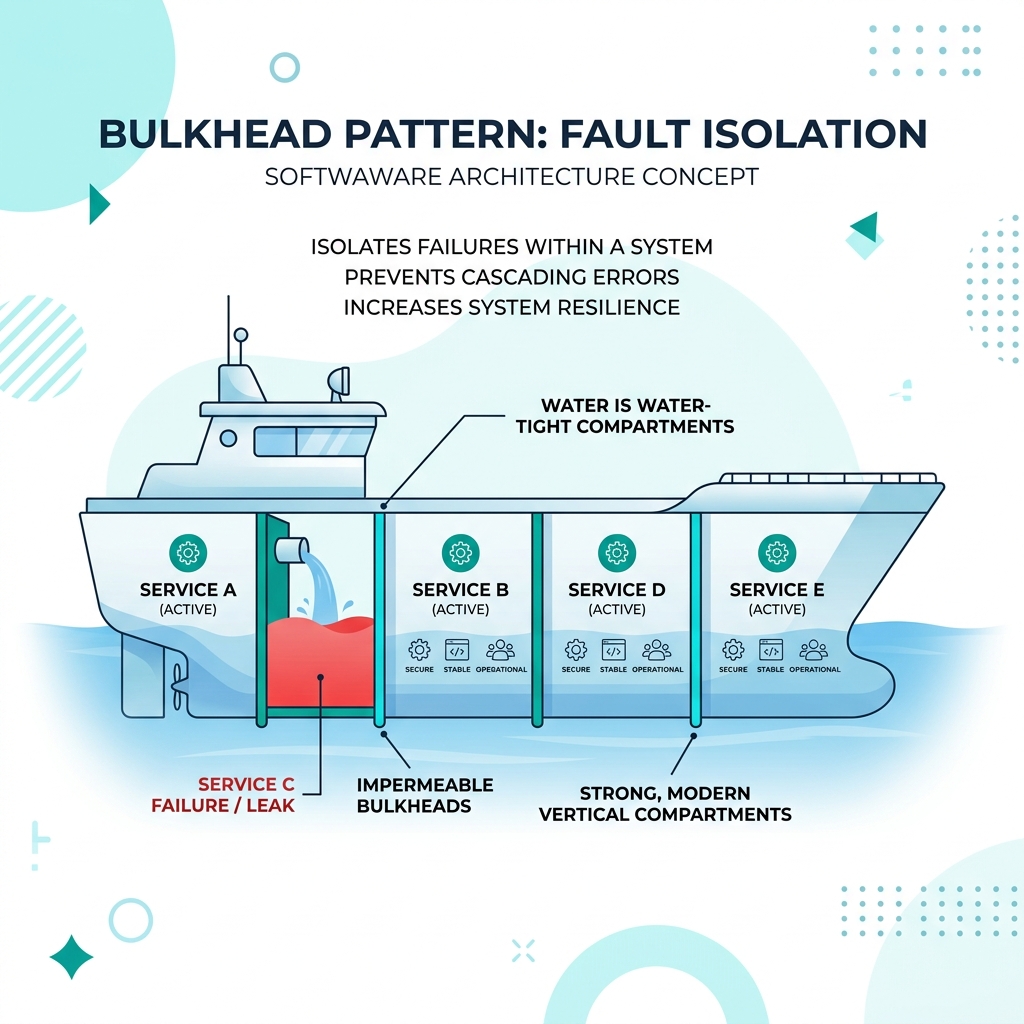
在微服务架构中,单个应用程序被分解为数十或数百个独立的协作服务。虽然这种设计提高了模块化性和可扩展性,但它也带来了一个重大风险:一项服务的故障可能会级联并导致整个系统瘫痪。 如果下游服务变得缓慢或无响应,则对上游服务的传入请求将开始堆积。如果它们都共享相同的内存、CPU 或线程池,则缓慢的依赖关系可能会快速耗尽所有可用资源,导致整个应用程序崩溃。 这种级联失败被称为多米诺骨牌效应。为了防止这种情况,系统架构师使用 Bulkhead 模式。 在本指南中,我们将探讨 Bulkhead 模式是什么、它是如何工作的,以及如何使用简单的类比、架构概念以及 Java (Resilience4j) 和 Go 中的代码示例来实现它。 现实世界的类比:水密船舶舱壁 这种图案的名字来源于造船业。 舱壁是建在船体内部的水密墙。船体内部不是一个单一的、巨大的开放空间,而是被分成几个独立的密封隔间。 如果船与障碍物相撞并且船体破裂,水就会涌入受损的舱室。然而,由于水密舱壁的存在,水被限制在单个隔间中。船的其余部分保持干燥和浮力,使其能够保持漂浮并到达安全地带。 如果没有舱壁,水会在整个船体中自由流动,最终导致船舶沉没。 在软件工程中: The Ship 是您的整个应用程序或服务。 隔间是隔离的资源池(线程、连接、CPU)。 船体破裂是下游微服务的故障或速度减慢。 洪水是资源耗尽。 问题:共享资源池和线程耗尽 为了理解为什么需要隔板,让我们看看当资源在全球范围内共享时会发生什么。 想象一下 API 网关或处理用户请求的 Web 服务器。它有一个包含 100 个线程的全局线程池来处理所有传入呼叫。服务器与三个下游服务交互: 目录服务(快速,读取产品列表) 支付服务(快速、流程结帐) 推荐服务(慢,计算个性化物品) 正常情况下,一切正常。但假设推荐服务遇到数据库死锁,并且开始需要 30 秒而不是 200 毫秒来响应。 发生的情况如下: 用户持续访问首页,触发推荐服务请求。 服务器从全局池中为每个请求分配一个线程。 由于推荐服务速度较慢,因此这些线程会等待响应。 几秒钟内,池中的所有 100 个线程都在等待推荐服务。 当新用户尝试结账或查看目录时,服务器没有剩余线程来处理他们的请求。 尽管目录和支付服务完全健康,但它们现在无法访问,因为缓慢的推荐服务耗尽了共享线程池。整个系统已经离线。
Microservices Bulkhead Pattern Software Architecture System Design Fault Tolerance Resilience
Sidecar 模式:无需修改代码即可扩展微服务

Sidecar 模式:无需修改代码即可扩展微服务

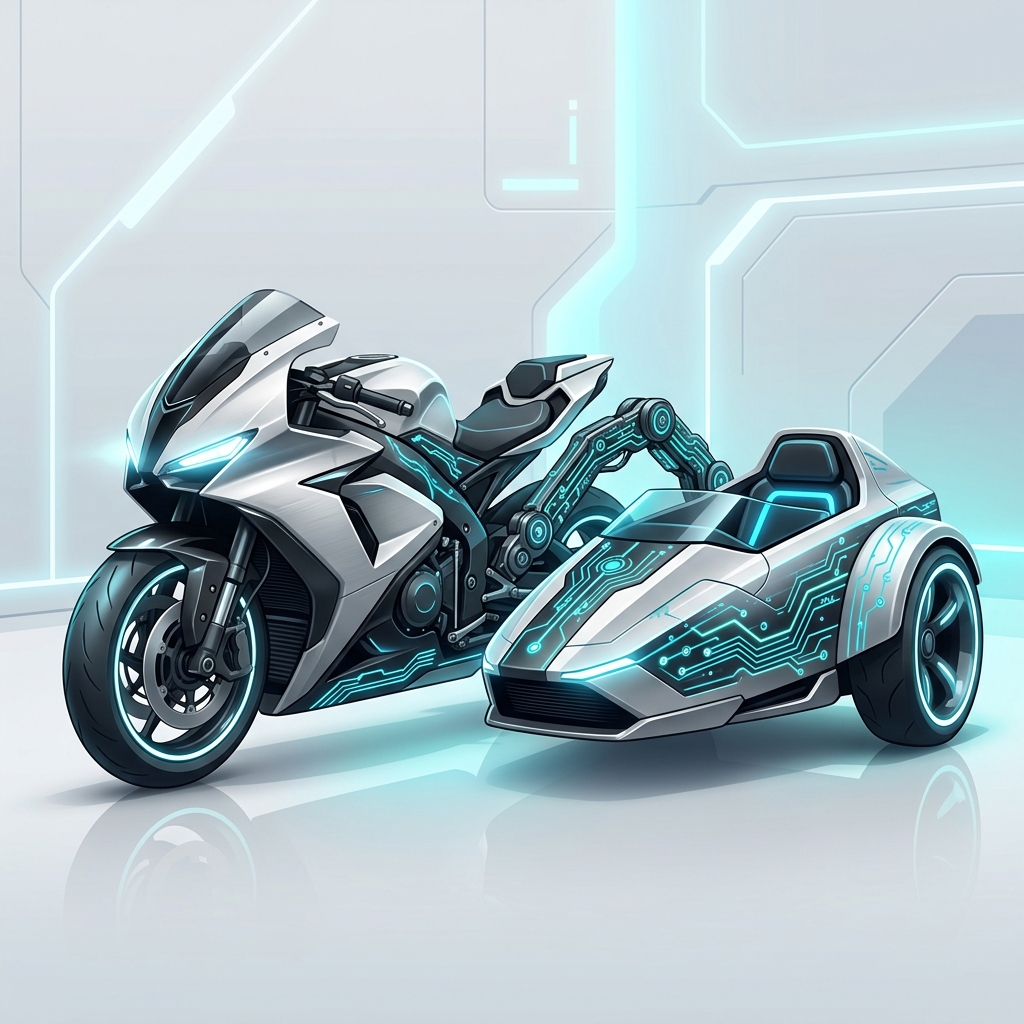
在现代云原生系统中,微服务的作用不仅仅是运行业务逻辑。他们必须处理日志记录、管理 SSL/TLS 证书、收集指标、实施重试机制以及协调与其他服务的安全通信。 如果我们将所有这些横切功能直接嵌入到每个应用程序的代码库中,最终会导致代码膨胀、紧密耦合和语言锁定。 这就是 Sidecar 模式 的用武之地。在本指南中,我们将使用简单的类比和 Kubernetes 配置示例来详细介绍 Sidecar 模式是什么、为什么它对于现代微服务架构至关重要,以及它是如何工作的。 现实世界的类比:摩托车边车 理解这种模式的最简单方法是想象一辆带边车的摩托车。 想象一下您有一辆高性能摩托车。它的设计初衷是为了出色地完成一件事:快速运送一名乘客。现在,假设您需要携带乘客行李或添加额外的座位。 您可以完全重新设计摩托车的车架、发动机和车轮,将其变成汽车。然而,这需要付出巨大的努力,破坏了自行车的简单性,并且使其难以维护。 相反,您附加一个 sidecar。 边车是一个独立的、独立的单元,连接到摩托车。它共享摩托车的旅程,摩托车去往任何地方,并且紧密配合运行。然而,摩托车的核心发动机仍然没有受到影响。 在软件架构上: 摩托车 是您的主要应用程序容器(运行核心业务逻辑,例如结账或用户身份验证)。 Sidecar 是一个单独的帮助容器(运行实用程序任务,例如 SSL 终止、监控或日志传送)。 旅程是部署的生命周期(例如,Kubernetes Pod)。 问题:交叉关注点和代码膨胀 在 sidecar 出现之前,开发人员必须将辅助库直接包含在他们的应用程序代码中。例如,如果您想将日志发送到中央服务器,则可以导入日志库。如果您需要指标,则添加了指标 SDK。 这种基于库的方法带来了几个重大挑战: 语言锁定:如果监控库仅用 Go 编写,则无法轻松在 Python 或 Java 微服务中使用它。您必须为堆栈中的每种语言找到或构建一个库。 代码污染:业务逻辑因用于重试、服务发现、加密和日志记录的基础设施特定代码而变得混乱。 复杂升级:如果在通信库中发现安全漏洞,每个微服务都必须更新其依赖项、重新编译和重新部署。 资源争用:帮助程序代码与主应用程序在同一运行时进程中运行,这意味着记录器中的内存泄漏可能会导致整个核心应用程序崩溃。 解决方案:Sidecar 模式 Sidecar 模式通过将辅助任务移出主应用程序进程并将其放入紧邻应用程序运行的单独的独立进程中来解决这些问题。
Microservices Sidecar Pattern Software Architecture System Design Kubernetes DevOps
Strangler Fig 模式:迁移单体应用程序的安全方法

Strangler Fig 模式:迁移单体应用程序的安全方法

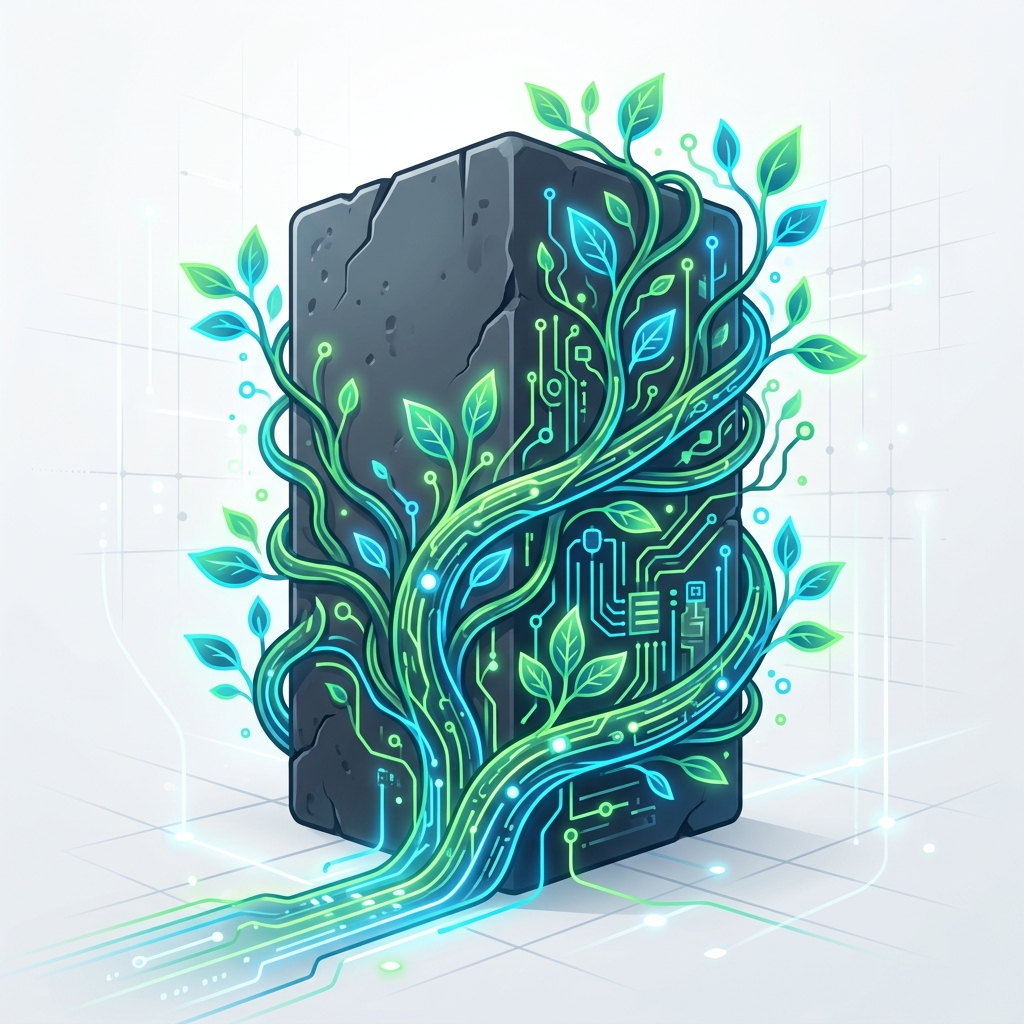
在现代软件工程中,遗留的单体应用程序是一个常见的挑战。随着时间的推移,一个成功的代码库变得如此庞大且相互关联,以至于简单的更改都会变得有风险,部署需要数小时,并且扩展单个功能几乎是不可能的。 当团队决定通过迁移到微服务来实现系统现代化时,他们面临一个高风险问题:我们如何在不破坏当前业务的情况下重写系统? 一种选择是“大爆炸”重写——关起门来从头开始构建新系统,并在一天之内切换所有内容。然而,这是非常危险的,并且经常会导致失败。 幸运的是,有一个更安全、更可靠的替代方案:扼杀者无花果图案。在本指南中,我们将探讨 Strangler Fig 模式是什么、它为何有效,以及如何使用清晰的图表和实际代码逐步应用它。 现实世界的类比:绞杀者无花果植物 该图案以绞杀无花果命名,这是一种原产于热带雨林的植物。 绞杀无花果种子在现有“寄主”树的上部树枝上发芽。无花果不是从地面向上生长,而是向下生长: 它将根部沿着寄主树的树干向下延伸,直到到达森林地面并固定在土壤中。 随着时间的推移,更多的根会生长出来,包裹住宿主,并融合在一起。 无花果长出的叶子会阻挡光线到达寄主树。 最终,寄主树死亡并腐烂,留下一棵空心的绞杀无花果树坚强地矗立在它的位置上。 在软件架构中,传统的单体是主机树,新的微服务是绞杀者​​图。我们围绕整体系统的边缘构建新服务,逐渐将流量从遗留系统中转移出来,直到整体系统可以完全关闭。 为什么“大爆炸”重写失败 在深入探讨 Strangler Fig 模式的机制之前,让我们先了解为什么替代方案(完全重写)如此危险: 数月(或数年)没有价值:开发人员花费很长时间编写代码,但在整个项目完成之前,所有代码都不会上线。 范围蔓延:在两年重写期间,业务需求发生变化。目标发生了变化,新系统必须支持重写开始时不存在的功能。 缺少隐式行为:单体包含多年未记录的错误修复和边缘情况处理。彻底重写常常会忘记这些细节。 高部署风险:如果出现问题,关闭大型遗留系统并立即打开新系统会产生巨大的爆炸半径。 扼杀者无花果图案的工作原理 Strangler Fig 模式的核心思想是增量迁移。您无需迁移整个系统,而是一次迁移一个小功能或“片段”。 迁移过程分五个关键阶段执行: 1. 识别有界上下文 查看您的整体架构并确定易于提取的单一、独立的业务功能。好的候选人包括: 经常更改的功能(因此团队可以从独立部署中快速受益)。 用于测试迁移管道的简单、低风险功能(例如静态常见问题解答或用户首选项部分)。 具有清晰、定义明确的数据库边界的功能。 2. 实施新的微服务 将已确定的功能构建为全新的现代微服务。该服务拥有自己的数据库、自己的部署管道,并且是使用现代技术堆栈构建的。至关重要的是,单体应用中的旧功能目前仍然有效且没有变化。 3.引入拦截层 为了使迁移对用户透明,您可以在应用程序前面引入拦截层(例如 API 网关或反向代理)。现在所有客户端流量都会首先流向此网关。 最初,网关将 100% 的所有请求路由到遗留单体。 4. 增量过渡流量 一旦新的微服务经过全面测试并准备就绪,您就可以更新拦截层中的路由规则。网关不会将迁移功能(例如 /api/users)的请求路由到整体架构,而是将它们重定向到新的微服务。
Software Architecture Microservices Monolith Migration System Design Strangler Fig API Routing Refactoring
了解前端后端 (BFF) 模式:简单指南

了解前端后端 (BFF) 模式:简单指南

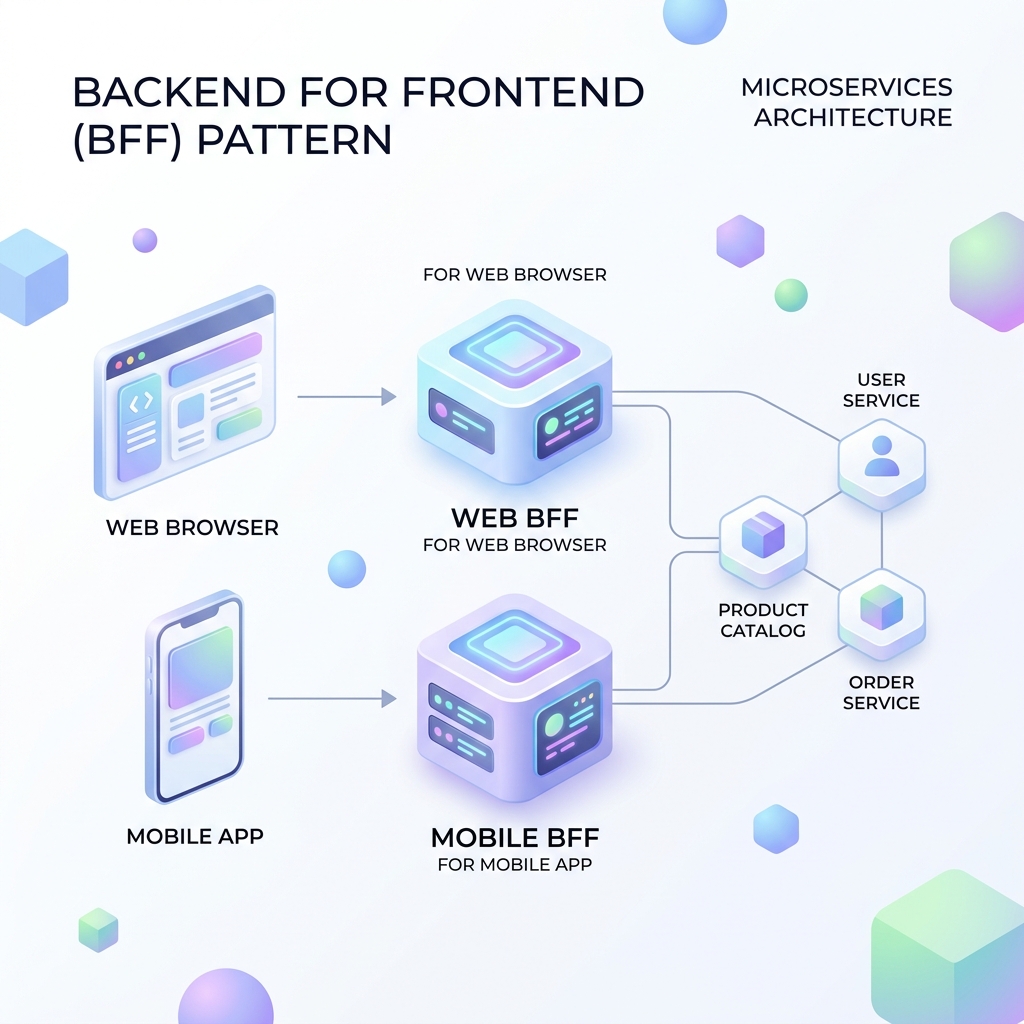
在微服务架构中,我们的系统被分解为数十个小型的、集中的服务,例如用户服务、订单服务和产品服务。 但是,在向用户显示此信息时,不同的设备有非常不同的需求。高速台式计算机上的网络浏览器需要一个包含表格、侧边栏和图表的丰富仪表板。慢速蜂窝网络上的移动应用程序需要简单、轻量级的布局来节省带宽和电池。智能手表应用程序可能只需要一行文本。 如果所有这些前端都查询完全相同的后端 API,则必须有人做出妥协。要么移动应用程序被迫下载大量无用的数据,要么网络应用程序被迫发出数十个单独的网络请求来获取所需的所有内容。 这正是 后端为前端 (BFF) 模式 解决的问题。在本指南中,我们将用简单的语言解释此模式,查看现实世界的类比,将其与标准 API 网关进行比较,并逐步完成实际的代码实现。 现实世界的类比:餐厅菜单 想象一家餐厅为三种截然不同类型的食客提供服务: 一位美食评论家想要一份完整的 5 道菜品尝菜单以及详细的成分列表。 忙碌的通勤者想要在火车上吃一份预先包装好的快餐。 一个孩子想要一份简单的儿童餐,份量小,没有辛辣的成分。 如果餐厅只有一份菜单详细列出所有三个选项,那就会让人不知所措。通勤者会浪费时间阅读 5 道菜的食谱,而孩子的父母则很难找到简单的食物选择。 相反,餐厅打印三个自定义菜单:品尝菜单、快速外带菜单和儿童菜单。 每个菜单都来自同一个厨房(微服务),但专门针对该客户(客户端)设置选项的格式和大小。 在这种情况下: 厨房代表您的微服务(用户、目录、付款)。 自定义菜单是您的BFF(Web BFF、移动 BFF、观看 BFF)。 食客是您的前端(桌面浏览器、移动应用程序、智能手表)。 问题:“一刀切”的 API 当微服务第一次流行时,许多团队构建了一个单一的、共享的 API 网关来处理所有前端客户端: 虽然单个入口点很好,但共享 API 引入了几个扩展瓶颈: 移动设备的有效负载膨胀:桌面 Web 应用程序需要用户的订单历史记录、帐单地址、个人资料图片和忠诚度积分。移动应用程序只需显示“最后订单:已发货”。通过共享 API,移动应用程序会下载整个配置文件有效负载,从而浪费宝贵的数据并减慢加载时间。 API 瓶颈:单个团队成为共享网关的瓶颈。如果iOS团队想要改变一个小的布局字段,他们必须等待共享网关团队部署新版本,从而减慢开发周期。 不同的安全需求:Web 浏览器可能需要基于 cookie 的会话来防止跨站点脚本 (XSS),而移动应用程序更喜欢基于令牌的 OAuth 标头。在单个服务器中处理这两者会产生复杂、混乱的代码。 解决方案:BFF 模式 BFF 模式提倡为 每个前端应用程序构建一个专用后端服务器,而不是为所有设备创建一个巨型网关。
Microservices BFF Pattern Backend for Frontend Software Architecture System Design Node.js
了解微服务中的 API 网关模式:简单指南

了解微服务中的 API 网关模式:简单指南

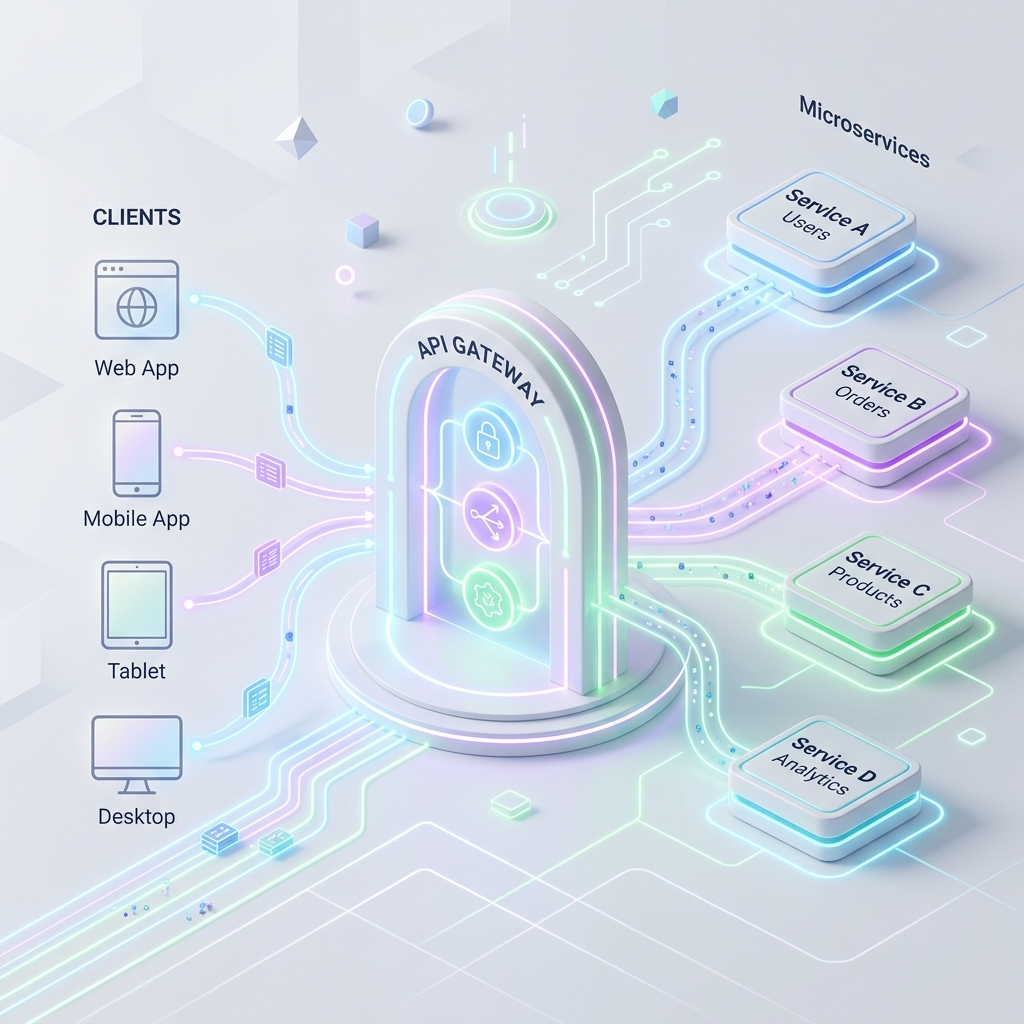
从单个整体应用程序过渡到微服务架构可以解决许多问题。它允许团队独立工作、单独部署服务并根据需要扩展系统的各个部分。然而,它也带来了一个新的挑战:客户如何与所有这些独立服务交互? 如果您有十个、五十个或数百个微型微服务,移动应用程序或网页是否应该直接连接到其中的每一个? 这就是 API 网关模式 的用武之地。在本指南中,我们将通过简单的文字和现实世界的类比来详细介绍 API 网关是什么、为什么需要它以及它如何简化您的微服务系统。 现实世界的类比:酒店接待员 想象一下您正在入住一家大型豪华度假酒店。度假村有许多不同的部门: 客房服务(干净的床单) 客房服务(食物) 礼宾部(预订旅游) 账单(用于支付账单) 如果您想要一条干净的毛巾,您不必穿过度假村试图找到客房服务大楼。如果你想吃晚饭,就不要敲厨房的门。相反,您可以致电前台接待员。 接待员听取您的请求,确定哪个部门可以解决,并为您联系或处理。 在这种情况下: 您 是客户端(移动应用程序或浏览器)。 接待员是API网关。 部门(客房服务、客房服务、计费)是微服务。 问题:客户端到服务的直接通信 在了解网关如何工作之前,让我们看看如果我们“不”使用网关会发生什么。 假设您的电子商务应用程序具有三个独立的微服务: 用户服务(管理个人资料) 产品服务(管理目录) 订单服务(管理结账) 如果没有 API 网关,客户端应用程序必须直接向每个服务的单独地址(IP 或 URL)发送单独的请求: 这种直接连接方法会带来几个主要问题: 太多端点:客户端应用程序必须记住三个单独的 URL。如果拆分服务或更改其地址,则必须更新客户端应用程序。 安全噩梦:每个微服务必须单独实现身份验证(检查登录令牌)、SSL 证书和防火墙规则。 网络开销:客户端可能需要通过慢速移动网络发出三个单独的网络请求才能加载单个页面(例如,获取配置文件、获取产品详细信息和获取订单历史记录)。 协议差异:您的客户端应用程序可能更喜欢使用 HTTP/JSON 等标准 Web 协议,但您的内部服务可能使用 gRPC 或 AMQP 等专用协议进行更快的通信。 解决方案:API 网关模式 API 网关 是位于客户端应用程序和内部微服务之间的辅助服务器。它充当所有传入请求的单一入口点。
Microservices API Gateway Software Architecture System Design Routing Security
为什么现代微服务更喜欢 gRPC 而不是 REST

为什么现代微服务更喜欢 gRPC 而不是 REST

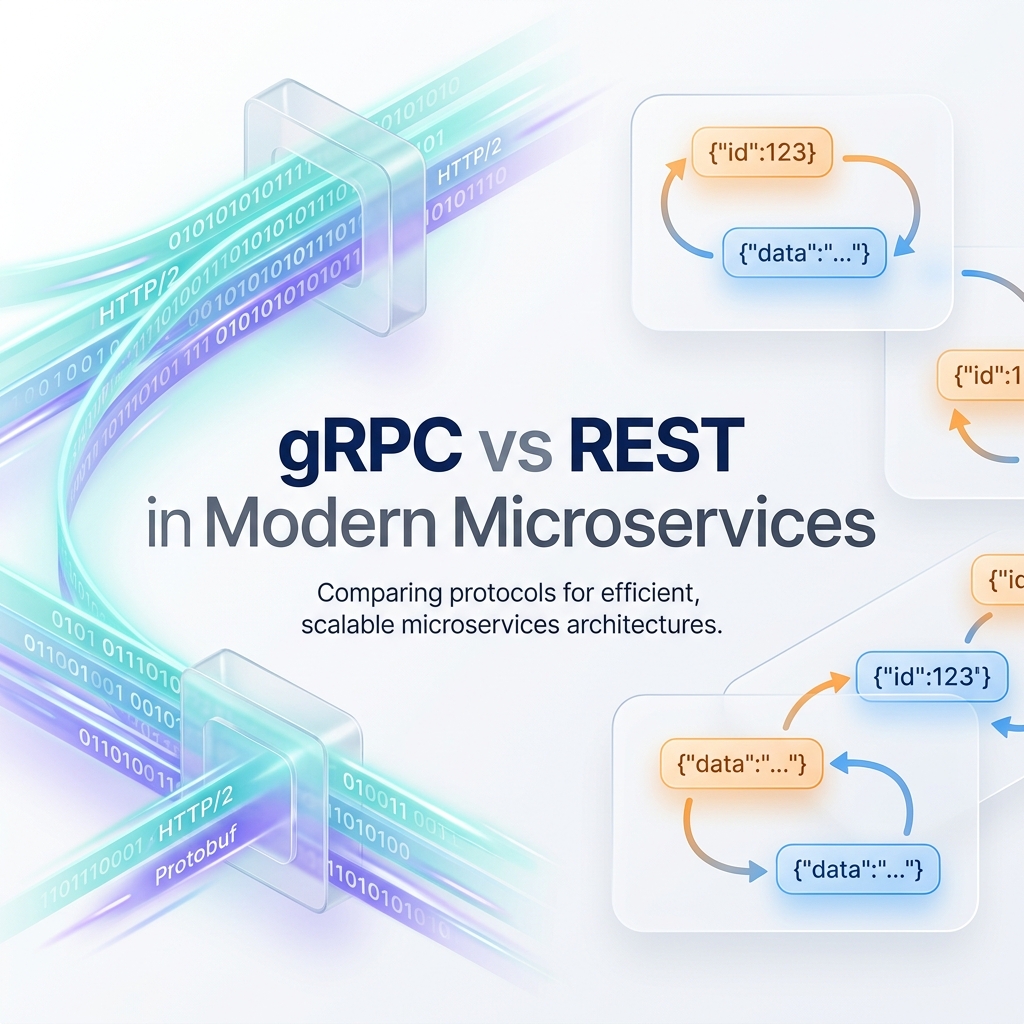
在整体架构中,组件通过内存中的方法调用进行通信,这是即时且高度可靠的。然而,当迁移到微服务架构时,这些组件被网络边界分隔开。通信变成进程外网络调用(进程间通信,或 IPC)。 多年来,通过 HTTP/1.1 和 JSON 有效负载的 REST(表述性状态传输) 一直是构建 Web API 的默认标准。虽然 REST 非常适合面向公众的 Web 服务和客户端到服务器交互,但当用于高频、低延迟、内部服务到服务通信时,它会带来严重的瓶颈。 这就是现代微服务迅速转向**gRPC(Google 远程过程调用)**的原因。在本文中,我们将分析 REST 的局限性,剖析 gRPC 的架构支柱,并逐步完成在 Java 中 gRPC 服务的完整实现。 1. 微服务中 REST 的瓶颈 REST 为网络提供了二十多年的动力。然而,其底层技术并未针对内部分布式架构进行优化: A. 纯文本 JSON 的开销 JSON 是人类可读的,这使得调试变得容易,但对于机器到机器的通信来说效率极低: 序列化/反序列化成本:解析文本字符串标记并将其转换为对象会消耗大量 CPU 周期。 大有效负载大小:JSON 键在每个请求中都会重复(例如 {"transactionId": "123", "amount": 99.99})。对于每秒处理数百万个请求的系统来说,这种冗余元数据浪费了巨大的网络带宽。 B. HTTP/1.1 连接限制 REST 通常在 HTTP/1.1 上运行,它表现出一些结构上的低效率: 队头 (HoL) 阻塞:在单个 TCP 连接上,客户端必须等待当前请求的响应,然后才能发送下一个请求。 连接池耗尽:为了处理并发请求,客户端必须打开多个 TCP 连接。当连接不断打开和关闭时,这会导致显着的操作系统资源开销、套接字耗尽以及慢启动性能损失。 C. 弱 API 合约 REST API 缺乏内置的编译时合约。虽然 OpenAPI/Swagger 有助于记录 API,但它们与代码库是分开的。后端开发人员很容易更改 JSON 字段名称并意外破坏下游服务,而不会出现编译时警告。
gRPC REST Microservices Java Protocol Buffers HTTP/2 Software Architecture API Design
微服务中的领域驱动设计 (DDD)

微服务中的领域驱动设计 (DDD)

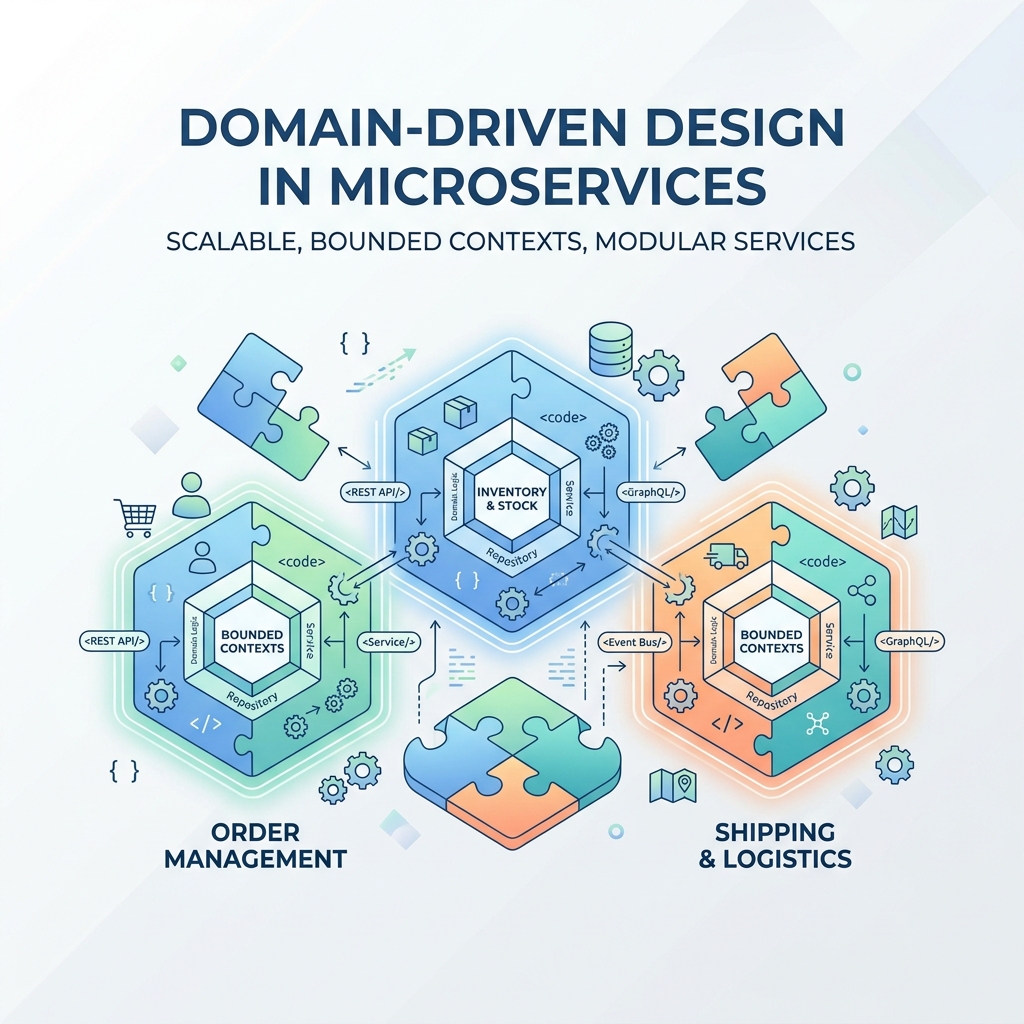
当组织从整体架构过渡到微服务时,他们面临一个关键的、高风险的问题:我们如何划定服务的边界? 理论上,微服务应该是松散的、解耦的单元,可以独立开发、部署和扩展。然而,在实践中,许多团队最终构建了一个分布式单体,该系统中的服务紧密耦合,以至于单个业务变更需要同时修改和部署多个服务,从而加剧了网络延迟和部署僵局。 为了避免这个陷阱,软件架构师转向领域驱动设计(DDD)。 DDD 是一种软件开发方法,由 Eric Evans 于 2003 年首次提出,它将代码结构与其所代表的复杂业务领域保持一致。 在本文中,我们将探讨 DDD 如何为设计干净、解耦和高度可维护的微服务提供战略和战术蓝图。 1. 战略蓝图:划定服务边界 DDD 分为两个主要阶段:战略设计和战术设计。战略设计是关于对业务环境进行建模并定义服务边界。它提供了架构的“宏观”视图。 A. 无处不在的语言 在企业内部,不同的部门使用相同的词语来表示完全不同的事物。例如: 对于 销售团队,“用户”是潜在客户或潜在客户。 对于安全团队来说,“用户”是一组登录凭据。 对于运输团队来说,“用户”是实际收件人地址。 尝试为“用户”构建一个满足每个人需求的单一、统一的数据库模型会导致庞大、混乱的代码库。 DDD 通过建立通用语言来解决这个问题,这是一种由业务领域专家和开发人员在特定边界内定义和使用的共享词汇表。 B. 有界上下文 有界上下文是领域模型应用的显式边界。在边界内,通用语言中的所有术语都具有单一的、明确的含义。 我们不是使用单个“用户”模型,而是在各自的限界上下文中定义单独的模型: 在订单上下文中,我们有一个包含客户联系信息的 Order 模型。 在身份上下文中,我们有一个 Credentials 模型。 在 Shipping Context 中,我们有一个 DeliveryAddress 模型。 微服务的黄金法则:一个有界上下文直接映射到一个微服务。 通过将系统划分为限界上下文,我们确保微服务松散耦合并代表不同的业务功能。 C. 上下文映射:服务如何通信 有界上下文并不是孤立存在的;他们必须互动。 上下文映射定义了上下文之间的关系和转换机制。关键模式包括:
Microservices Domain-Driven Design DDD Software Architecture Bounded Context System Design
现代应用程序中微服务的优点和挑战

现代应用程序中微服务的优点和挑战

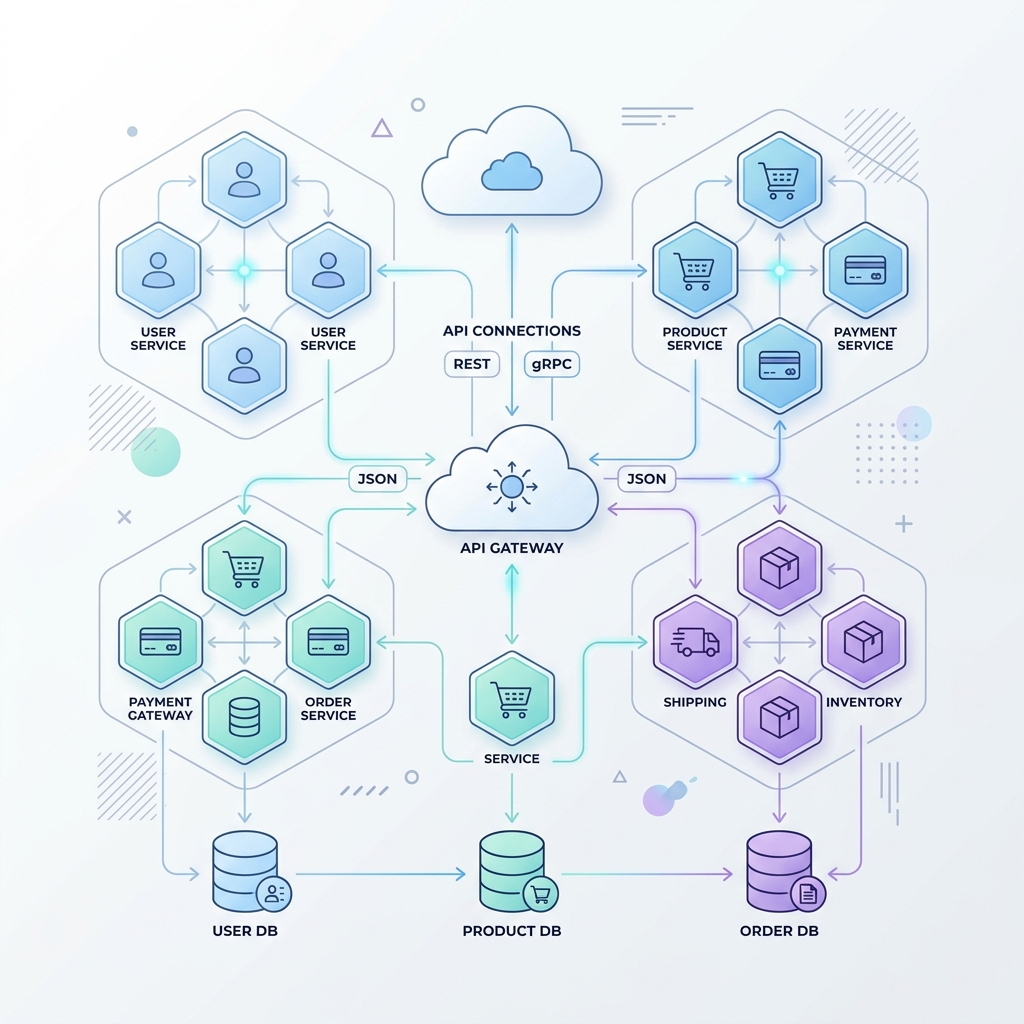
在 Web 开发的早期,构建软件应用程序非常简单:编写代码,将其打包到单个可执行或可部署的存档中,然后在服务器上运行。这种方法被称为单体架构,几十年来一直很好地服务于该行业。 然而,随着应用程序发展成为拥有数百名开发人员和数百万并发用户的大型企业平台,单体应用程序开始显示出其局限性。部署变得缓慢且危险,数据库成为瓶颈,代码库变得过于复杂,任何单个开发人员都无法理解。 为了解决这些扩展瓶颈,行业转向微服务架构。开发人员不是构建单个巨型应用程序,而是将系统分解为一组小型、独立且松散耦合的服务,这些服务通过 HTTP/REST、gRPC 或消息代理等轻量级协议进行通信。 在本文中,我们将分析微服务为现代应用程序带来的主要优势、它们带来的严峻挑战,以及如何确定该架构是否适合您的下一个项目。 1. 单体架构与微服务架构 在深入讨论细节之前,让我们先形象地了解这两种设计范式之间的根本区别。 在单体中,所有模块(例如,用户管理、产品目录、订单处理)共享相同的执行空间并写入单个共享数据库。在微服务设置中,每个服务都在自己的进程中运行,管理自己的私有数据库,并公开一个干净的 API。 API 网关 充当客户端的单一入口点,将请求路由到适当的后端服务。 2. 微服务的好处 采用微服务架构具有几个引人注目的优势,使其成为大规模现代系统的首选: A. 独立部署性和发布速度 在整体应用程序中,对结账系统进行微小的更改需要重建和重新部署整个应用程序。如果一个团队的功能被破坏,整个版本就会被阻止。 通过微服务,每个服务都有自己独立的 CI/CD 管道。运输服务团队每天可以部署更新十次,而无需与库存或支付团队协调,从而大大提高了功能交付速度。 B. 细粒度可扩展性 在单体应用程序中,如果结帐流程在黑色星期五期间遇到巨大的流量峰值,则必须水平扩展整个应用程序。这会为空闲模块消耗不必要的 CPU 和内存。 微服务允许有针对性的扩展。您可以启动 50 个订单和付款服务实例来处理负载,同时保持用户或通知服务以最少的资源运行,从而节省大量云托管成本。 C. 技术灵活性(多语言编程) 由于微服务通过标准化 API 协议(REST、gRPC)进行通信,因此团队不会被锁定在单一技术堆栈中: 用户服务可以用Go编写,以实现高性能的内存管理。 推荐引擎可以使用Python来获取其丰富的机器学习库。 支付网关可以用Java编写,以实现企业稳定性。 每个团队都可以为他们的具体问题选择最好的工具。 D. 故障隔离和系统弹性 如果单体应用程序中发生内存泄漏,整个进程就会崩溃,从而导致整个系统中断。 在微服务架构中,如果推荐服务由于错误而崩溃,应用程序的其余部分仍保持完整功能。用户仍然可以浏览产品、将商品添加到购物车并完成付款。故障是孤立的。 E. 团队协调和自治(康威定律) 康威定律指出,组织设计的系统模仿其通信结构。大型庞然大物通常会导致庞大的跨职能团队互相踩踏。 微服务允许组织将工程部门分解为小型、自治的“双比萨团队”。每个团队都拥有一个端到端的服务——从设计和编写代码到部署和数据库维护。
Microservices Software Architecture Distributed Systems API Gateway Saga Pattern DevOps