🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

人工智能

命名实体识别 (NER):从传统自然语言处理到 AI 驱动的数据提取

命名实体识别 (NER):从传统自然语言处理到 AI 驱动的数据提取

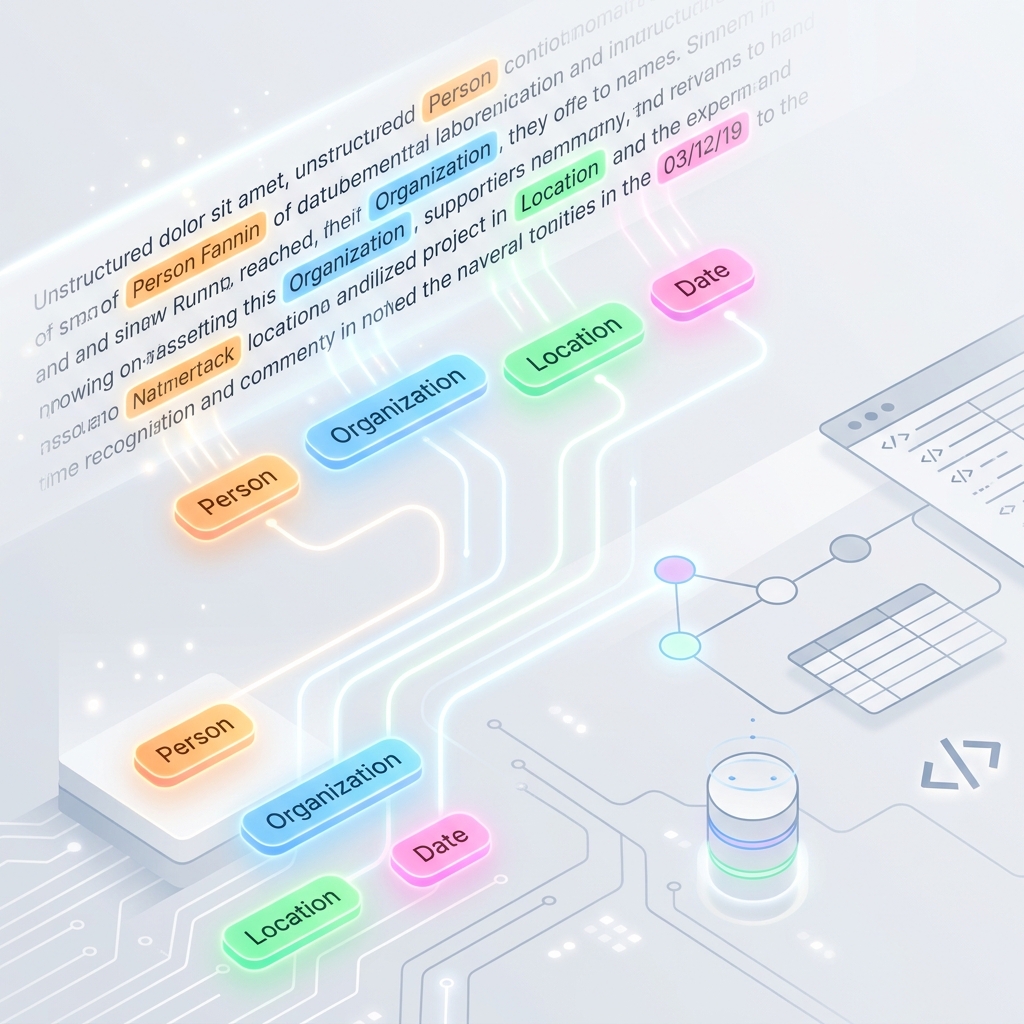
命名实体识别 (Named Entity Recognition,简称 NER) 是自然语言处理 (NLP) 的基石之一。它是从非结构化文本中自动识别关键元素,并将其归类到预定义类别(如人名、组织机构名、地理位置、日期、货币数值以及产品名称)的过程。 如果没有 NER,搜索引擎、推荐系统和自动化文档分析系统将很难理解文本中包含的“人、事、时、地”等核心信息。 本指南将带您全面了解 NER 的定义、该技术的发展历程,以及为什么现代生成式 AI 彻底改变了实体提取的方式。 1. NER 技术的发展演变 为了理解为什么基于 AI 的 NER 具有如此革命性的意义,我们需要回顾过去几十年来实体提取技术的发展阶段。 第一阶段:基于规则和词典的系统 早期的 NER 主要依赖于正则表达式 (Regex) 和人工整理的词典 (Gazetteers)。 工作原理:如果一个词存在于特定的地理位置数据库中,或者匹配某种模式(例如 [3位数字]-[3位数字]-[4位数字] 的电话号码),它就会被提取出来。 局限性:鲁棒性极差。它无法处理拼写错误、新出现的实体或上下文语义。例如,它无法区分 “Apple” 指的是水果还是这家科技公司。 第二阶段:传统 machine learning (CRF 与 SVM) 在 21 世纪初,条件随机场 (CRF) 和支持向量机 (SVM) 等统计机器学习模型成为了行业标准。 工作原理:工程师需要手动提取特征(例如前缀、后缀、大小写模式),并使用标注数据训练模型,以预测某个 Token 属于特定实体的概率。 局限性:需要大量的标注数据集,且手动特征工程非常繁琐耗时。 第三阶段:深度学习 (BiLSTM-CRF 与 BERT) 随着深度学习的兴起,双向长短期记忆网络 (BiLSTM) 结合 CRF,以及后来的 Transformer 模型(如 BERT)彻底改变了 NLP 领域。
人工智能 命名实体识别 自然语言处理 机器学习 大语言模型
深入理解 RAG 模型:利用真实世界知识增强大语言模型

深入理解 RAG 模型:利用真实世界知识增强大语言模型

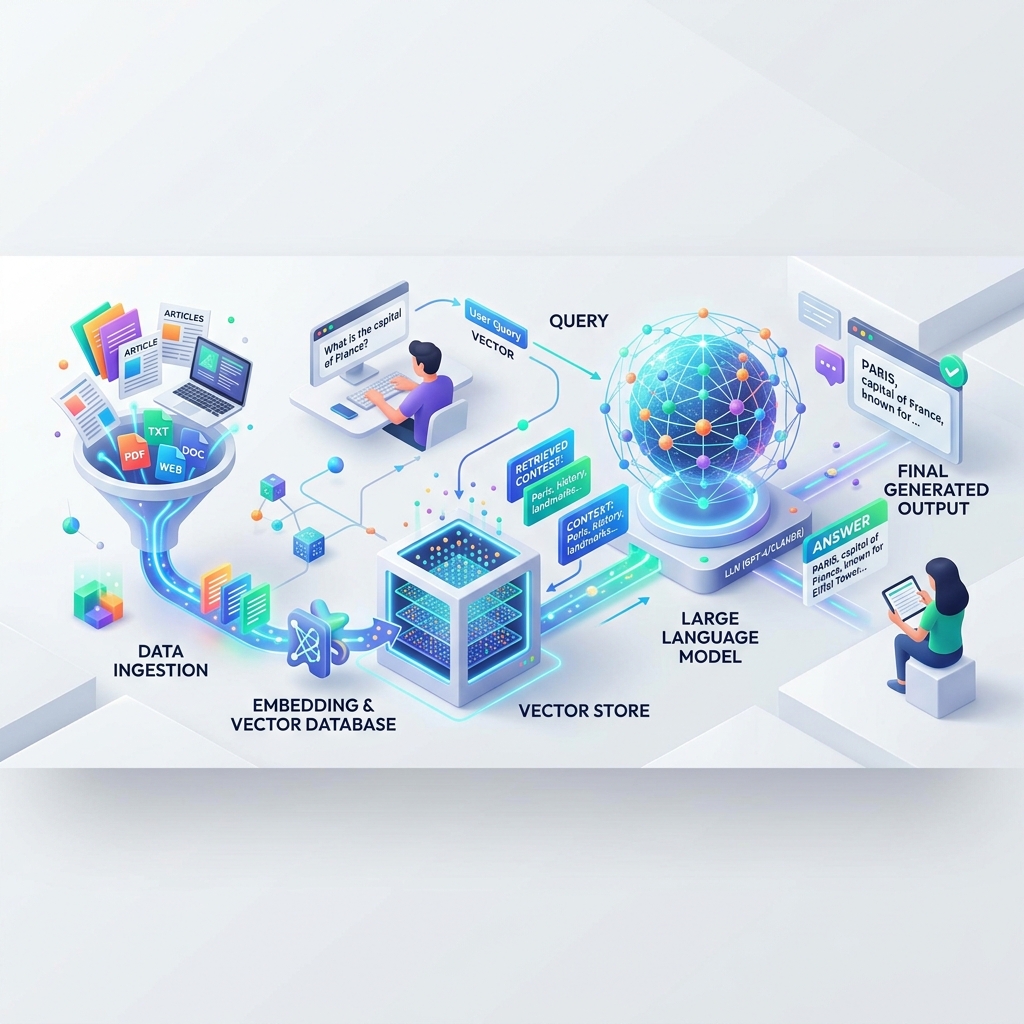
像 GPT-4 或 Gemini 这样的大语言模型(LLM)功能异常强大,但它们也存在一些关键弱点:它们会产生幻觉、无法获知训练截止日期之后的信息,并且无法访问您的私有域数据。 为了解决这些局限性,开发人员引入了检索增强生成(Retrieval-Augmented Generation,简称 RAG)。RAG 是一种通过从外部数据库中检索相关信息,并将其提供给大语言模型来生成准确且富含上下文信息的应答的框架。 这篇全面指南将带您深入理解 RAG 模型、其工作原理,以及为什么它对企业级人工智能至关重要。 1. 什么是检索增强生成 (RAG)? 从核心来看,RAG 结合了两个独立的过程: 检索 (Retrieval):根据用户查询,从知识库中寻找相关的文档或文本块。 生成 (Generation):将检索到的文档连同用户查询一起输入到大语言模型中,以便其生成准确的回答。 这就像是一场开卷考试。模型不再仅仅依靠在训练期间记住的内容(闭卷考试),而是被允许在回答之前查找参考书(知识库)。 2. 步步拆解 RAG 工作流 标准的 RAG 流水线主要包含三个阶段:数据准备(Ingestion)、检索(Retrieval)和生成(Generation)。 阶段 1:数据准备 (Ingestion) 在系统能够检索信息之前,必须对原始数据进行处理: 数据加载:收集文档(PDF、Markdown、网页等)。 文本分块 (Chunking):将大文件切分成更小、更易管理的文本块(例如 500 个字符)。 向量化 (Embedding):利用嵌入模型将这些文本块转换为紧密的数学向量,以代表它们的语义特征。 数据存储:将这些向量表示形式存储在专用的向量数据库中(如 Milvus、Pinecone 或 Qdrant)。 阶段 2:检索 (Retrieval) 当用户提出问题时: 使用相同的嵌入模型将用户的查询转换为向量。 系统在向量数据库中进行向量相似度搜索(如余弦相似度),以找到与查询最相关的文本块。 提取出匹配度最高的文本块。 阶段 3:生成 (Generation) 将检索到的文本块与用户原始的查询合并到一个详细的提示词模板中。 将此提示词发送给大语言模型。 大语言模型读取上下文,提取相关事实,并基于提供的文档生成自然语言回答。 3. 向量嵌入 (Embeddings) 是如何生成的 向量嵌入是 RAG 的数学基石。它们将人类语言转换为捕获语义信息的密集数值向量。
人工智能 RAG 模型 大语言模型 向量数据库 机器学习
揭秘序列到序列(Seq2Seq)架构与注意力(Attention)机制

揭秘序列到序列(Seq2Seq)架构与注意力(Attention)机制

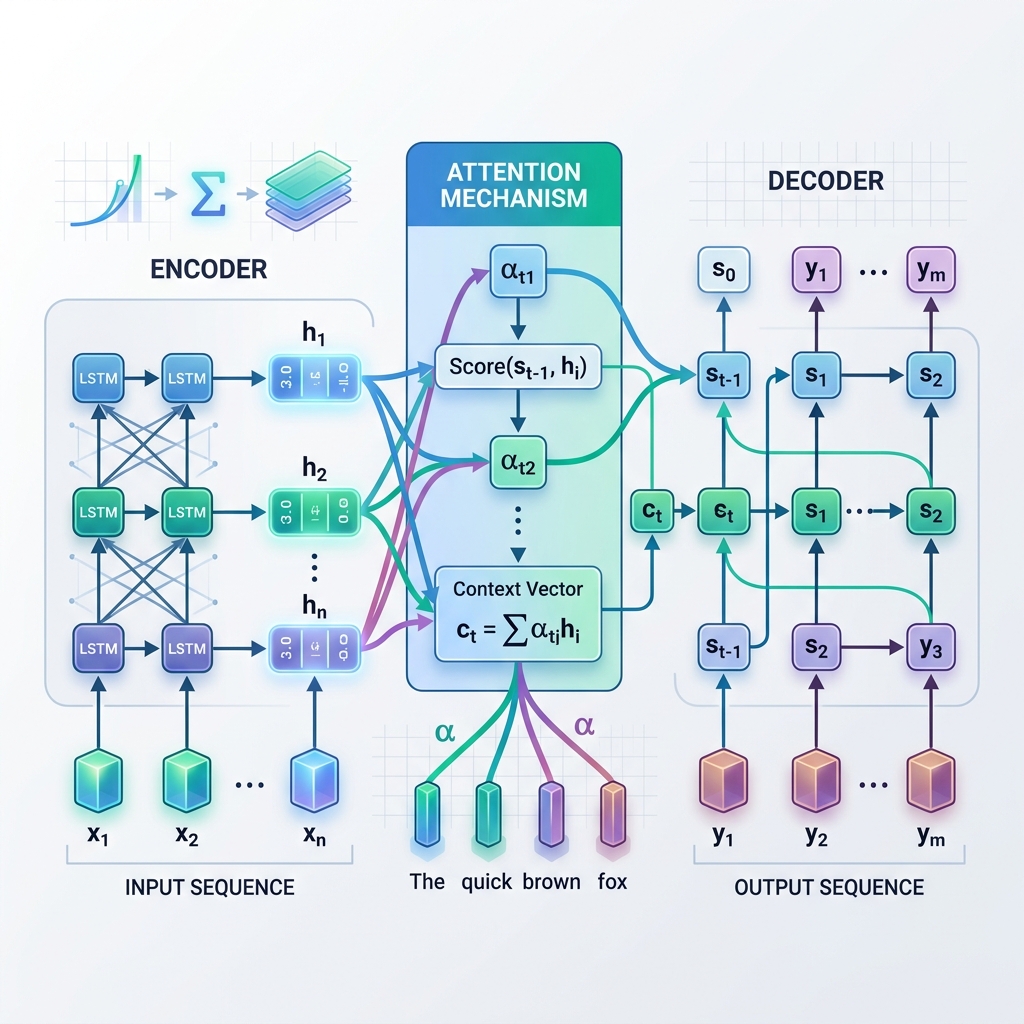
在自然语言处理(NLP)和人工智能领域,机器翻译、文本摘要以及对话生成等技术在过去几年中经历了一场革命。这场变革的核心正是序列到序列(Seq2Seq)架构以及开创性的注意力(Attention)机制。 在现代 Transformer 架构诞生之前,这两大创新解决了深度学习领域最棘手的挑战之一:在输入序列和输出序列长度不同时,如何建立它们之间的映射。 1. 理论奠基:什么是序列到序列(Seq2Seq)? 序列到序列(Seq2Seq)模型由谷歌等机构的研究人员于 2014 年提出,它是一种专门用于处理序列数据的编码器-解码器(Encoder-Decoder)框架。它被广泛应用于输入序列长度与输出序列长度不一致的任务中,例如: 机器翻译: 将英文的 “How are you?"(3个单词)翻译为中文的“你好吗?”(3个汉字)或西班牙语的 “¿Cómo estás?"(2个单词)。 文本摘要: 将一篇 500 字的文章压缩为 50 字的摘要。 问答系统: 将问题序列映射到相应的回答序列。 编码器-解码器机制 标准的 Seq2Seq 模型由两个循环神经网络(RNN)组成,通常采用 LSTM(长短期记忆网络)或 GRU(门控循环单元): 编码器(Encoder): 逐个 Token(词元)地处理输入序列。在每一步中,它会根据当前输入的 Token 和上一步的隐藏状态来更新隐藏状态。处理完整个输入后,编码器会提取最后一个隐藏状态。这个最终的隐藏状态被称为上下文向量(Context Vector)(或瓶颈向量)。 解码器(Decoder): 将上下文向量作为其初始隐藏状态,并以自回归的方式逐个 Token 地生成输出序列。在每一步中,它都会根据当前的隐藏状态和前一步生成的单词来预测下一个单词。 2. 瓶颈问题(Bottleneck Problem) 虽然经典的编码器-解码器模型是一项巨大的技术突破,但它存在一个致命的局限性,即信息瓶颈(Information Bottleneck)。 在标准的 Seq2Seq 模型中,编码器被迫将输入句子的完整语义——无论它是 5 个词还是 100 个词——全部压缩进一个固定大小的上下文向量中。 这导致了以下问题: 长期记忆丢失(Long-Term Memory Loss): 对于长句子,当编码器处理到序列末尾时,序列开头的语义信息已经被稀释或遗忘。 性能严重衰退: 随着输入句子长度的增加,翻译或摘要的质量会显著下降。 将复杂的长篇大论压缩进单一向量,就如同在翻译整章书之前,尝试用一句话来概括它一样。信息在这一压缩过程中不可避免地会丢失。
Seq2Seq 注意力机制 深度学习 自然语言处理 人工智能
人工智能与区块链:安全智能系统的未来

人工智能与区块链:安全智能系统的未来

在 2026 年的技术版图中,两股巨大的力量正在开始融合:人工智能 (AI) 和 区块链。人工智能为智能自动化提供“大脑”,而区块链则为去中心化的信任和安全提供“脊梁”。两者结合,正在创造新一代的安全智能系统,并在各行各业引发变革。 以下是人工智能与区块链的协同效应如何塑造未来的。 1. 去中心化智能:DeAI 的崛起 历史上,人工智能模型一直由中心化的科技巨头控制。去中心化人工智能 (DeAI) 通过在分布式账本上托管和训练模型改变了这一现状。这防止了单点故障,减少了审查,并确保智能带来的利益不会集中在少数人手中。 2. 为人工智能训练提供安全数据 人工智能的优劣取决于训练它的数据。区块链提供了一种安全、防篡改的方式来存储和共享数据集。在 2026 年,企业利用区块链来验证训练数据的来源,确保人工智能模型建立在高质量、真实的信息之上,同时通过加密技术保护个人数据贡献者的隐私。 3. 人工智能驱动的智能合约 智能合约是自动执行的协议,其条款直接写入代码中。通过集成人工智能,这些合约超越了简单的“如果-那么”逻辑。它们现在可以摄取现实世界的数据并做出预测性决策。例如,保险智能合约可以根据人工智能对气候相关风险的实时评估自动调整赔付。 4. 可审计的人工智能决策 人工智能面临的最大挑战之一是“黑箱”问题——即不知道人工智能是如何得出特定结论的。通过将人工智能的决策过程记录在区块链上,组织可以创建不可篡改的审计追踪。这种透明度对于金融和医疗等受监管行业至关重要,因为问责制在这些行业至关重要。 5. 自主代理与 DAO 这些技术的融合催生了生存于区块链上的自主代理 (Autonomous Agents)。这些代理可以在去中心化自治组织 (DAO) 中管理资金、交易资产并执行复杂的业务策略。在 2026 年,我们看到了完全由人工智能驱动的代码运行的组织。 6. 提高区块链效率 人工智能还被用于改进区块链本身。先进的机器学习算法可以优化挖矿过程,改进共识机制,并能在毫秒内检测账本上的欺诈交易。这使得区块链网络比以往任何时候都更快、更具扩展性且更安全。 7. 结语:协同效应的未来 人工智能与区块链的结合代表了我们构建数字基础设施方式的根本性转变。通过将人工智能的处理能力与区块链的去信任安全相结合,我们正在进入一个安全智能的时代。这种融合将成为下一代互联网的基石。 在 Ghaznix 博客了解最新技术动态 →
人工智能 区块链 去中心化 AI 智能合约 Web3 2026 技术趋势
计算机视觉的工作原理:从像素到现实世界的智能

计算机视觉的工作原理:从像素到现实世界的智能

在 2026 年的数字时代,计算机视觉 (CV) 已成为人工智能最具变革性的分支之一。它是一门让计算机能够像人类一样(甚至比人类更好)“看到”并理解视觉世界的科学。从智能手机上的面部识别到配送包裹的自主无人机,计算机视觉无处不在。 但是,机器究竟是如何将一堆数字网格转化为可识别的物体的呢? 1. 基础:什么是数字图像? 对于计算机来说,图像不是一幅画,而是一个巨大的数字网格,称为像素 (Pixels)。每个像素代表一个颜色值。在标准的 RGB 图像中,每个点由三个数字(红、绿、蓝)定义。 计算机视觉就是利用复杂的算法在这些数字中寻找规律的过程。 2. 计算机视觉处理流程 在机器能够识别猫或停止标志之前,数据会经过几个关键阶段: 图像获取: 通过摄像头、LiDAR(激光雷达)或热传感器捕捉视觉数据。 预处理: 清理数据——调整亮度、消除噪点或统一图像尺寸,以确保数据集的一致性。 特征提取: 识别重要部分。算法会寻找定义形状的边缘、角点和纹理。在 2026 年,这主要由深度神经层自动处理。 分类/检测: 最后一步,AI 根据提取的特征决定它正在看什么。 3. 卷积神经网络 (CNN) 的魔力 计算机视觉真正的突破源于深度学习,特别是卷积神经网络 (CNN)。 CNN 模仿人类的视觉皮层。它们通过多个层扫描图像,利用一种称为卷积的过程,即一个小过滤器在像素上移动以提取空间特征。 低层: 检测简单的图案,如水平或垂直线。 中层: 将线条组合成圆形或矩形等形状。 高层: 识别复杂的结构,如眼睛、轮子或叶子。 当数据到达最后一层时,网络可以以惊人的准确度区分成千上万个不同的类别。 4. 检测 vs. 分割:了解“在哪”和“是什么” 现代计算机视觉不仅仅是命名物体,它还会对其进行映射。 目标检测 (Object Detection): 在物体周围画一个“边界框”(例如:“在这些坐标处有一辆车”)。 语义分割 (Semantic Segmentation): 为图像中的每个像素打上标签(例如:“这 5000 个像素是道路的一部分,这 200 个像素是行人的一部分”)。 实例分割 (Instance Segmentation): 区分同一类型的多个物体(例如:“这是汽车 A,那是汽车 B”)。 5. 现实世界中的计算机视觉 (2026) 到 2026 年,计算机视觉不再是实验性的,而是必不可少的:
计算机视觉 人工智能 机器学习 深度学习 图像识别 2026 技术趋势
人工智能与现代软件开发:一场伟大的变革

人工智能与现代软件开发:一场伟大的变革

软件开发领域正经历着一场巨变。编码完全依靠手动、一行行敲出来的日子已经一去不复返了。今天,人工智能不仅仅是一个工具,它更是一个合作伙伴,正在重新定义我们构思、构建和维护软件的方式。 在这篇文章中,我们将探讨人工智能如何改变现代软件开发生命周期,以及它对未来的开发者意味着什么。 1. 人工智能编程助手的兴起 诸如 GitHub Copilot、Cursor 和 Tabnine 等工具已经从简单的自动补全插件演变为强大的结对编程伙伴。这些助手可以: 生成模板代码: 瞬间创建重复的代码结构,节省大量手动劳动时间。 重构代码: 为编写现有逻辑提供更高效或更具可读性的建议。 解释复杂片段: 帮助开发者理解遗留代码库或不熟悉的库。 通过减少语法和重复性任务带来的“认知负荷”,人工智能让工程师能够专注于高层架构和解决问题。 2. 自动化测试与调试 开发中最耗时的部分之一就是寻找和修复 Bug。人工智能正在通过以下方式彻底改变这一领域: 预测性调试: 在代码运行之前就识别出潜在的漏洞或逻辑错误。 自动化测试生成: 根据函数意图创建全面的单元测试和边缘情况场景。 自我修复代码: 一些先进的系统现在可以自动为失败的 CI/CD 流水线建议(甚至应用)修复方案。 3. 人工智能驱动的 DevOps 与 CI/CD 除了 IDE 之外,人工智能还在基础设施层面留下了印记。现代 DevOps 团队正在使用人工智能进行: 功能 影响 日志分析 比任何人类都更快地检测服务器日志中的异常。 资源优化 根据预测的流量模式动态调整云计算资源。 安全扫描 识别依赖项和基础设施即代码 (IaC) 模板中的安全缺陷。 4. 软件工程师角色的转变 随着人工智能接管了更多的“编写”工作,软件工程师的角色正演变为解决方案架构师或人工智能编排者。 未来的关键技能包括: 系统设计: 理解不同组件如何在大规模下协同工作。 提示词工程: 学习如何有效地向人工智能模型传达需求。 代码审查与验证: 确保人工智能生成的代码符合安全、性能和道德标准。 结论:拥抱人工智能增强的未来 人工智能并不是为了取代开发者,而是为了赋能开发者。通过自动化平凡的任务并增强我们的解决问题能力,人工智能正使软件开发变得比以往任何时候都更快、更易于访问且更具创造力。
人工智能 软件开发 编程 大语言模型 GitHub Copilot Cursor DevOps
联邦学习:如何在不共享数据的情况下训练 AI

联邦学习:如何在不共享数据的情况下训练 AI

在传统的机器学习流程中,数据收集是第一步,也是通常最昂贵的一步。为了训练模型,您必须收集原始的用户数据(如照片、短信、健康记录或财务交易),并将它们上传到中央云服务器。 尽管这种集中式方法推动了 AI 革命,但它面临着重大挑战: 隐私顾虑: 用户越来越不愿意将私人数据上传到第三方服务器。 数据监管: GDPR 和 HIPAA 等法规严格限制了个人数据的传输和存储方式。 带宽成本: 从数百万个边缘设备(如智能手机)上传千兆字节的原始数据是非常低效的。 **联邦学习(Federated Learning - FL)**通过颠覆传统模式解决了这些问题。它不是将数据带给模型,而是将模型带给数据。 核心概念:去中心化训练 在联邦学习中,中央服务器维护一个全局模型。服务器不是收集原始数据来训练该模型,而是在边缘设备(客户端)网络(例如智能手机、智能家居设备或区域医院数据库)中协调协作训练过程。 这是联邦学习的基本规则: 原始数据绝不离开本地设备。只共享数学模型更新。 步骤详解:它是如何工作的 一个典型的联邦学习训练周期(称为通信轮次)由五个主要步骤组成: sequenceDiagram participant Server as 中央服务器 (全局模型) participant ClientA as 客户端 A (私人数据 A) participant ClientB as 客户端 B (私人数据 B) rect rgb(240, 248, 255) Note over Server: 步骤 1: 初始化全局模型 end Server->>ClientA: 步骤 2: 发送全局权重 (W_t) Server->>ClientB: 步骤 2: 发送全局权重 (W_t) rect rgb(245, 245, 245) Note over ClientA: 步骤 3: 在本地私有数据上进行训练 Note over ClientB: 步骤 3: 在本地私有数据上进行训练 end ClientA->>Server: 步骤 4: 发送本地更新 (W_t^A) ClientB->>Server: 步骤 4: 发送本地更新 (W_t^B) rect rgb(240, 255, 240) Note over Server: 步骤 5: 更新求均值 (FedAvg)<br/>更新全局模型 (W_t+1) end 1. 初始化 中央服务器使用初始权重($W_0$)初始化全局模型。这些权重可以是随机的,也可以是在公共数据集上预先训练的。
机器学习 隐私保护 人工智能 分布式计算 数据安全