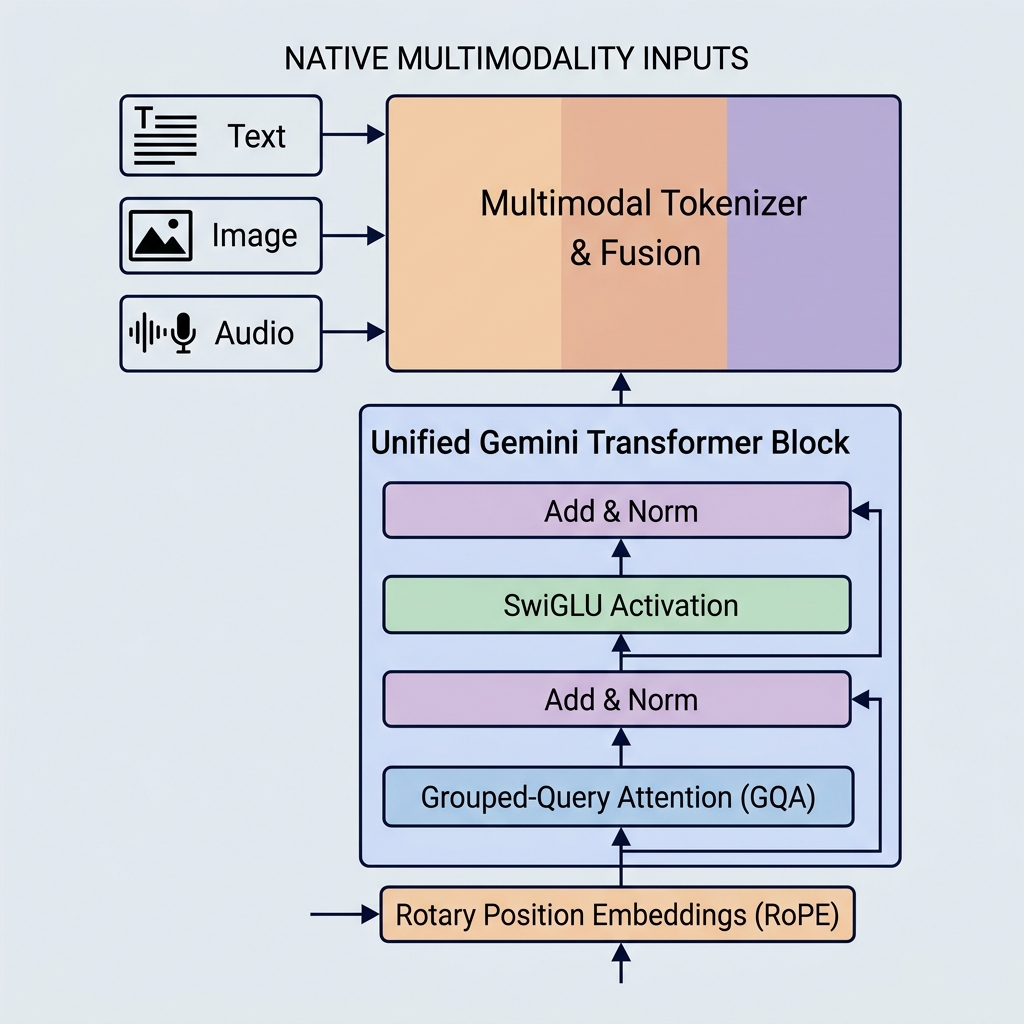
Geminiトランスフォーマーモデルの仕組み:GQA、SwiGLU、およびネイティブマルチモダリティ
GoogleのGeminiモデルは、ネイティブマルチモダリティ、大規模なコンテキストウィンドウ、および主要なアーキテクチャの最適化を導入することにより、AI機能の新しいベンチマークを設定しました。GPT-3やBERTなどの古いモデルとは異なり、Geminiは初日から複数のタイプのデータを処理するように構築されており、非常に効率的なアテンションメカニズムを利用しています。
この記事では、Geminiトランスフォーマーモデルの主要なアーキテクチャの選択を分解し、それらが従来のアーキテクチャとどのように比較されるかを探索し、PyTorchでグループ化クエリ注意(GQA)およびSwiGLUフィードフォワードネットワークを実装します。
1. ネイティブマルチモダリティ(統一された埋め込み空間) 従来のAIシステムは、個別のモデルをつなぎ合わせることでマルチモーダルな動作を実現しています。たとえば、マッピングレイヤーやアダプターを使用して、画像エンコーダー(CLIPなど)やオーディオプロセッサー(Whisperなど)を事前トレーニング済みのテキストモデルとペアリングします。
Geminiは異なって構築されています。ネイティブにマルチモーダルであり、最初から異なるモダリティ(テキスト, コード, 画像, 音声, ビデオ)で同時にトレーニングされたことを意味します。
統一されたトークナイザー: 個別の前処理パイプラインの代わりに、異なる入力が共有の統一された潜在埋め込み空間のトークンに変換されます。 クロスモーダルな推論: 表現空間が共有されているため、単一のデコーダーブロックは、まったく同じシーケンス内の視覚トークン、音声トークン、およびテキストトークンに注意を向けることができます。これにより、Geminiはビデオフレームの説明や音声のテキストへの直接翻訳などの複雑なタスクを実行できます。 2. グループ化クエリ注意(Grouped-Query Attention, GQA) コンテキストウィンドウが拡張する(数百万トークンに達する)につれて、キー値(KV)キャッシュのメモリフットプリントが主要なサービングのボトルネックになります。
これを解決するために:
マルチヘッドアテンション(MHA): すべてのクエリヘッド(Query head, $Q$)に、一致するキー(Key, $K$)および値(Value, $V$)ヘッドがあります。32個のヘッドがある場合、32セットのKVベクトルを保存する必要があります。 マルチクエリアテンション(MQA): すべてのクエリヘッドが単一のキーおよび値ヘッドを共有します。これによりメモリは節約されますが、モデルの容量と出力の品質が低下します。 グループ化クエリ注意(GQA): クエリヘッドがグループ化されます(たとえば、4ヘッドの8グループ)。各グループは単一のキーおよび値ヘッドを共有します。 $$\text{Scores} = QK^T \text{ computation in GQA groups Q heads to share a single KV pair}$$
GQAは中間層として機能し、MHA의 거의 모든 품질을 회복하면서도 MQAに近い推論速度とメモリ節約を提供します。
3. SwiGLU活性化関数 BERTや古いGPTモデルで使用されている標準のGeLU活性化の代わりに、GeminiはフィードフォワードブロックでSwiGLU(Swish-Gated Linear Unit)を利用しています。
ゲート付き線形ユニット(GLU)は、2つの線形変換の要素ごとの積として定義されるニューラルネットワーク層であり、その一方はシグモイド活性化によってゲートされます。SwiGLUは、シグモイドをSwish(またはSiLU)活性化に置き換えます。
$$\text{SwiGLU}(x) = \text{Swish}_\beta(x W) \otimes (x V)$$
Gemini
Transformers
GQA
SwiGLU
Multimodality
Deep Learning