🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

GPT

生成 AI の説明: 機械はどのように創造することを学ぶのか

生成 AI の説明: 機械はどのように創造することを学ぶのか

生成 AI は、21 世紀で最も革新的な技術変化の 1 つです。分類、予測、検出を行う従来の AI システムとは異なり、Generative AI はテキスト、画像、オーディオ、ビデオ、コード、さらには 3 次元構造を作成します。これは、ChatGPT による記事の作成、Midjourney によるフォトリアリスティックなアートの描画、およびコメントからすべての機能を完了する GitHub Copilot の背後にあるテクノロジーです。 このガイドでは、Generative AI とは何か、Generative AI が内部でどのように機能するか、Generative AI を支える主要なモデル アーキテクチャ、および Generative AI がどこに向かっているのかについて説明します。 1. ジェネレーティブ AI とは何ですか? 生成 AI は、トレーニング データの統計的分布を学習し、その同じ分布に従う新しいコンテンツを生成する人工知能モデルのクラスを指します。 より簡単に言うと、人間の顔の何百万枚もの写真でモデルをトレーニングすると、モデルは顔の見た目のパターン (目の位置、鼻の形、肌の質感) を学習し、これまでに存在したことのないまったく新しい顔を生成できます。 識別モデルと生成モデルの主な違い: 識別AI 生成AI クラス間の境界を学習します 完全なデータ分布を学習します 入力 → ラベル / カテゴリ 入力プロンプト → 新しいコンテンツ (テキスト、画像、音声) 例: 画像分類器、スパムフィルター 例: GPT-4、安定拡散、ジェミニ 答え:「これは猫ですか?」 → はい/いいえ 答え: 「宇宙服を着た猫の絵を生成する」 2. 生成 AI の背後にあるコア アーキテクチャ 最新の生成 AI は単一のテクノロジーではなく、それぞれが異なるドメインに適した異なるアーキテクチャのファミリーです。
AI Generative AI LLMs Deep Learning Machine Learning GPT Diffusion Models
GPT トランスフォーマーの仕組み:因果自己注意機構(Causal Self-Attention)の解説

GPT トランスフォーマーの仕組み:因果自己注意機構(Causal Self-Attention)の解説

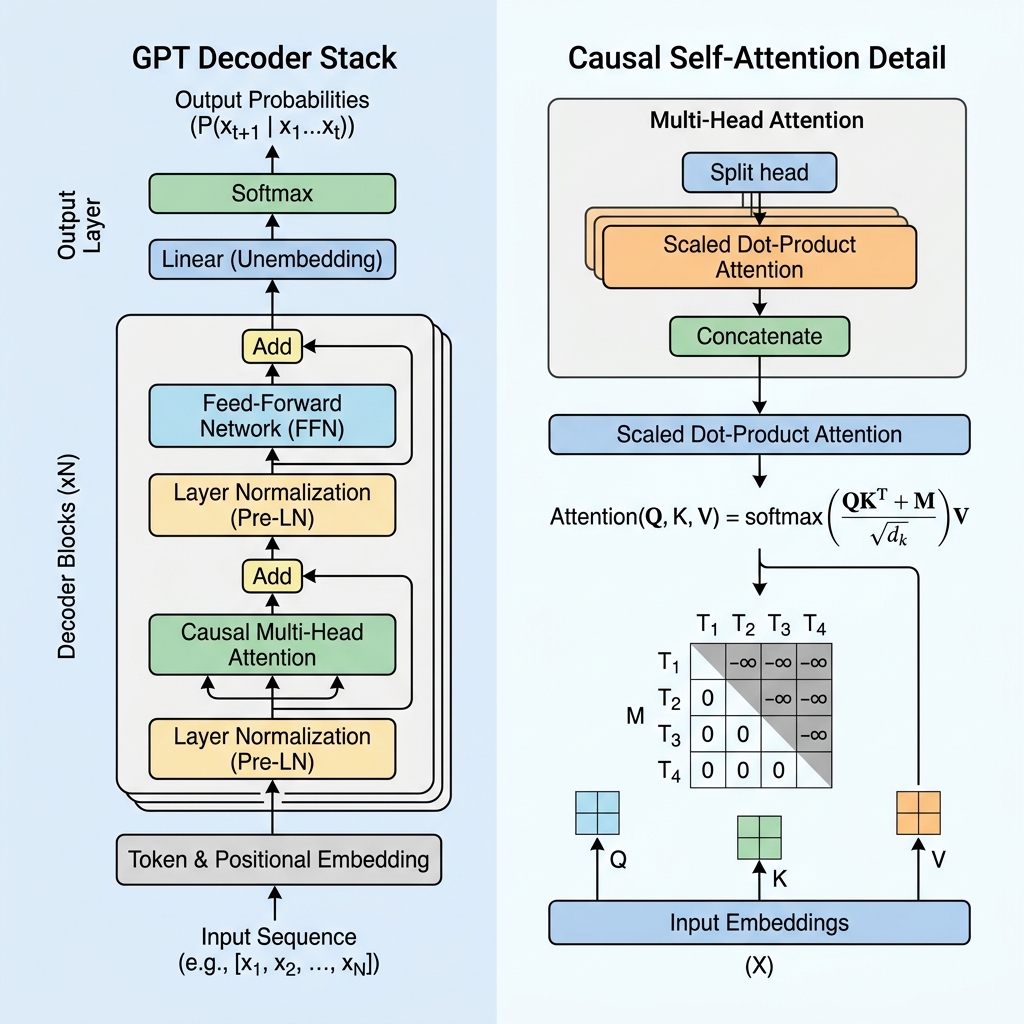
GPT トランスフォーマーの仕組み:因果自己注意機構(Causal Self-Attention)の解説 近年、Generative Pre-trained Transformers(GPT)は人工知能に革命をもたらしました。コーディングアシスタントから対話型エージェントに至るまで、GPTベースのモデルは今日の最も先進的な生成アプリケーションを支えています。しかし、このテクノロジーは実際にどのように機能しているのでしょうか? 双方向に理解するのに対し、GPTは自己回帰的(autoregressive)な次のトークン予測のために設計された**デコーダー専用(Decoder-only)**のアーキテクチャです。このブログでは、GPTトランスフォーマーの仕組みを解き明かし、因果自己注意機構(causal self-attention)を深く掘り下げ、コードで実装します。 1. 自己回帰的な生成ループ 本質的に、GPTは自己回帰モデルです。これは、テキストのシーケンスを生成するために、すでに生成されたトークンを次の予測のコンテキストとして使用しながら、次のトークンを1つずつ予測することを意味します。 ワークフローは以下の手順に従います。 入力 (Input): モデルはプロンプトを受け取ります。例:"Deep learning is"。 予測 (Prediction): モデルはこのプロンプトを処理し、語彙全体に対する確率分布を出力します。次のトークンをサンプリングします。例:"awesome"。 ループ (Loop): 新しいトークンが入力に追加され、"Deep learning is awesome"になります。このシーケンスが次のステップの入力になります。 終了 (Termination): モデルが特殊なシーケンス終了([EOS])トークンを出力するか、定義された長さ制限に達するまで、プロセスが繰り返されます。 2. 因果マスキング:デコーダーの核心 BERTのようなエンコーダー専用モデルでは、すべてのトークンが過去と未来の両方を見渡して、他のすべてのトークンに注意を向けることができます。しかし、次のトークンを予測する生成モデルにとって、トレーニング中に未来を見ることは「カンニング」になります。 モデルが未来のトークンを見るのを防ぐために、GPTは因果自己注意(Causal Self-Attention)(またはマスクされた自己注意)を使用します。 因果マスク行列 自己注意の計算中、クエリ(Queries, $Q$)とキー(Keys, $K$)の点積を取ることで、トークン間の類似度スコアを計算します。 $$\text{Scores} = QK^T$$ 因果性を強制するために、対角線より上のすべての値が $-\infty$(負の無限大)に設定され、対角線上およびそれ以下の値が 0 であるマスク行列 $M$ を適用します。softmax関数を適用する前に、このマスクをスコアに加算します。 $$\text{Masked Scores} = \frac{QK^T}{\sqrt{d_k}} + M$$ $$M = \begin{pmatrix} 0 & -\infty & -\infty & \dots & -\infty \\ 0 & 0 & -\infty & \dots & -\infty \\ 0 & 0 & 0 & \dots & -\infty \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & 0 & \dots & 0 \end{pmatrix}$$
GPT トランスフォーマー 生成AI 因果自己注意 自然言語処理