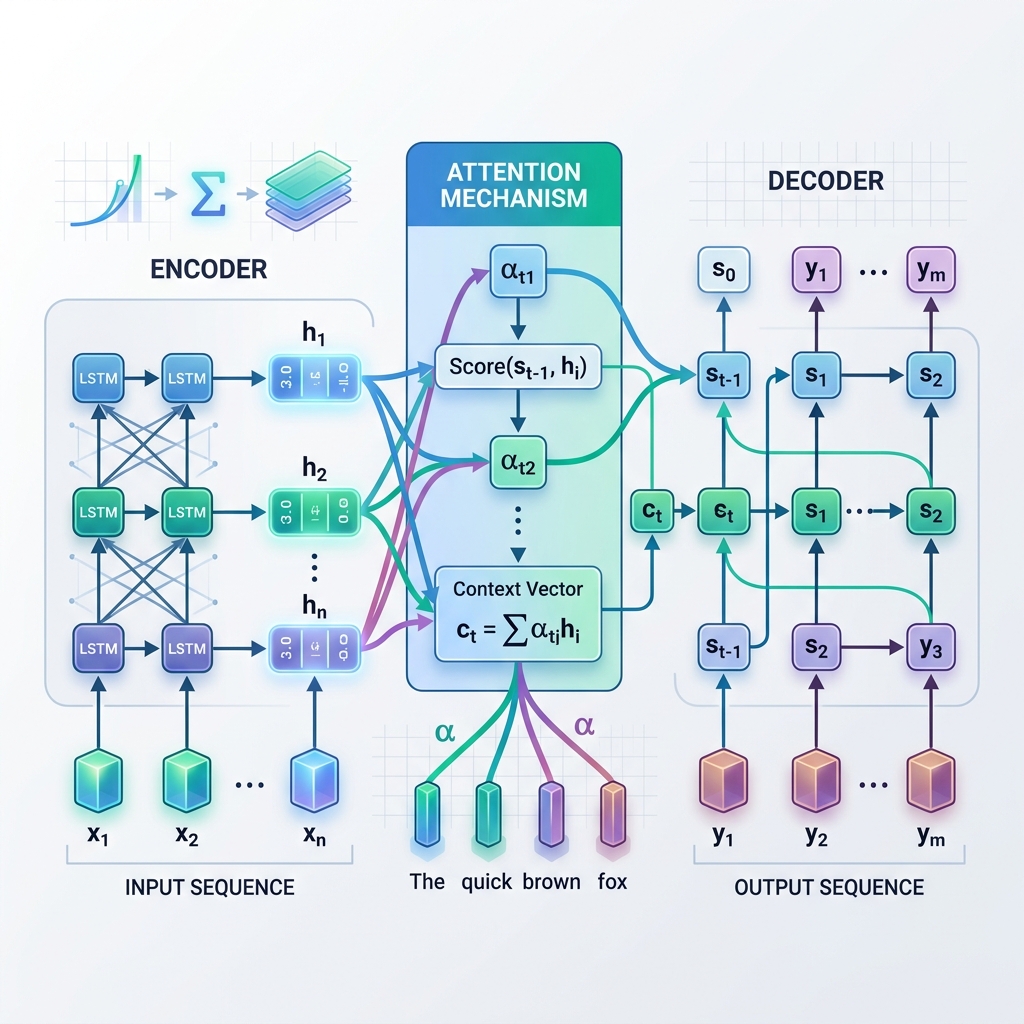
Sequence-to-Sequence(Seq2Seq)アーキテクチャとアテンションメカニズムの仕組み
自然言語処理(NLP)および人工知能(AI)の領域において、言語の翻訳、文章の要約、対話の生成を行う能力は劇的な革命を遂げました。この変革の中心に位置するのが、**Sequence-to-Sequence(Seq2Seq)アーキテクチャと、先駆的なアテンションメカニズム(Attention Mechanism)**です。
現代の Transformer が登場する前、これら2つのイノベーションは、入力配列と出力配列の長さが異なる場合にそれらをマッピングするという、ディープラーニングにおける最大の課題の1つを解決しました。
1. 基礎:Sequence-to-Sequence(Seq2Seq)とは何か? 2014年にGoogleなどの研究者によって発表されたSequence-to-Sequence(Seq2Seq)モデルは、時系列データを処理するために設計されたエンコーダー・デコーダー(Encoder-Decoder)フレームワークです。入力配列の長さと出力配列の長さが一致しない以下のようなタスクで広く使用されています:
機械翻訳: 英語の “How are you?"(3単語)を日本語の「お元気ですか?」(6文字)やスペイン語の “¿Cómo estás?"(2単語)に翻訳する。 テキスト要約: 500単語の論文を50単語の要約に圧縮する。 質問応答: 質問の配列を回答の配列にマッピングする。 エンコーダー・デコーダーの仕組み 標準的なSeq2Seqモデルは、一般的にLSTM(Long Short-Term Memory)またはGRU(Gated Recurrent Units)と呼ばれる2つの再帰型ニューラルネットワーク(RNN)で構成されています:
エンコーダー(Encoder): 入力配列をトークンごとに順次処理します。各ステップで、現在の入力トークンと前の隠れ状態に基づいて、自身の隠れ状態(hidden state)を更新します。入力全体が処理されると、エンコーダーの最後の隠れ状態が取得されます。この最終状態は文脈ベクトル(Context Vector)(またはボトルネックベクトル)と呼ばれます。 デコーダー(Decoder): 文脈ベクトルを初期の隠れ状態として受け取り、出力配列を自帰的にトークンごとに生成します。各ステップで、現在の隠れ状態と以前に生成された単語に基づいて、次の単語を予測します。 2. ボトルネック問題(Information Bottleneck) クラシックなエンコーダー・デコーダーモデルは大きなブレイクスルーであったものの、情報ボトルネックとして知られる根本的な限界を抱えていました。
標準的なSeq2Seqモデルでは、エンコーダーは入力文全体の意味を(それが5単語であれ100単語であれ)、固定サイズの単一の文脈ベクトルに圧縮することを強制されます。
その結果:
長期記憶の喪失: 長い文章では、エンコーダーが終端に達する頃には、配列の初期部分の情報が失われてしまいます。 性能の低下: 入力文の長さが長くなるにつれて、翻訳や要約の品質が著しく低下します。 複雑な段落を単一のベクトルに圧縮することは、本の一章全体を翻訳する前に、一言の文章で要約しようとするようなものです。情報は必然的に失われます。
3. アテンションメカニズム:パラダイムシフト 情報ボトルネックを解決するため、Dzmitry Bahdanau(バダナウ)ら研究グループは2015年に**アテンションメカニズム(注意機構)**を導入しました。
エンコーダーの最終ステップから得られる単一の静的な文脈ベクトルのみに依存する代わりに、アテンションはデコーダーがデコードプロセスの各ステップでエンコーダーのすべての隠れ状態を**「振り返る」**ことを可能にします。これは、モデルが現在生成している単語に応じて、入力配列の異なる部分に動的に焦点を当てる(注意を向ける)ことを意味します。
アテンションの仕組み:ステップ・バイ・ステップ 各デコードステップ $t$ において:
アライメントスコアの計算 ($e_{t, j}$): デコーダーの現在の隠れ状態 $s_{t-1}$ と、エンコーダーの各隠れ状態 $h_j$ を比較し、エンコーダーの状態 $j$ がデコーダーの現在のステップにどれだけ関連しているかを測定します。 $$e_{t, j} = \text{score}(s_{t-1}, h_j)$$ アテンション重みの計算 ($\alpha_{t, j}$): アライメントスコアを softmax 関数を使用して正規化し、合計が1になる確率(重み)に変換します。 $$\alpha_{t, j} = \frac{\exp(e_{t, j})}{\sum_k \exp(e_{t, k})}$$ 動的文脈ベクトルの生成 ($c_t$): エンコーダーのすべての隠れ状態の加重平均として、文脈ベクトルを計算します。 $$c_t = \sum_j \alpha_{t, j} h_j$$ トークンの予測: デコーダーは動的文脈ベクトル $c_t$ と現在の状態 $s_t$ を組み合わせて、次の出力トークンを予測します。 4. Seq2Seqとアテンションメカニズムの詳細な解説 これらのメカニズムの背後にある技術を真に理解するために、まず古典的な Sequence-to-Sequence アーキテクチャの数学的および操作的なステップを辿り、続いて Bahdanau(加算)と Luong(乗算)の両方のアテンション手法について解説します。
Seq2Seq
アテンションメカニズム
ディープラーニング
自然言語処理
人工知能