GPT トランスフォーマーの仕組み:因果自己注意機構(Causal Self-Attention)の解説
GPT トランスフォーマーの仕組み:因果自己注意機構(Causal Self-Attention)の解説
近年、Generative Pre-trained Transformers(GPT)は人工知能に革命をもたらしました。コーディングアシスタントから対話型エージェントに至るまで、GPTベースのモデルは今日の最も先進的な生成アプリケーションを支えています。しかし、このテクノロジーは実際にどのように機能しているのでしょうか?
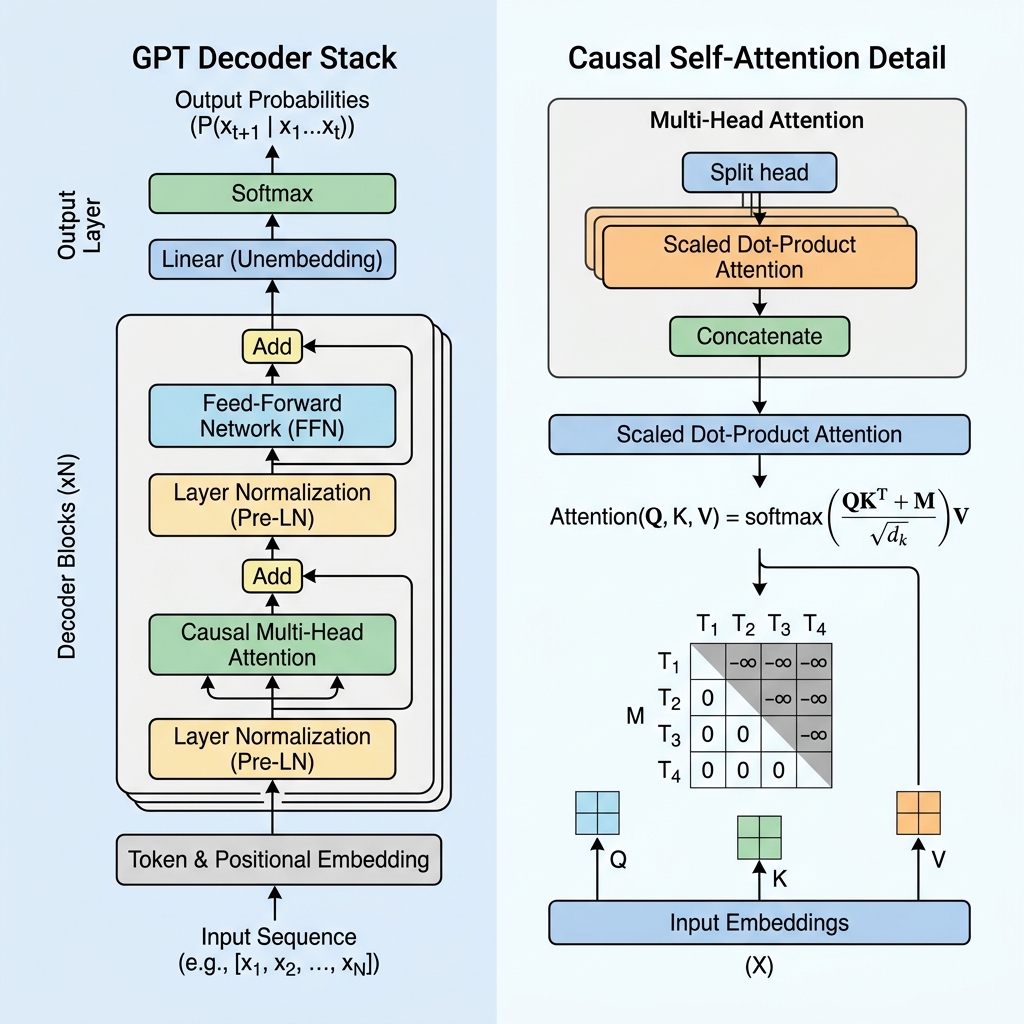
双方向に理解するのに対し、GPTは自己回帰的(autoregressive)な次のトークン予測のために設計された**デコーダー専用(Decoder-only)**のアーキテクチャです。このブログでは、GPTトランスフォーマーの仕組みを解き明かし、因果自己注意機構(causal self-attention)を深く掘り下げ、コードで実装します。
1. 自己回帰的な生成ループ 本質的に、GPTは自己回帰モデルです。これは、テキストのシーケンスを生成するために、すでに生成されたトークンを次の予測のコンテキストとして使用しながら、次のトークンを1つずつ予測することを意味します。
ワークフローは以下の手順に従います。
入力 (Input): モデルはプロンプトを受け取ります。例:"Deep learning is"。 予測 (Prediction): モデルはこのプロンプトを処理し、語彙全体に対する確率分布を出力します。次のトークンをサンプリングします。例:"awesome"。 ループ (Loop): 新しいトークンが入力に追加され、"Deep learning is awesome"になります。このシーケンスが次のステップの入力になります。 終了 (Termination): モデルが特殊なシーケンス終了([EOS])トークンを出力するか、定義された長さ制限に達するまで、プロセスが繰り返されます。 2. 因果マスキング:デコーダーの核心 BERTのようなエンコーダー専用モデルでは、すべてのトークンが過去と未来の両方を見渡して、他のすべてのトークンに注意を向けることができます。しかし、次のトークンを予測する生成モデルにとって、トレーニング中に未来を見ることは「カンニング」になります。
モデルが未来のトークンを見るのを防ぐために、GPTは因果自己注意(Causal Self-Attention)(またはマスクされた自己注意)を使用します。
因果マスク行列 自己注意の計算中、クエリ(Queries, $Q$)とキー(Keys, $K$)の点積を取ることで、トークン間の類似度スコアを計算します。
$$\text{Scores} = QK^T$$
因果性を強制するために、対角線より上のすべての値が $-\infty$(負の無限大)に設定され、対角線上およびそれ以下の値が 0 であるマスク行列 $M$ を適用します。softmax関数を適用する前に、このマスクをスコアに加算します。
$$\text{Masked Scores} = \frac{QK^T}{\sqrt{d_k}} + M$$
$$M = \begin{pmatrix} 0 & -\infty & -\infty & \dots & -\infty \\ 0 & 0 & -\infty & \dots & -\infty \\ 0 & 0 & 0 & \dots & -\infty \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & 0 & \dots & 0 \end{pmatrix}$$
GPT
トランスフォーマー
生成AI
因果自己注意
自然言語処理