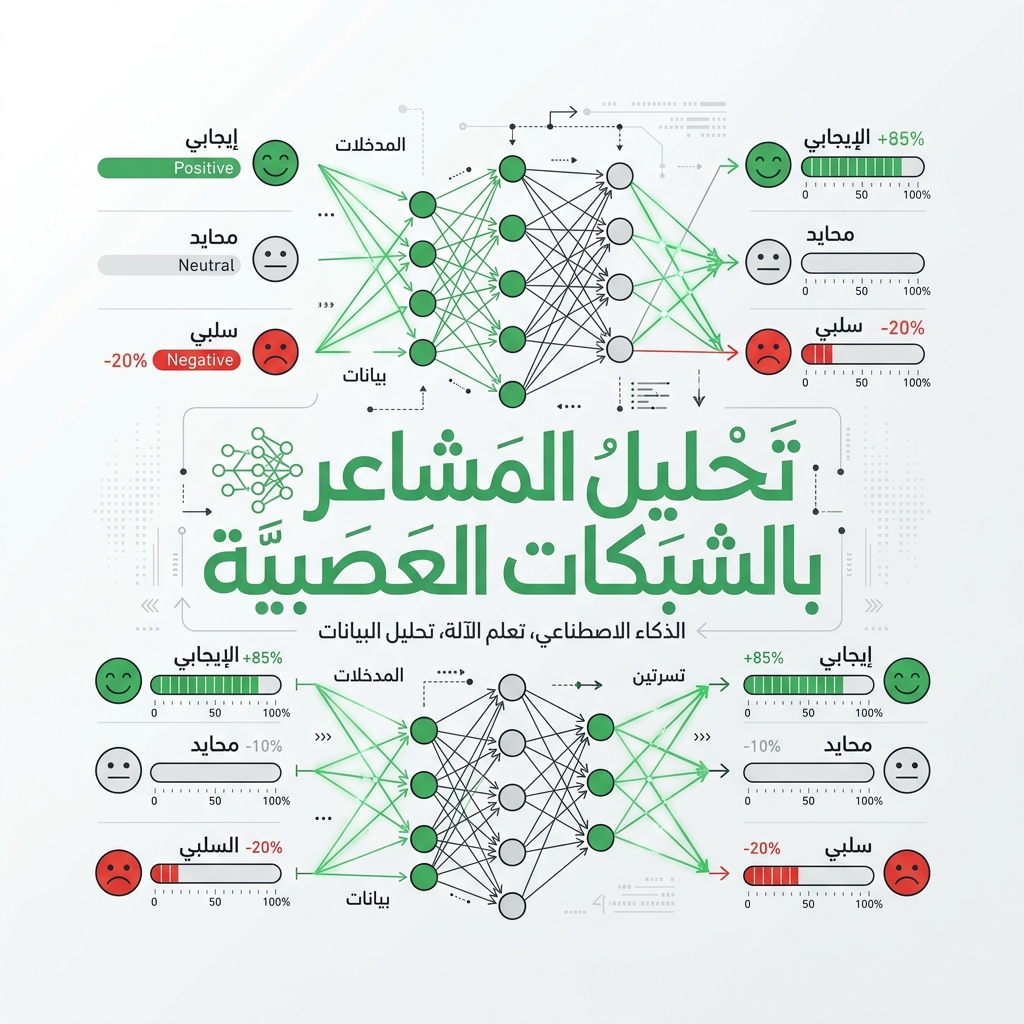
阿拉伯语情感分析:实用的 NLP 预处理和模型演练
在全球化数字通信时代,情感分析(识别文本背后情绪基调的任务)已成为企业、政府和研究人员的关键工具。虽然英语等语言的情感分析已经高度成熟,但将其应用于阿拉伯语则面临着一系列独特的语言和技术挑战。
阿拉伯语拥有超过 4 亿使用者,是世界上使用最广泛的语言之一。然而,其丰富的形态结构、双层语言现象(标准语与口语并存)以及复杂的书写系统需要专门的预处理和建模策略。
本指南提供了阿拉伯语情感分析的全面演练,详细介绍了挑战、预处理流程、经典的机器学习实现(TF-IDF + 逻辑回归)以及使用 Hugging Face Transformers 的现代深度学习方法。
1. 阿拉伯语 NLP 的语言挑战 在编写代码之前,开发人员必须了解为什么阿拉伯语不能使用标准的西方 NLP 流程进行处理:
双层语言现象 (Diglossia): 阿拉伯语分为现代标准阿拉伯语 (MSA)(用于正式写作、新闻和官方文档)和口语方言 (Darja/Ammiya)(用于社交媒体和日常交流)。方言(例如埃及、黎凡特、海湾方言)在词汇、语法和情感表达上存在显著差异。 丰富的形态学 (Rich Morphology): 阿拉伯语是一种模板化语言,单词是通过应用特定模式从三字母或四字母词根衍生而来的。单个单词可以包含表示代词、介词和时态的前缀、后缀和中缀(例如 وسيكتبونها - “他们将写下它”)。 拼写变化 (Orthographic Variations): 阿拉伯语字母的形状经常根据其在单词中的位置而变化,并且用户经常混用某些字母(例如 Alif 的变体 أ、إ、آ、ا,或 Yaa 变体 ي 与 ى)。 变音符号 (Tashkeel): 短元音以变音符号的形式写在字母的上方或下方(例如 Fat-hah、Dammah、Kasrah)。虽然它们可以明确含义,但在数字文本中通常被省略,从而导致歧义;或者添加不一致,导致数据稀疏。 2. 阿拉伯语 NLP 预处理流程 为了处理阿拉伯语文本,我们必须构建一个专门的预处理流程,处理文本规范化、去变音符、分词、词干提取和模型推理:
graph TD A[原始阿拉伯语文本] --> B[规范化与清洗] B --> C[去除变音符号与标点] C --> D[分词] D --> E[词干提取 / 词形还原] E --> F[特征向量化 / 词嵌入] F --> G[情感分类器] G --> H[输出结果:积极 / 消极 / 中性] 3. 步步详解:经典预处理与机器学习 (Python) 让我们使用 Python、NLTK 和 scikit-learn实现一个完整的流程。我们将编写自定义的规范化规则,并使用 NLTK 的 ISRIStemmer(专门为阿拉伯语设计的检索词干提取器)。
自然语言处理
NLP
情感分析
阿拉伯语人工智能
Transformers
Python
机器学习