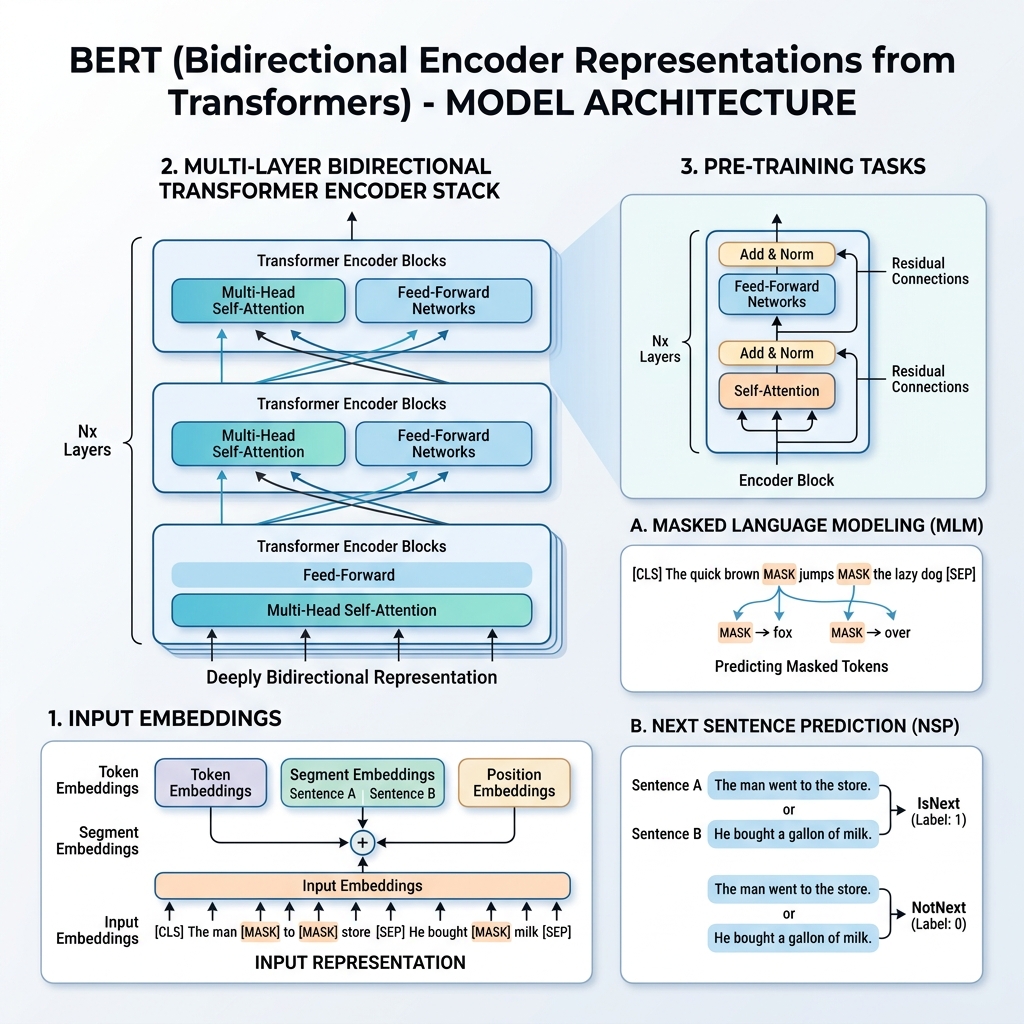
深入理解 BERT 模型:双向 Transformer 编码器表示
2018 年,Google 研究人员发表了一篇具有里程碑意义的论文,题为 “BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding”(Devlin 等人)。这项研究彻底改变了自然语言处理(NLP)领域。在 BERT 之前,模型大多是自左向右或自右向左单向处理文本。BERT 引入了一种方法,可以同时从两个方向来训练语言表示。
今天,BERT 及其衍生模型(如 RoBERTa、DistilBERT 和 ALBERT)仍然是搜索引擎、情感分析、问答系统和信息提取的基石。本文将带您揭开 BERT 架构的神秘面纱,解析其工作原理和训练方式。
1. 什么是 BERT? BERT 的全称是 Bidirectional Encoder Representations from Transformers(基于 Transformers 的双向编码器表示)。让我们拆解一下这个名字:
双向(Bidirectional): 与从左到右(如 GPT)或从右到左读取文本的传统语言模型不同,BERT 一次性读取整个单词序列。这使它能够根据某个单词的整个上下文(左右两侧)来学习该单词的语义。 编码器表示(Encoder Representations): BERT 使用了原始 Transformer 架构中的**编码器(Encoder)**部分。它接收输入序列,并为每个 token 输出一个密集的向量表示(嵌入/embedding)。 Transformers: 其底层引擎是 Transformer 注意力网络,它能够对长距离依赖关系进行建模并支持并行计算。 双向表示的强大之处 在单向模型中,一个 token 只能关注之前的 token。例如在句子中: “他决定把钱存进银行(bank)。”
BERT
Transformers
自然语言处理
深度学习
AI 架构