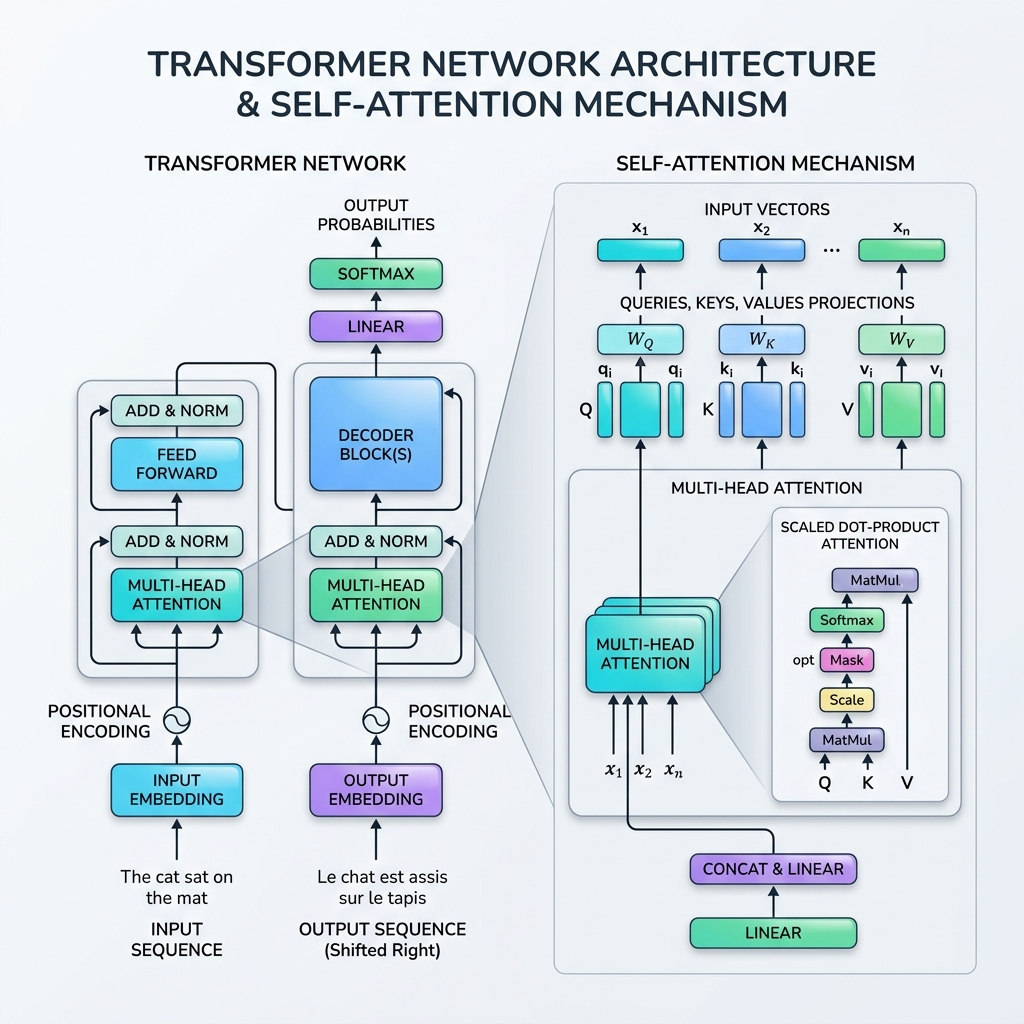
理解 Transformer 网络与自注意力(Self-Attention)机制
2017年,随着 Vaswani 等人发表了里程碑式的论文 《Attention Is All You Need》,人工智能领域发生了翻天覆地的变化。该论文引入了 Transformer,一种革命性的神经网络架构,它完全摒弃了循环结构(RNN、LSTM),转而使用**自注意力机制(Self-Attention Mechanism)**并行处理序列数据。
如今,Transformer 驱动着几乎所有最先进的大语言模型(LLM),包括 GPT-4、Gemini, Claude 和 Llama。本篇博客将揭开 Transformer 网络的神秘面纱,并从数学和实践的角度解析自注意力机制是如何实现的。
1. 串行处理的瓶颈(RNN 与 Transformer 的对比) 在 Transformer 出现之前,循环神经网络(RNN)和长短期记忆(LSTM)网络是序列建模的标准方法。然而,RNN 必须按顺序(一次处理一个词)处理 Token。为了计算第 10 个词的隐藏状态,模型必须先计算第 1 到第 9 个词的隐藏状态。
这种串行特性带来了两个严重的局限性:
无法并行化: 现代 GPU 的计算能力无法得到高效利用,因为每一步计算都必须等待上一步完成。 梯度消失/爆炸: 当模型处理到长序列的末尾时,序列开头的早期信息会被压缩并丢失(即瓶颈问题)。 Transformer 同时解决了这两个问题。通过用自注意力取代循环结构,Transformer 可以同时处理整个输入序列,实现了海量的并行化计算,并在序列中的任意两个 Token 之间建立直接联系,无论它们相距多远。
2. 什么是自注意力机制? 自注意力允许模型评估同一序列中不同词之间的关系。模型不再孤立地处理每个词,而是通过结合句子中所有其他词的上下文来表示当前词。
例如在以下句子中:
“The bank of the river was muddy.”(河岸很泥泞。) “The money was deposited in the bank.”(钱存进了银行。) 单词“bank”根据上下文具有不同的含义。自注意力机制使模型能够在第一个句子中关注“river”(河流),在第二个句子中关注“money”(金钱),从而正确调整“bank”的特征表示。
Transformer
自注意力
深度学习
自然语言处理
AI架构