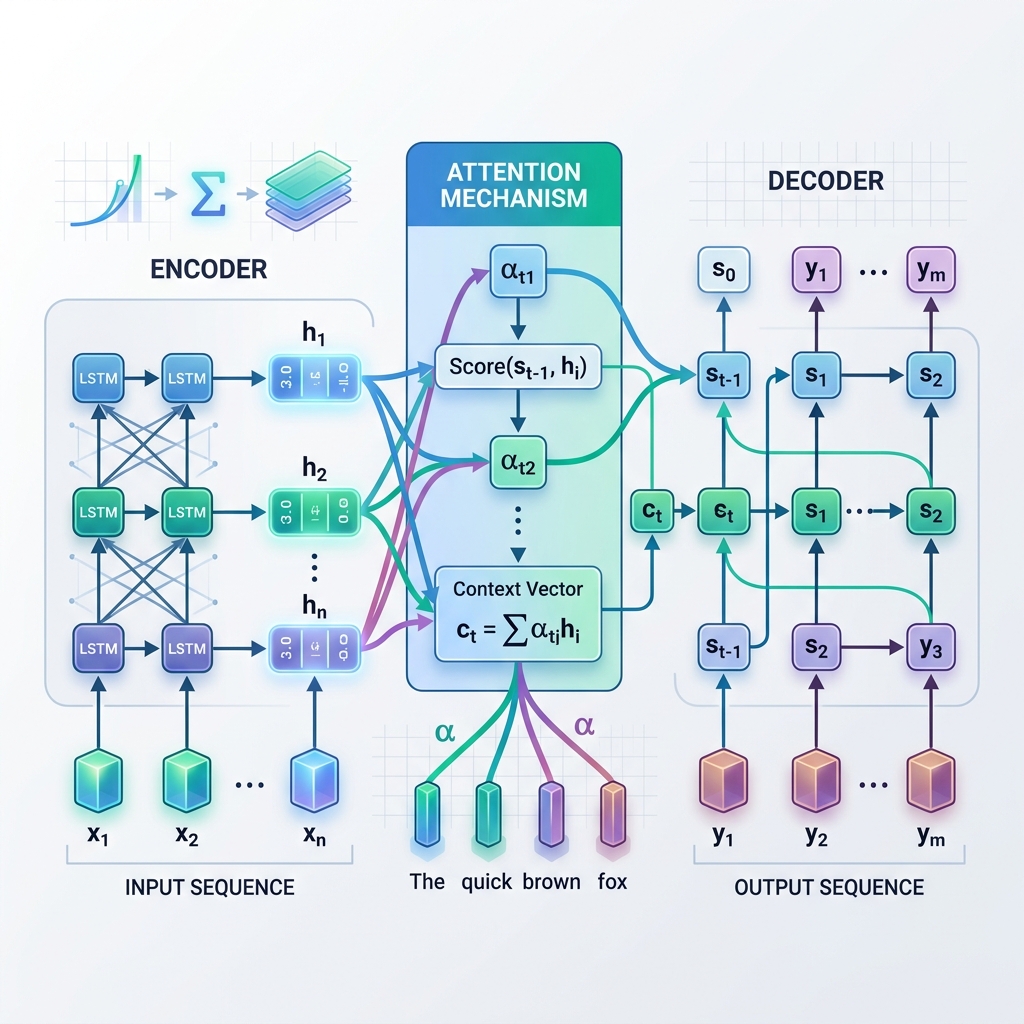
揭秘序列到序列(Seq2Seq)架构与注意力(Attention)机制
在自然语言处理(NLP)和人工智能领域,机器翻译、文本摘要以及对话生成等技术在过去几年中经历了一场革命。这场变革的核心正是序列到序列(Seq2Seq)架构以及开创性的注意力(Attention)机制。
在现代 Transformer 架构诞生之前,这两大创新解决了深度学习领域最棘手的挑战之一:在输入序列和输出序列长度不同时,如何建立它们之间的映射。
1. 理论奠基:什么是序列到序列(Seq2Seq)? 序列到序列(Seq2Seq)模型由谷歌等机构的研究人员于 2014 年提出,它是一种专门用于处理序列数据的编码器-解码器(Encoder-Decoder)框架。它被广泛应用于输入序列长度与输出序列长度不一致的任务中,例如:
机器翻译: 将英文的 “How are you?"(3个单词)翻译为中文的“你好吗?”(3个汉字)或西班牙语的 “¿Cómo estás?"(2个单词)。 文本摘要: 将一篇 500 字的文章压缩为 50 字的摘要。 问答系统: 将问题序列映射到相应的回答序列。 编码器-解码器机制 标准的 Seq2Seq 模型由两个循环神经网络(RNN)组成,通常采用 LSTM(长短期记忆网络)或 GRU(门控循环单元):
编码器(Encoder): 逐个 Token(词元)地处理输入序列。在每一步中,它会根据当前输入的 Token 和上一步的隐藏状态来更新隐藏状态。处理完整个输入后,编码器会提取最后一个隐藏状态。这个最终的隐藏状态被称为上下文向量(Context Vector)(或瓶颈向量)。 解码器(Decoder): 将上下文向量作为其初始隐藏状态,并以自回归的方式逐个 Token 地生成输出序列。在每一步中,它都会根据当前的隐藏状态和前一步生成的单词来预测下一个单词。 2. 瓶颈问题(Bottleneck Problem) 虽然经典的编码器-解码器模型是一项巨大的技术突破,但它存在一个致命的局限性,即信息瓶颈(Information Bottleneck)。
在标准的 Seq2Seq 模型中,编码器被迫将输入句子的完整语义——无论它是 5 个词还是 100 个词——全部压缩进一个固定大小的上下文向量中。
这导致了以下问题:
长期记忆丢失(Long-Term Memory Loss): 对于长句子,当编码器处理到序列末尾时,序列开头的语义信息已经被稀释或遗忘。 性能严重衰退: 随着输入句子长度的增加,翻译或摘要的质量会显著下降。 将复杂的长篇大论压缩进单一向量,就如同在翻译整章书之前,尝试用一句话来概括它一样。信息在这一压缩过程中不可避免地会丢失。
Seq2Seq
注意力机制
深度学习
自然语言处理
人工智能