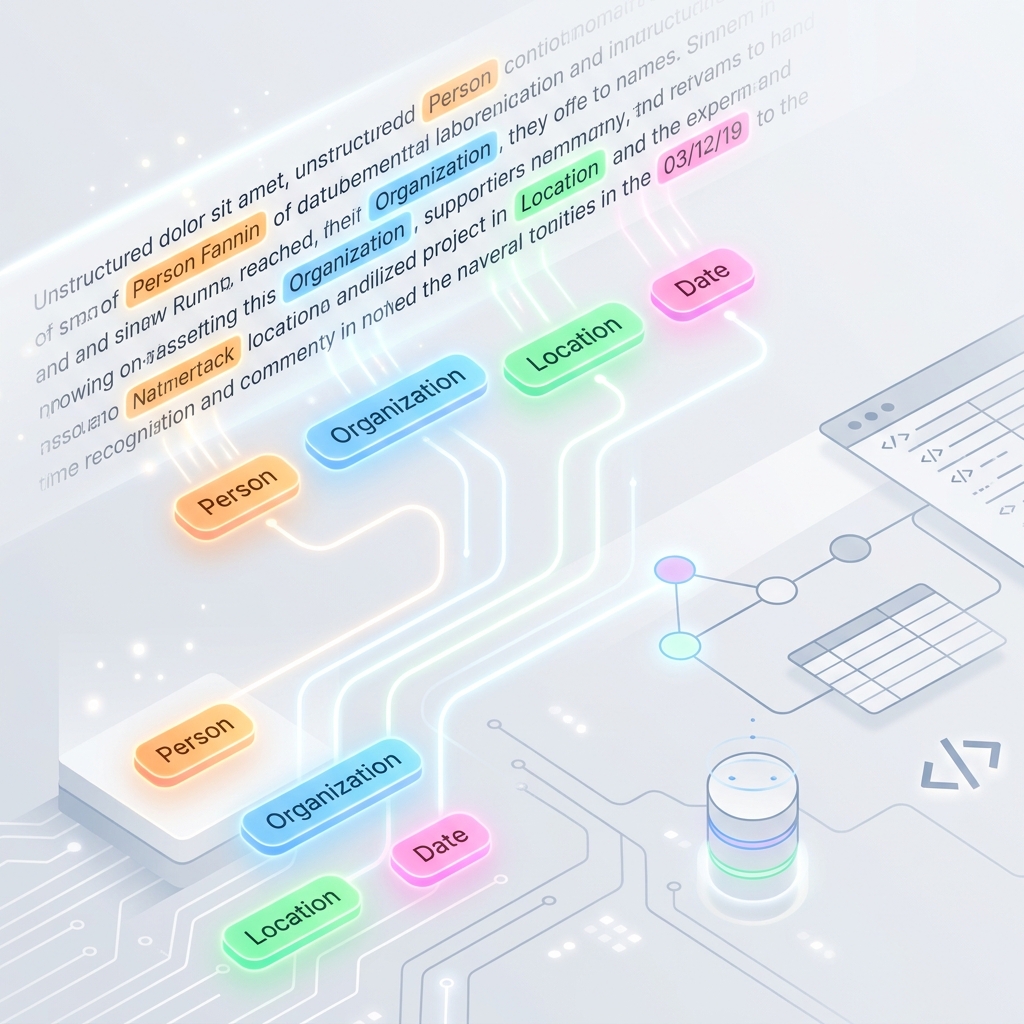
命名实体识别 (NER):从传统自然语言处理到 AI 驱动的数据提取
命名实体识别 (Named Entity Recognition,简称 NER) 是自然语言处理 (NLP) 的基石之一。它是从非结构化文本中自动识别关键元素,并将其归类到预定义类别(如人名、组织机构名、地理位置、日期、货币数值以及产品名称)的过程。
如果没有 NER,搜索引擎、推荐系统和自动化文档分析系统将很难理解文本中包含的“人、事、时、地”等核心信息。
本指南将带您全面了解 NER 的定义、该技术的发展历程,以及为什么现代生成式 AI 彻底改变了实体提取的方式。
1. NER 技术的发展演变 为了理解为什么基于 AI 的 NER 具有如此革命性的意义,我们需要回顾过去几十年来实体提取技术的发展阶段。
第一阶段:基于规则和词典的系统 早期的 NER 主要依赖于正则表达式 (Regex) 和人工整理的词典 (Gazetteers)。
工作原理:如果一个词存在于特定的地理位置数据库中,或者匹配某种模式(例如 [3位数字]-[3位数字]-[4位数字] 的电话号码),它就会被提取出来。 局限性:鲁棒性极差。它无法处理拼写错误、新出现的实体或上下文语义。例如,它无法区分 “Apple” 指的是水果还是这家科技公司。 第二阶段:传统 machine learning (CRF 与 SVM) 在 21 世纪初,条件随机场 (CRF) 和支持向量机 (SVM) 等统计机器学习模型成为了行业标准。
工作原理:工程师需要手动提取特征(例如前缀、后缀、大小写模式),并使用标注数据训练模型,以预测某个 Token 属于特定实体的概率。 局限性:需要大量的标注数据集,且手动特征工程非常繁琐耗时。 第三阶段:深度学习 (BiLSTM-CRF 与 BERT) 随着深度学习的兴起,双向长短期记忆网络 (BiLSTM) 结合 CRF,以及后来的 Transformer 模型(如 BERT)彻底改变了 NLP 领域。
人工智能
命名实体识别
自然语言处理
机器学习
大语言模型