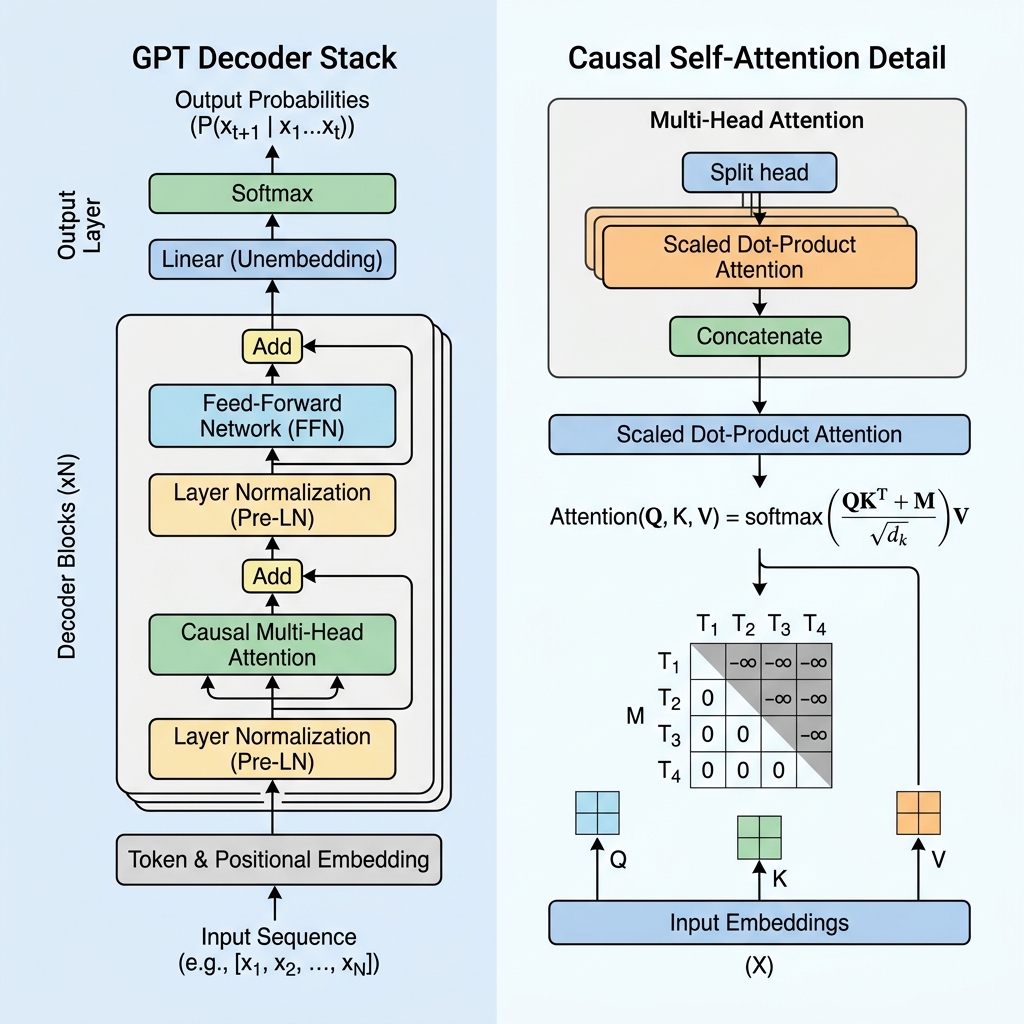
GPT Transformer 如何工作:因果自注意力机制解析
近年来,生成式预训练 Transformer(GPT)彻底改变了人工智能。从代码助手到对话智能体,基于 GPT 的模型正在为当今最先进的生成式应用提供动力。但是这项技术究竟是如何工作的呢?
虽然像 BERT 这样的模型使用 Transformer 的**编码器(Encoder)部分来双向理解文本,但 GPT 采用的是仅解码器(Decoder-only)**的架构,专为自回归的下一 token 预测而设计。在本文中,我们将揭秘 GPT Transformer 的工作原理,深入探讨因果自注意力(Causal Self-Attention)机制,并在代码中对其进行实现。
1. 自回归生成循环 在核心层面,GPT 是一个自回归模型。这意味着要生成一段文本序列,它会一个接一个地预测下一个 token,并使用已生成的 token 作为下一次预测的上下文。
其工作流程遵循以下步骤:
输入: 模型接收一个提示词(prompt):"Deep learning is"。 预测: 模型处理该提示,并在其整个词汇表上输出一个概率分布。它对下一个 token 进行采样:"awesome"。 循环: 新生成的 token 被追加到输入中,使其变为:"Deep learning is awesome"。这个新序列成为下一步的输入。 终止: 重复该过程,直到模型输出特殊的序列结束符([EOS])或达到预设的长度限制。 2. 因果掩码:解码器的核心 在像 BERT 这样仅包含编码器的模型中,每个 token 都可以关注所有其他 token,同时回顾过去并展望未来。然而,对于预测下一个 token 的生成式模型来说,在训练期间看到未来的 token 属于“作弊”。
为了防止模型看到未来的 token, GPT 使用了因果自注意力机制(或称掩码自注意力机制)。
GPT
Transformer
生成式AI
因果注意力
自然语言处理