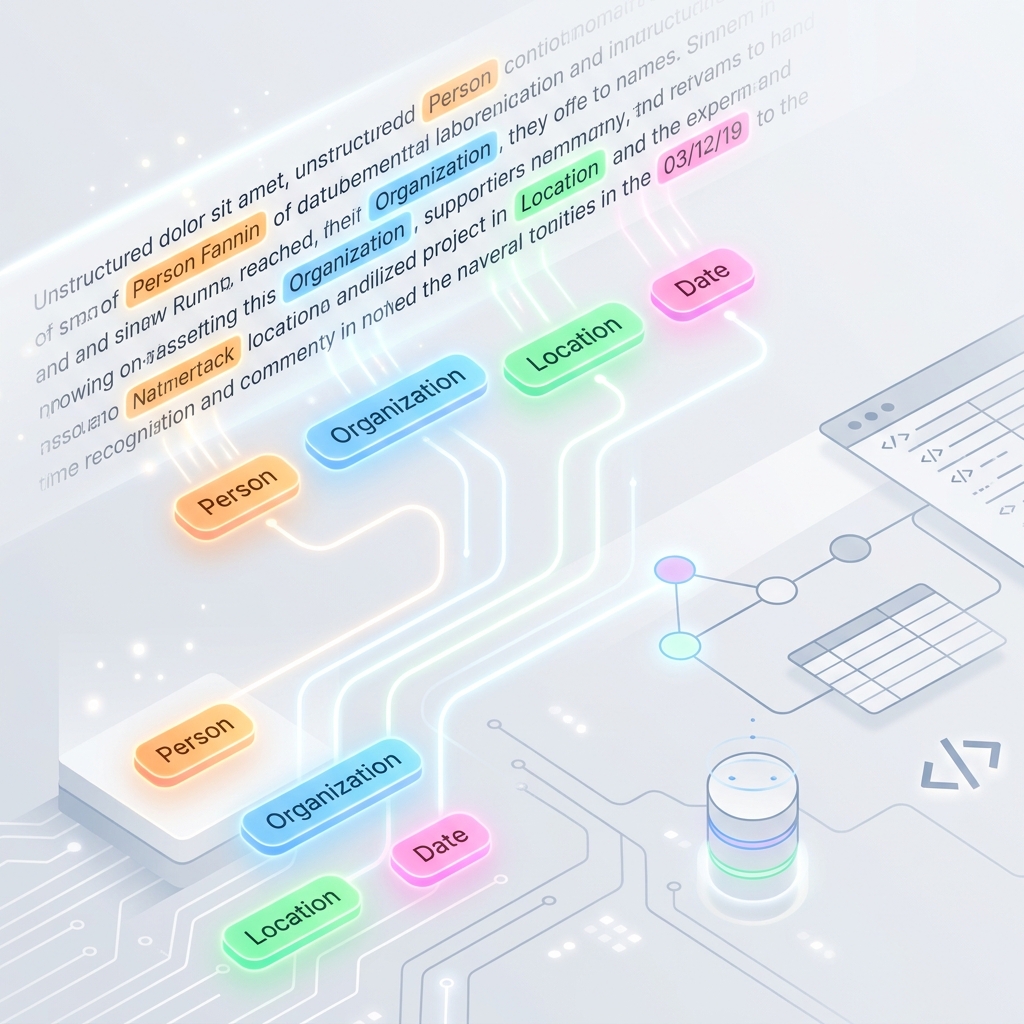
固有表現抽出 (NER): 従来の自然言語処理からAI駆動のデータ抽出への進化
固有表現抽出(Named Entity Recognition: NER)は、自然言語処理(NLP)の基盤技術の一つです。これは、テキストデータなどの非構造化データから、人名、組織名、地名、日付、金銭表現、製品名といった特定のカテゴリに該当する重要な要素を自動的に特定し、分類するプロセスです。
NERがなければ、検索エンジン、レコメンデーションシステム、自動ドキュメント分析システムなどは、テキスト内の「誰が」「何を」「どこで」「いつ」行ったのかを正確に理解することが困難になります。
本記事では、NERの基本概念、技術の進化プロセス、そしてなぜ現代の生成AIがエンティティ抽出を完全に変革したのかについて詳しく解説します。
1. NER技術の進化プロセス AIベースのNERがなぜこれほど革新的なのかを理解するために、過去数十年間におけるエンティティ抽出技術の歩みを振り返りましょう。
第1世代:ルールベースおよび辞書ベースのシステム 初期のNERは、正規表現(regex)や人手で管理された辞書(gazetteer)に依存していました。
仕組み: 抽出対象の単語が地名データベースに存在する場合や、電話番号のようなパターン(例:[3桁]-[3桁]-[4桁])に一致する場合に抽出されます。 限界: 非常に脆弱です。スペルミスや新しいエンティティ、文脈による意味の違いに対応できません。例えば、「Apple」が果物の「リンゴ」を指しているのか、IT企業の「アップル」を指しているのかを区別できませんでした。 第2世代:従来の機械学習 (CRF & SVM) 2000年代に入ると、条件付き確率場(CRF)やサポートベクターマシン(SVM)などの統計的機械学習モデルが主流となりました。
仕組み: 開発者が手動で特徴量(例:接頭辞、接尾辞、大文字・小文字のパターンなど)を設計し、ラベル付けされた訓練データを用いてトークンがエンティティの一部である確率を予測します。 限界: 大量のラベル付きデータが必要であり、手動での特徴量設計には膨大な労力がかかりました。 第3世代:ディープラーニング (BiLSTM-CRF & BERT) ディープラーニングの台頭に伴い、双方向LSTM(BiLSTM)とCRFを組み合わせたモデルや、その後のBERTに代表されるTransformerモデルがNLPに革命をもたらしました。
仕組み: 単語埋め込み(Word Embeddings)がセマンティックな意味を捉え、深層ニューラルネットワークが文脈を理解します。BERTベースのモデルは、前後の文脈から「Apple launched a new iPhone」の中の「Apple」を組織として識別できるようになりました。 限界: 依然としてドメイン固有のデータセットに対する教師ありのファインチューニングが必要であり、事前に定義されていない新しいカテゴリのエンティティを再学習なしで抽出することは困難でした。 第4世代:生成AIとLLMベースのNER 現在、Gemini、GPT-4、Llama 3などの大規模言語モデル(LLMs)は、セマンティックな理解と指示追従能力によってNERを処理します。
仕組み: Zero-shotまたはFew-shotのプロンプトエンジニアリングを使用して、ユーザーは任意のエンティティタイプを指定し、それをJSONなどの構造化データとして返却するようにLLMへ指示できます。 選ばれる理由: 複雑な構文を理解し、スペルミスに対応でき、曖昧な文脈を推論し、開始にあたっての訓練データを一切必要としません。 2. AIベースのNERと従来のNERの比較 特徴 従来のNER (BERT / CRF) AIベースのNER (LLMs) 必要な学習データ 大量(数千以上のラベル付きデータ) 不要〜極少量(Zero-shot / Few-shot) 柔軟性 低い(学習済みのカテゴリのみ抽出) 極めて高い(プロンプト内で任意のカテゴリを定義可能) 文脈理解 中程度(局所的なコンテキストウィンドウ) 深い(ドキュメント全体のコンテキストや意図を理解) 未知語(OOV)への対応 苦手(未学習の単語に苦戦) 得意(セマンティックな推論を利用) 処理速度とコスト 高速・安価(小型のCPU/GPUでローカル実行可能) 低速・比較的高コスト(大規模モデルの推論が必要) 3. AIベースのNERの主な応用分野 AIベースの固有表現抽出は、単なるテキストのハイライトにとどまりません。非構造化テキストを構造化されたアクション可能なJSONデータに変換することで、強力な自動化を実現します。
AI
固有表現抽出
自然言語処理
機械学習
大規模言語モデル