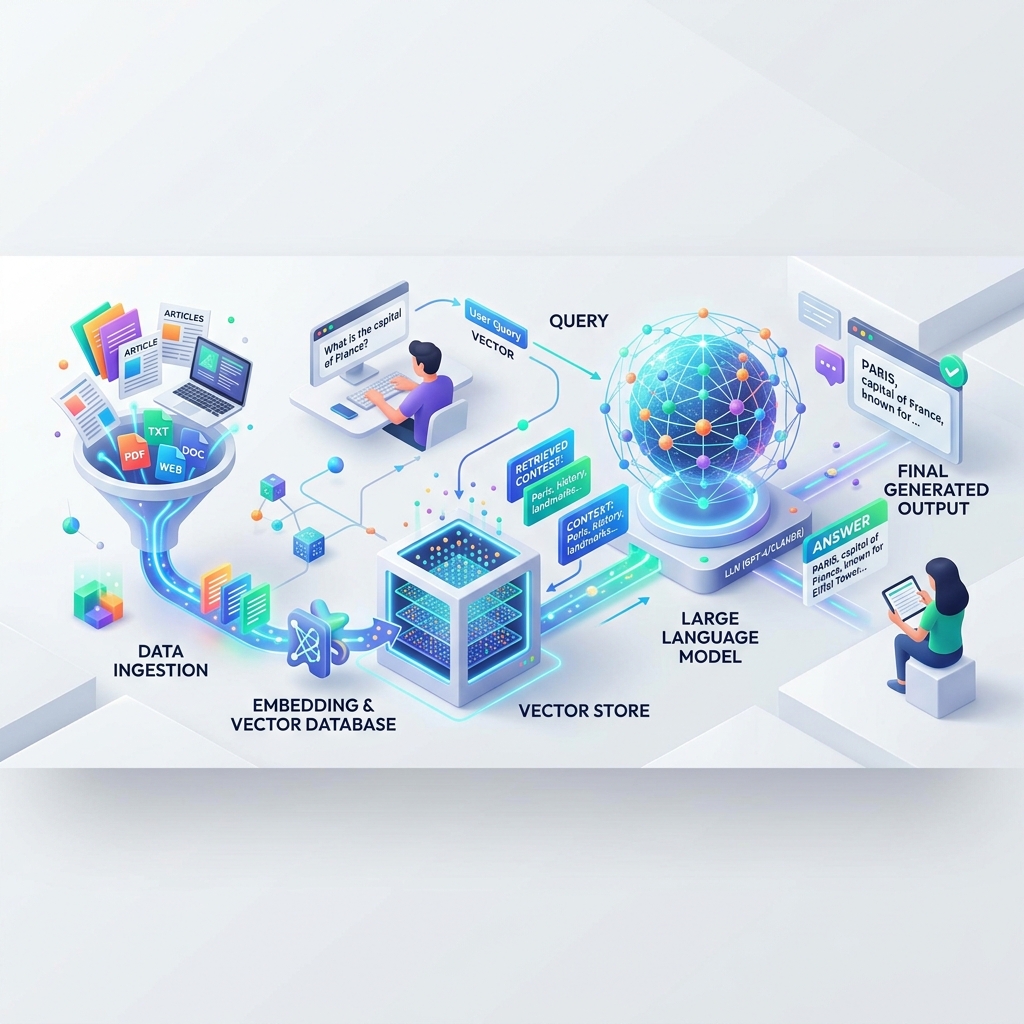
RAGモデルの理解:LLMを現実世界の知識と紐づける
GPT-4やGeminiのような大規模言語モデル(LLM)は非常に強力ですが、いくつかの重大な弱点があります。それは、ハルシネーション(嘘の出力)を起こすこと、学習データのカットオフ日以降の情報を知らないこと、そして企業のプライベートデータにアクセスできないことです。
これらの制限を解決するために、開発者は「検索拡張生成(Retrieval-Augmented Generation:RAG)」を使用します。RAGは、外部データベースから関連情報を検索し、それをLLMに提供して正確で文脈に沿った回答を生成するフレームワークです。
以下は、RAGモデルの理解、その仕組み、そしてエンタープライズAIにとってRAGが不可欠である理由についての包括的なガイドです。
1. 検索拡張生成(RAG)とは? RAGは本質的に、次の2つの異なるプロセスを組み合わせたものです。
検索(Retrieval): ユーザーの質問に基づいて、知識ベースから関連するドキュメントやテキストチャンク(断片)を探し出すこと。 生成(Generation): 検索されたドキュメントをユーザーの質問と一緒にLLMに送り、正確な回答を生成させること。 これは「持ち込み可能な試験」のようなものです。学習中に記憶したことだけに頼る(持ち込み不可の試験)代わりに、回答する前に参考書(知識ベース)を調べることが許可されている状態です。
2. RAGパイプラインのステップ・バイ・ステップ 標準的なRAGパイプラインは、インジェクション(データ準備)、検索(Retrieval)、生成(Generation)の3つの主要フェーズで構成されています。
フェーズ1:インジェクション(データの準備) システムが情報を検索できるようになる前に、生データを処理する必要があります。
ロード: ドキュメント(PDF、Markdown、Webページなど)を収集します。 チャンキング(分割): 大きなファイルを小さく扱いやすいテキストチャンク(例:500文字)に分割します。 埋め込み(Embedding): 埋め込みモデルによって、テキストチャンクをその意味を表す密な数値ベクトルに変換します。 保存: ベクトル化されたデータを専用の「ベクトルデータベース」(Milvus、Pinecone、Qdrantなど)に保存します。 フェーズ2:検索(Retrieval) ユーザーが質問をすると:
ユーザーの質問は、同じ埋め込みモデルを使用してベクトルに変換されます。 システムは、ベクトルデータベース内でベクトル類似度検索(コサイン類似度など)を実行し、質問に最も関連するテキストチャンクを探します。 最も一致するチャンクが取り出されます。 フェーズ3:生成(Generation) 編集されたテキストチャンクは、ユーザーの元の質問と組み合わされ、詳細なプロンプトテンプレートになります。 このプロンプトがLLMに送信されます。 LLMは文脈を読み、関連する事実を抽出して、提供されたドキュメントに基づく自然言語の回答を生成します。 3. 埋め込み(Embedding)はどのように作られるか 埋め込みはRAGの数学的な背骨です。人間の言語を、意味を捉えた密な数値ベクトルに変換します。
埋め込みのプロセス: トークン化: テキストチャンクを「トークン」と呼ばれる小さな断片に分割します。 エンコーダーモデル: BERTやOpenAIのtext-embedding-3のような、Transformerベースの専用エンコーダーがトークンを処理します。 高次元ベクトル: モデルは数値のリスト(通常は384次元、768次元、または1536次元)を出力します。それぞれの次元が異なる意味的特徴や概念を表しています。 意味マッピング: このベクトル空間において、似た意味を持つ言葉やフレーズは近くに配置されます。例えば、「猫」のベクトルは、「車」よりも「子猫」のベクトルと近くなります。 距離の測定基準: ベクトルデータベースは、コサイン類似度(ベクトル間の角度)、ドット積(内積)、ユークリッド距離などの数式を使用して、質問のベクトルと文書のベクトルとの距離を測定し、関連する文脈を特定します。 4. RAGワークフローの完全なウォークスルー 以下は、リクエストがRAGシステム内をどのように流れるかを示したステップ・バイ・ステップのウォークスルーです。
[ユーザーの質問] ──> [埋め込みモデル] ──> [質問ベクトル] │ ▼ [LLMの回答] <── [LLM] <── [プロンプト] <── [ベクトルDB検索] (文脈 + 質問) ユーザー入力: ユーザーが質問を入力します(例:「第3四半期の売上はいくらでしたか?」)。 質問のベクトル化: 埋め込みモデルにより質問がベクトルに変換されます。 データベース検索: ベクトルデータベースが質問ベクトルとすべての文書ベクトルを比較し、最も近い上位K個のテキストチャンクを検索します。 文脈の融合: 検索されたチャンクが、ユーザーの元の質問と一緒にプロンプトテンプレートに挿入されます。 LLMの推論: LLMが文脈の組み込まれたプロンプトを読み取り、提供された文書に基づいて自然で正確な回答を生成します。 5. RAG vs ファインチューニング:どちらが良いか? LLMをカスタムデータに適応させる際、開発者はRAGとファインチューニングのどちらかを選択することがよくあります。それぞれの比較は以下の通りです。
AI
RAGモデル
LLM
ベクトルデータベース
機械学習