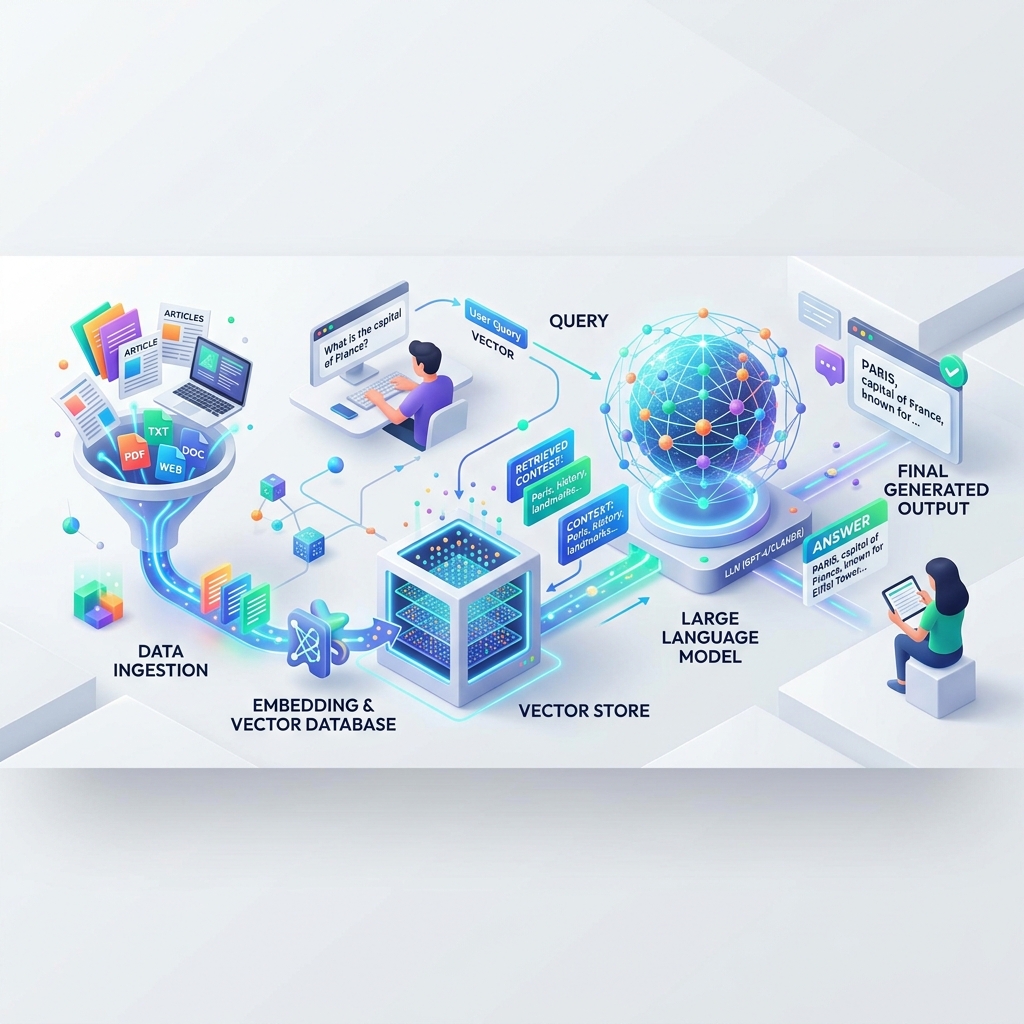
深入理解 RAG 模型:利用真实世界知识增强大语言模型
像 GPT-4 或 Gemini 这样的大语言模型(LLM)功能异常强大,但它们也存在一些关键弱点:它们会产生幻觉、无法获知训练截止日期之后的信息,并且无法访问您的私有域数据。
为了解决这些局限性,开发人员引入了检索增强生成(Retrieval-Augmented Generation,简称 RAG)。RAG 是一种通过从外部数据库中检索相关信息,并将其提供给大语言模型来生成准确且富含上下文信息的应答的框架。
这篇全面指南将带您深入理解 RAG 模型、其工作原理,以及为什么它对企业级人工智能至关重要。
1. 什么是检索增强生成 (RAG)? 从核心来看,RAG 结合了两个独立的过程:
检索 (Retrieval):根据用户查询,从知识库中寻找相关的文档或文本块。 生成 (Generation):将检索到的文档连同用户查询一起输入到大语言模型中,以便其生成准确的回答。 这就像是一场开卷考试。模型不再仅仅依靠在训练期间记住的内容(闭卷考试),而是被允许在回答之前查找参考书(知识库)。
2. 步步拆解 RAG 工作流 标准的 RAG 流水线主要包含三个阶段:数据准备(Ingestion)、检索(Retrieval)和生成(Generation)。
阶段 1:数据准备 (Ingestion) 在系统能够检索信息之前,必须对原始数据进行处理:
数据加载:收集文档(PDF、Markdown、网页等)。 文本分块 (Chunking):将大文件切分成更小、更易管理的文本块(例如 500 个字符)。 向量化 (Embedding):利用嵌入模型将这些文本块转换为紧密的数学向量,以代表它们的语义特征。 数据存储:将这些向量表示形式存储在专用的向量数据库中(如 Milvus、Pinecone 或 Qdrant)。 阶段 2:检索 (Retrieval) 当用户提出问题时:
使用相同的嵌入模型将用户的查询转换为向量。 系统在向量数据库中进行向量相似度搜索(如余弦相似度),以找到与查询最相关的文本块。 提取出匹配度最高的文本块。 阶段 3:生成 (Generation) 将检索到的文本块与用户原始的查询合并到一个详细的提示词模板中。 将此提示词发送给大语言模型。 大语言模型读取上下文,提取相关事实,并基于提供的文档生成自然语言回答。 3. 向量嵌入 (Embeddings) 是如何生成的 向量嵌入是 RAG 的数学基石。它们将人类语言转换为捕获语义信息的密集数值向量。
人工智能
RAG 模型
大语言模型
向量数据库
机器学习