🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

LLM

Ghaznix BPE 分词器:终极大模型 Token 可视化工具

Ghaznix BPE 分词器:终极大模型 Token 可视化工具

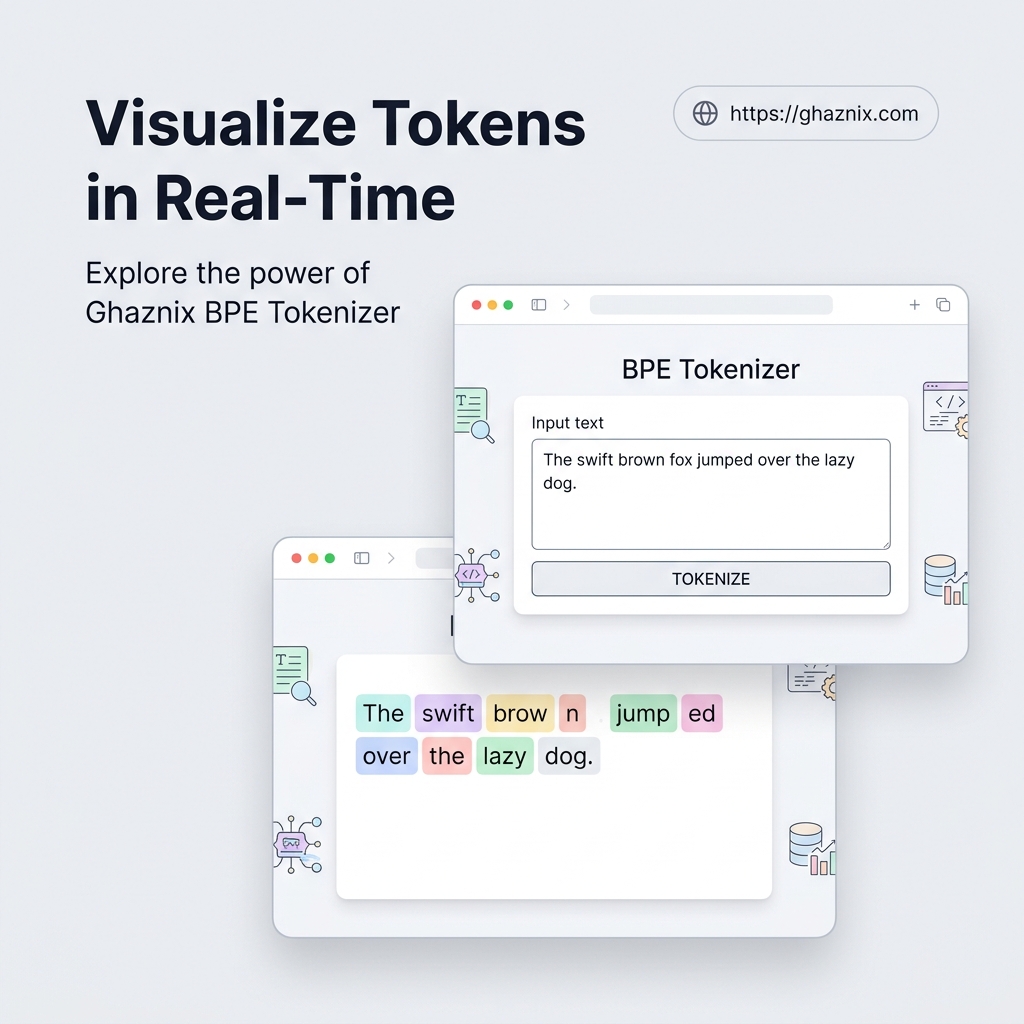
你是否曾经好奇过像 GPT-4、Claude 或 Llama 这样的大语言模型(LLM)是如何阅读你的提示词(Prompts)的?它们看到的文字并不像人类看到的那样。相反,它们会将文本处理成称为 Token 的段落。 理解并可视化 Token 拆分是 LLM 开发者和提示词工程师最核心的技能之一。它直接影响模型的行为、回答的质量,以及最关键的——你的 API 成本。 这就是我们开发 Ghaznix BPE 分词器 的原因——一款终极实时 Token 可视化与成本估算工具。 1. 什么是 BPE 分词器? 字节对编码(BPE,Byte-Pair Encoding)是现代 Transformer 模型使用的标准分词算法。它通过迭代合并文本中出现频率最高的字节或字符对,来构建子词(subword)单元的词表。 因为模型处理的是子词而不是完整的单词,一个单词可能会被拆分为多个 Token。例如,英文单词 “tokenization” 可能会被某些分词器拆分为 “token” 和 “ization”。 2. 为什么可视化 Token 如此重要 在构建由大模型驱动的应用时,开发者面临着几个隐藏的挑战: 多语言税(Tax): 非英语字符、表情符号和特殊符号通常会消耗多得多的 Token。一个中文汉字或带变音符号的德文字符所消耗的 Token 数量可能是英文单词的 3 到 4 倍,从而导致意外的高额账单。 提示词长度管理: 模型具有严格的上下文窗口。可视化提示词的拆分方式有助于你优化文本密度。 成本差异: 不同的模型家族使用不同的词表。GPT-4 的 o200k_base 词表拆分文本的方式与 Llama 3 或 Claude 的分词器不同,这导致完全相同的输入在不同模型中产生不同的 Token 数量。 3. Ghaznix BPE 分词器的核心功能 Ghaznix BPE 分词器专为提高开发者效率而设计:
分词器 bpe llm 开发工具 ghaznix
LLM 推理:AI 如何思考、解决问题与进化

LLM 推理:AI 如何思考、解决问题与进化

大型语言模型 (LLM) 席卷全球,不仅因为它们能生成类似人类的文本,还因为它们似乎能通过复杂的“推理”来解决问题。但是,一个基于词元 (token) 预测的统计模型究竟是如何执行逻辑任务 forest? 在这篇文章中,我们将探索 LLM 推理的机制,从简单的模式匹配到思维链 (Chain of Thought - CoT) 等高级策略。 1. 是真正的推理还是仅仅是预测? 从本质上讲,LLM 被训练用于预测序列中的下一个词元。然而,随着这些模型规模(参数量)的增长,开始出现涌现属性。研究人员发现,模型可以解决数学问题、编写代码并遵循复杂的指令——这些任务需要的不仅仅是记忆。 这通常被称为**“涌现推理”**。虽然模型不像人类那样“思考”,但其内部的语言表示包含足够的逻辑结构来模拟推理步骤。 2. 突破:思维链 (CoT) LLM 推理中最显著的进展之一是思维链 (CoT) 提示。CoT 不直接询问最终答案,而是鼓励模型生成中间步骤。 CoT 的工作原理: 分步逻辑: 模型将复杂问题分解为更小、更易于管理的片段。 记忆缓冲: 中间步骤充当工作记忆,允许模型“回溯”到其先前的逻辑。 验证: 通过展示其工作过程,模型不太可能犯下“逻辑跳跃”错误。 3. 系统 1 与系统 2 思维 心理学家丹尼尔·卡尼曼曾著名地描述了人类思维的两个系统: 系统 1: 快速、本能且情绪化(例如识别面部)。 系统 2: 较慢、更深思熟虑且合乎逻辑(例如解数学方程)。 大多数 LLM 主要以“系统 1”模式运行——它们根据概率快速生成文本。目前的研究重点是将 AI 推向系统 2 思维,即模型在输出最终答案之前会暂停、反思并验证其逻辑。 4. 当前局限性 尽管其能力令人印象深刻,但 LLM 在推理方面仍面临重大障碍:
AI LLM 推理 机器学习 思维链 技术