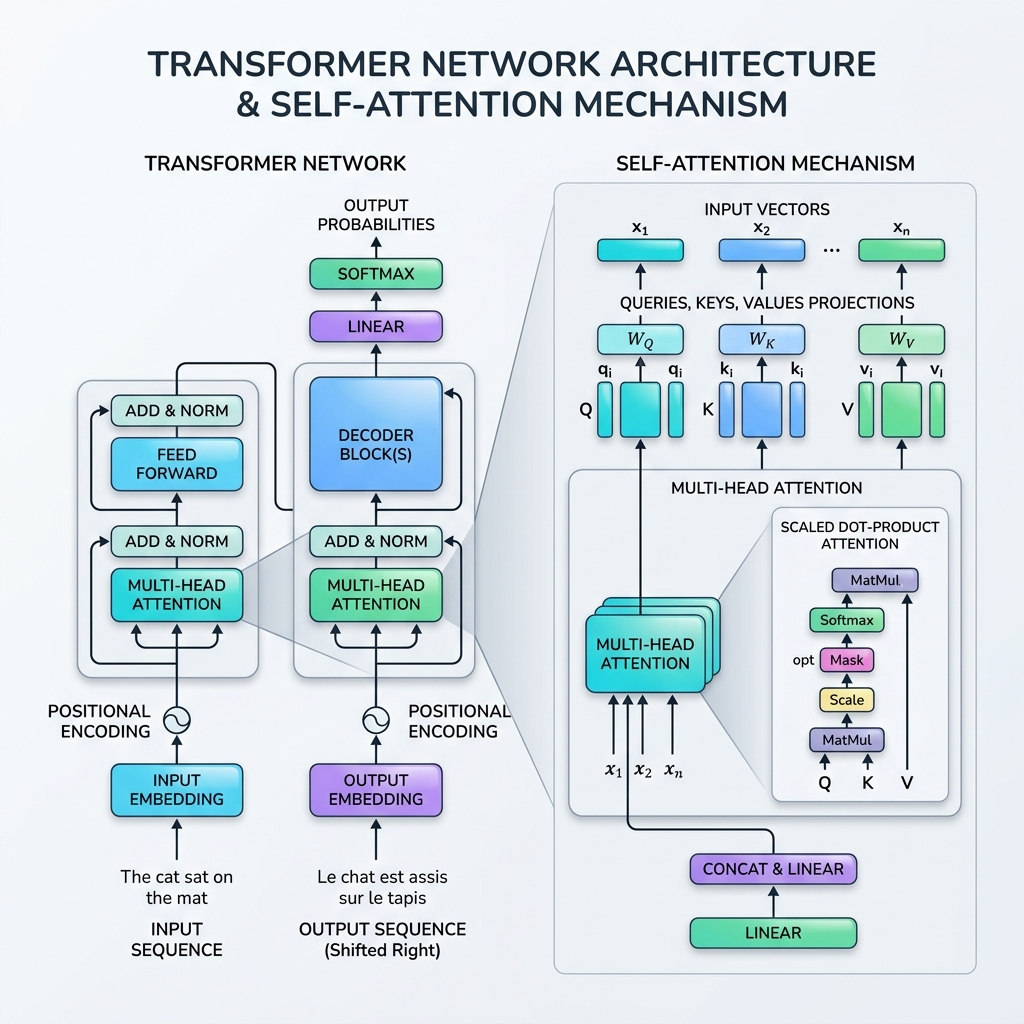
Transformer 네트워크와 셀프 어텐션(Self-Attention) 메커니즘의 이해
2017년, Vaswani 등이 발표한 기념비적인 논문 **“Attention Is All You Need”**에 의해 인공지능 연구 지형은 영원히 바뀌었습니다. 이 논문은 순환 신경망(RNN, LSTM)과 같은 재귀적 구조를 완전히 배제하고, 대신 셀프 어텐션(Self-Attention) 메커니즘을 사용하여 시퀀스 데이터를 병렬로 처리하는 혁신적인 신경망 아키텍처인 Transformer를 도입했습니다.
오늘날 Transformer는 GPT-4, Gemini, Claude, Llama를 포함한 거의 모든 최첨단 대규모 언어 모델(LLM)의 핵심 동력입니다. 이 블로그에서는 Transformer 네트워크의 작동 방식을 명쾌하게 밝히고 셀프 어텐션 메커니즘이 수학적 및 실무적으로 어떻게 구현되는지 설명합니다.
Transformer
셀프 어텐션
딥러닝
자연어처리
AI 아키텍처