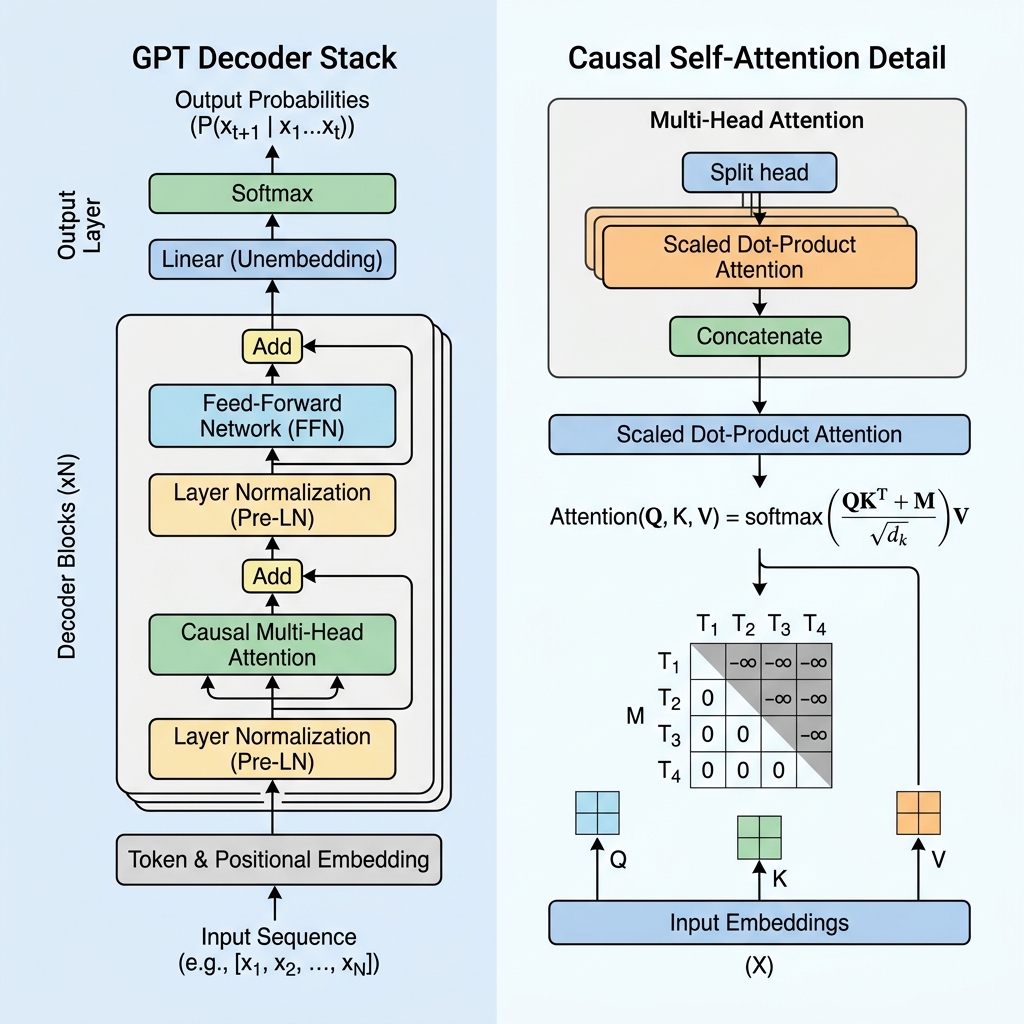
Come funziona il GPT Transformer: Spiegazione della Causal Self-Attention
Negli ultimi anni, i Generative Pre-trained Transformers (GPT) hanno rivoluzionato l’intelligenza artificiale. Dagli assistenti di programmazione agli agenti conversazionali, i modelli basati su GPT alimentano oggi le applicazioni generative più avanzate. Ma come funziona effettivamente questa tecnologia?
Mentre modelli come BERT utilizzano la parte Encoder del Transformer per comprendere il testo in modo bidirezionale, GPT è un’architettura Decoder-only progettata per la previsione autoregressiva del token successivo. In questo blog demistificheremo il funzionamento del GPT Transformer, approfondiremo il meccanismo di causal self-attention e lo implementeremo nel codice.
GPT
Transformer
IA Generativa
Attenzione Causale
NLP