🔥 FREE PRO OFFER OnlyLink.click Pro Version is 100% Free of Cost till 31 December, 2026! Claim Free Pro

למידת מכונה

זיהוי ישויות נקובות (NER): מ-NLP קלאסי לחילוץ מבוסס בינה מלאכותית

זיהוי ישויות נקובות (NER): מ-NLP קלאסי לחילוץ מבוסס בינה מלאכותית

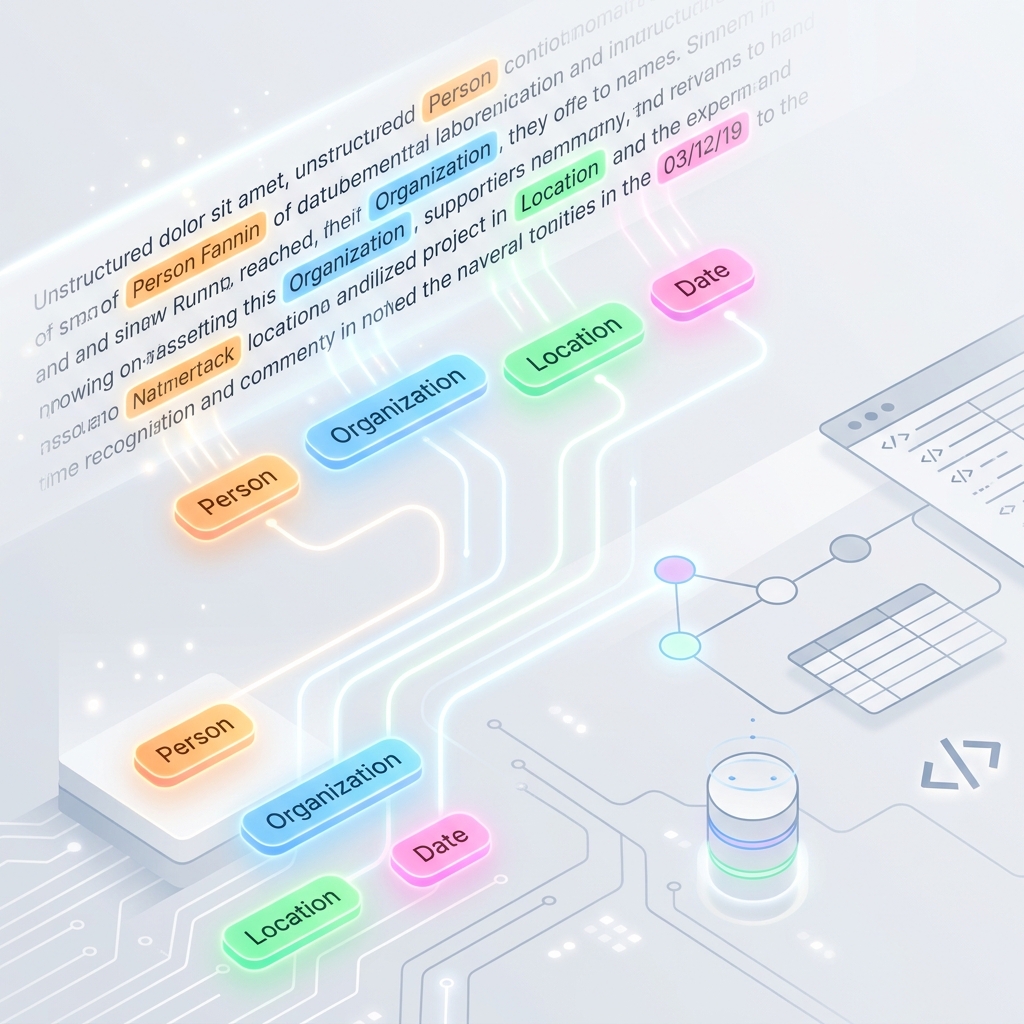
זיהוי ישויות נקובות (Named Entity Recognition - NER) הוא אבן יסוד בעיבוד שפה טבעית (NLP). זהו התהליך של זיהוי וסיווג אוטומטי של אלמנטים מרכזיים בטקסט לא מובנה לקטגוריות מוגדרות מראש - כגון שמות של אנשים, ארגונים, מיקומים, תאריכים, ערכים כספיים ושמות מוצרים. ללא NER, מנועי חיפוש, מנועי המלצות ומערכות אוטומטיות לניתוח מסמכים יתקשו להבין מי, מה, איפה ומתי בתוך טקסט.
AI NER NLP למידת מכונה מודלי שפה גדולים
הבנת מודלי RAG: עיגון מודלי שפה גדולים בידע מהעולם האמיתי

הבנת מודלי RAG: עיגון מודלי שפה גדולים בידע מהעולם האמיתי

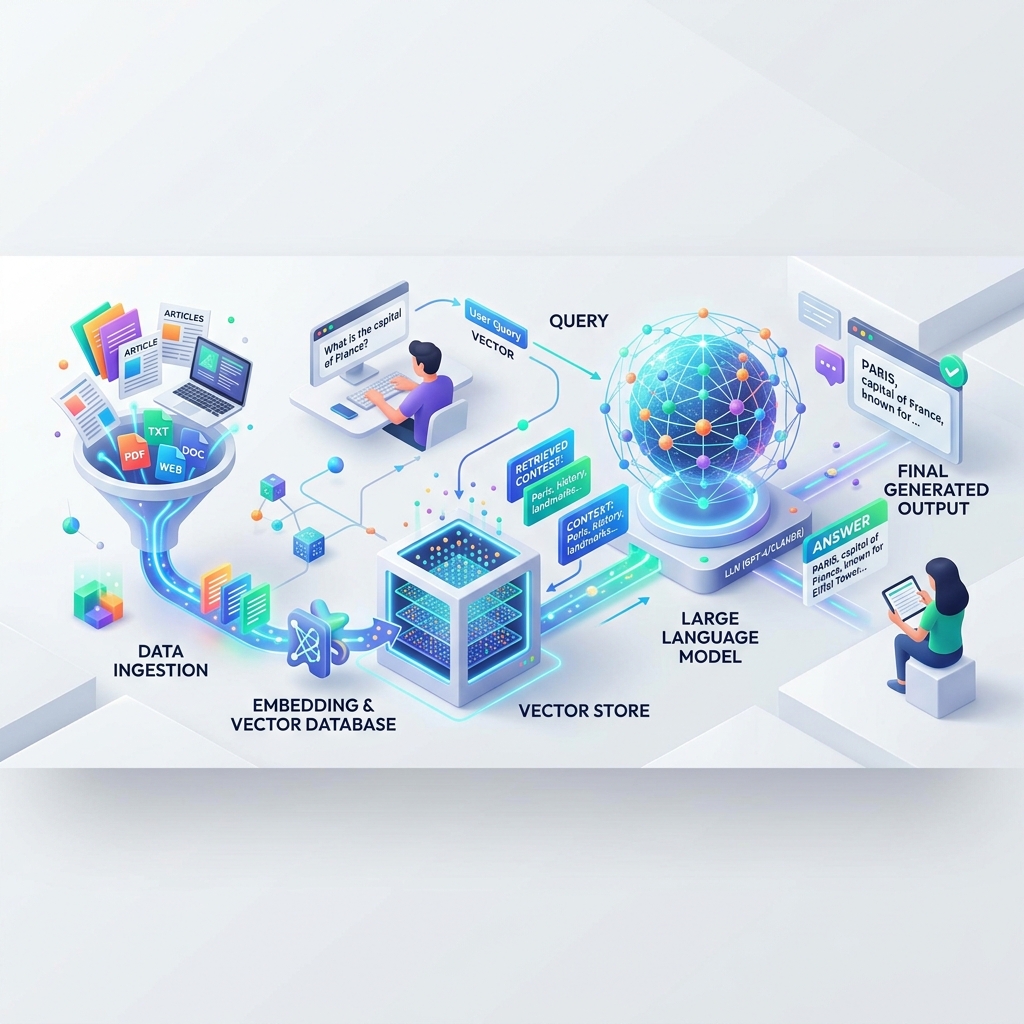
מודלי שפה גדולים (LLMs) כמו GPT-4 או Gemini הם עוצמתיים להפליא, אך יש להם מספר חולשות קריטיות: הם נוטים להזות (להמציא עובדות), הם אינם מכירים מידע לאחר תאריך סיום האימון שלהם, ואין להם גישה לנתוני הדומיין הפרטיים שלך. כדי לפתור מגבלות אלו, מפתחים משתמשים ב-Retrieval-Augmented Generation (יצירה מועשרת באחזור - RAG). RAG היא מסגרת עבודה המאחזרת מידע רלוונטי מבסיס נתונים חיצוני ומספקת אותו ל-LLM כדי לייצר תגובות מדויקות ותלויות הקשר.
AI מודלי RAG LLMs בסיס נתונים וקטורי למידת מכונה
ניתוח סנטימנט בערבית: מדריך מעשי לעיבוד מקדים ומידול NLP

ניתוח סנטימנט בערבית: מדריך מעשי לעיבוד מקדים ומידול NLP

בעידן התקשורת הדיגיטלית הגלובלית, ניתוח סנטימנט (התפקיד של זיהוי הטון הרגשי מאחורי טקסט) הפך לקריטי עבור עסקים, ממשלות וחוקרים. בעוד שניתוח סנטימנט הוא תחום בוגר מאוד עבור שפות כמו אנגלית, יישומו על השפה הערבית מציג סט ייחודי של אתגרים בלשניים וטכנולוגיים. עם למעלה מ-400 מיליון דוברים, ערבית היא אחת השפות המדוברות ביותר בעולם. עם זאת, המבנה המורפולוגי העשיר שלה, הדיגלוסיה (דו-לשוניות - קיום מקביל של שפה ספרותית ומדוברת) ומערכת הכתיבה המורכבת דורשים אסטרטגיות עיבוד מקדים ומידול מיוחדות.
עיבוד שפה טבעیت NLP ניתוח סנטימנט בינה מלאכותית בערבית Transformers Python למידת מכונה
שילוב בינה מלאכותית באפליקציות מובייל: מדריך מעשי שלב אחר שלב

שילוב בינה מלאכותית באפליקציות מובייל: מדריך מעשי שלב אחר שלב

בשנת 2026, אפליקציות מובייל אינן עוד רק ממשקים להצגת נתונים סטטיים. מהן מצופה יותר ויותר לתפוס, לנתח ולהגיב לסביבתן בזמן אמת. שילוב בינה מלאכותית (AI) בסביבת הפיתוח שלכם למובייל אינו עוד מותרות עתידנית — אלא צורך מודרני. עם זאת, מפתחים עומדים בפני החלטה ארכיטקטונית קריטית: האם להריץ את מודלי ה-AI שלכם בענן באמצעות APIs, או ישירות על גבי המכשיר?
פיתוח מובייל שילוב בינה מלאכותית AI במכשיר Edge AI Swift Kotlin למידת מכונה
כיצד למידת מכונה מזהה מתקפות Zero-Day

כיצד למידת מכונה מזהה מתקפות Zero-Day

במשך עשרות שנים, אבטחת סייבר הייתה משחק חתול ועכבר המבוסס על חתימות (signatures). כאשר התגלה סוג חדש של נוזקה או אקספלויט, חוקרי אבטחה ניתחו אותו, חילצו חתימה דיגיטלית ייחודית והפיצו אותה למאגרי המידע של האנטי-וירוס. אך להגנה מבוססת חתימות יש פגם קריטי: היא פועלת לחלוטיن בצורה תגובתית (reactive). היא אינה יכולה לעצור את מה שלא ראתה מעולם.
למידת מכונה מתקפות Zero-Day אבטחת מידע זיהוי איומים בינה מלאכותית באבטחה
איך עובדת ראייה ממוחשבת (Computer Vision): מפיקסלים לבינה בעולם האמיתי

איך עובדת ראייה ממוחשבת (Computer Vision): מפיקסלים לבינה בעולם האמיתי

בעידן הדיגיטלי של שנת 2026, ראייה ממוחשבת (Computer Vision) הפכה לאחד הענפים המשמעותיים ביותר של הבינה המלאכותית. זהו המדע המאפשר למחשבים “לראות” ולפרש את העולם החזותי בדיוק כפי שבני אדם עושים - ואף טוב יותר. מזיהוי הפנים בסמארטפון שלכם ועד לרחפנים אוטונומיים המספקים חבילות, הראייה הממוחשבת נמצאת בכל מקום. אבל איך מכונה באמת מתרגמת רשת של מספרים לאובייקט מזוהה?
ראייה ממוחשבת בינה מלאכותית למידת מכונה למידה עמוקה זיהوي תמונות מגמות טכנולוגיות 2026
הסקה של LLM: איך בינה מלאכותית חושבת, פותרת ומתפתחת

הסקה של LLM: איך בינה מלאכותית חושבת, פותרת ומתפתחת

מודלי שפה גדולים (LLMs) כבשו את העולם בסערה, לא רק בגלל שהם יכולים לייצר טקסט דמוי אדם, אלא בגלל שהם נראים כ"מסיקים" (reasoning) דרך בעיות מורכבות. אבל איך מודל סטטיסטי המבוסס על חיזוי טוקנים (tokens) מבצע בפועל משימות לוגיות? בפוסט זה, נחקור את המכניקה של הסקת LLM, מהתאמת תבניות פשוטה ועד לאסטרטגיות מתקדמות כמו “שרשרת מחשבה” (Chain of Thought - CoT).
AI LLM הסקה למידת מכונה שרשרת מחשבה טכנולוגיה
למידה פדרטיבית: אימון בינה מלאכותית מבלי לשתף את המידע שלך

למידה פדרטיבית: אימון בינה מלאכותית מבלי לשתף את המידע שלך

בצינור העבודה המסורתי של למידת מכונה, איסוף נתונים הוא השלב הראשון ולעתים קרובות היקר ביותר. כדי לאמן מודל, עליך לאסוף נתוני משתמש גולמיים – כמו תמונות, הודעות טקסט, רשומות רפואיות או עסקאות פיננסיות – ולהעלות אותם לשרת ענן מרכזי. למרות שהגישה המרכזית הזו הניעה את מהפכת ה-AI, היא ניצבת בפני אתגרים משמעותיים: דאגות פרטיות: משתמשים נמנעים יותר ויותר מלהעלות נתונים פרטיים לשרתים של צד שלישי. רגולציית נתונים: חוקים כמו GDPR ו-HIPAA מגבילים באופן קפדני את אופן ההעברה והאחסון של מידע אישי. עלויות רוחב פס: העלאת ג’יגה-בייטים של נתונים גולמיים ממיליוני מכשירי קצה (כמו סמארטפונים) היא מאוד לא יעילה. למידה פדרטיבית (Federated Learning - FL) פותרת את הבעיות הללו על ידי הפיכת הפרדיגמה המסורתית על פיה. במקום להביא את הנתונים אל המודל, היא מביאה את המודל אל הנתונים.
למידת מכונה פרטיות בינה מלאכותית מחשוב מבוזר אבטחת מידע