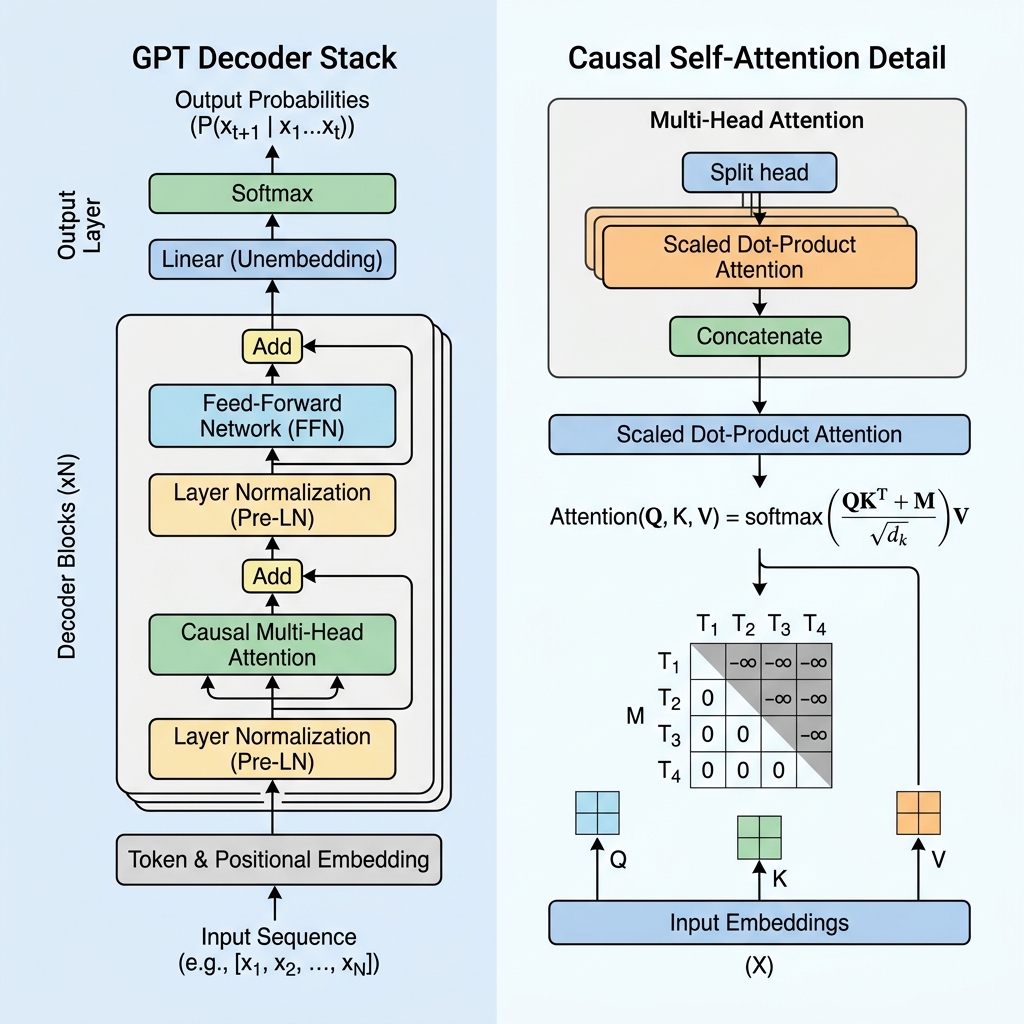
Wie der GPT-Transformer funktioniert: Kausale Self-Attention erklärt
In den letzten Jahren haben Generative Pre-trained Transformers (GPT) die künstliche Intelligenz revolutioniert. Von Programmierassistenten bis hin zu Konversationsagenten treiben GPT-basierte Modelle heute die fortschrittlichsten generativen Anwendungen an. Aber wie funktioniert diese Technologie eigentlich?
Während Modelle wie BERT den Encoder-Teil des Transformers nutzen, um Text bidirektional zu verstehen, ist GPT eine Decoder-only-Architektur, die für die autoregressive Vorhersage des nächsten Tokens konzipiert ist. In diesem Blog werden wir die Funktionsweise des GPT-Transformers entmystifizieren, tief in den kausalen Self-Attention-Mechanismus eintauchen und ihn im Code implementieren.
GPT
Transformer
Generative KI
Kausale Attention
NLP