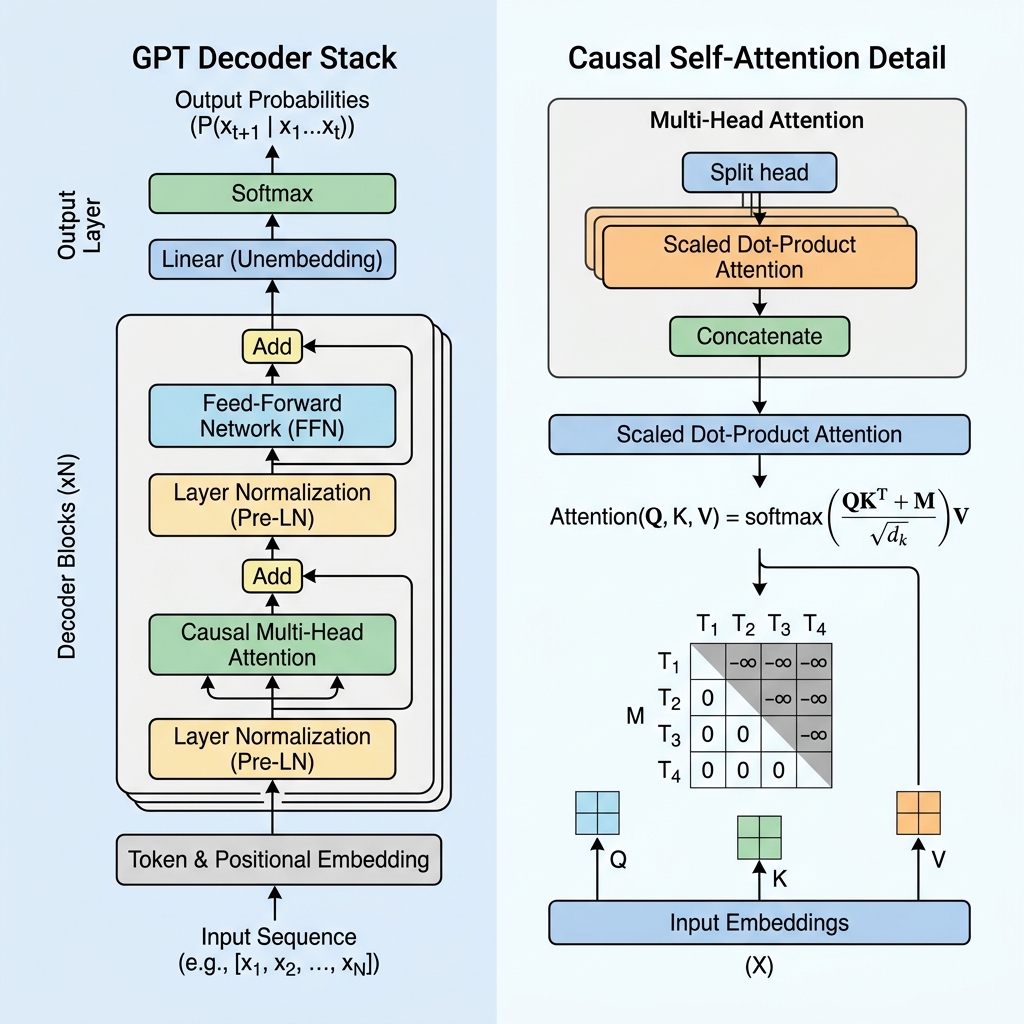
كيف يعمل نموذج GPT Transformer: شرح آلية الانتباه الذاتي السببي
في السنوات الأخيرة، أحدثت النماذج التوليدية مسبقة التدريب (GPT) ثورة حقيقية في مجالات الذكاء الاصطناعي. من مساعدي البرمجة إلى برمجيات المحادثة التفاعلية، تشغل النماذج القائمة على GPT أكثر التطبيقات التوليدية تقدمًا اليوم. ولكن كيف تعمل هذه التكنولوجيا فعليًا؟
بينما تستخدم نماذج مثل BERT جزء الترميز (Encoder) من نموذج Transformer لفهم النصوص بشكل ثنائي الاتجاه، فإن GPT يعتمد على بنية فك الترميز فقط (Decoder-only) المصممة للتنبؤ بالتوكن التالي بشكل تكراري تلقائي (autoregressive). في هذه التدوينة، سنزيل الغموض عن كيفية عمل GPT Transformer، ونغوص عميقًا في آلية الانتباه الذاتي السببي (causal self-attention)، ونقوم بتنفيذها برمجياً.
GPT
Transformers
الذكاء الاصطناعي التوليدي
الانتباه السببي
معالجة اللغة الطبيعية